
360搜索引擎取真实地址-python代码
还是个比较简单的,不像百度有加密算法
分析
http://www.so.com/link?url=http%3A%2F%2Fedu.sd.chinamobile.com%2Findex%2Fnews.do%3Faction%3DnoticeDetail%26id%3D22452&q=inurl%3Anews.do&ts=1488978912&t=89c5361a44fe3f52931d25c6de262bb&src=haosou
网址是上面这个样子,没加密直接取就好了,去掉头http://www.so.com/link?url=和尾&q=一直到末尾的部分,剩下的就可以吃了
那么规则我们就可以写出来了
a['href'][a['href'].index('?url='):a['href'].index('&q=')][5:]
a['href']是待处理网址,a['href'].index('?url='):a['href'].index('&q=')的部分为?url=http%3A%2F%2Fedu.sd.chinamobile.com%2Findex%2Fnews.do%3Faction%3DnoticeDetail%26id%3D22452
最后还需要用unquote解码
- 在python3中是
urllib.parse.unquote - 在python2中是
urllib.unquote
code
import requests

from bs4 import BeautifulSoup

from urllib.parse import unquote

headers = {

    "User-Agent" : "Mozilla/5.0 (Windows NT 10.0; WOW64; rv:53.0) Gecko/20100101 Firefox/53.0"

}

#爬取360搜索引擎真实链接,第一个参数关键词str,第二个参数爬取页数int

def parse360(keyword, pagenum):

    keywordsBaseURL = 'https://www.so.com/s?q=' + str(keyword) + '&pn='

    pnum = 1

    while pnum <= int(pagenum):

        baseURL = keywordsBaseURL + str(pnum)

        try:

            request = requests.get(baseURL, headers=headers)

            soup = BeautifulSoup(request.text, "html.parser")

            urls = [unquote(a['href'][a['href'].index('?url='):a['href'].index('&q=')][5:]) for a in soup.select('li.res-list > h3 > a')]

            for url in urls:

                yield url

        except:

            yield None

        finally:

            pnum += 1
用法示例:
def main():

    for url in parse360("keyword",10):

        if url:

            print url

        else:

            continue

if __name__ == '__main__':

    main()
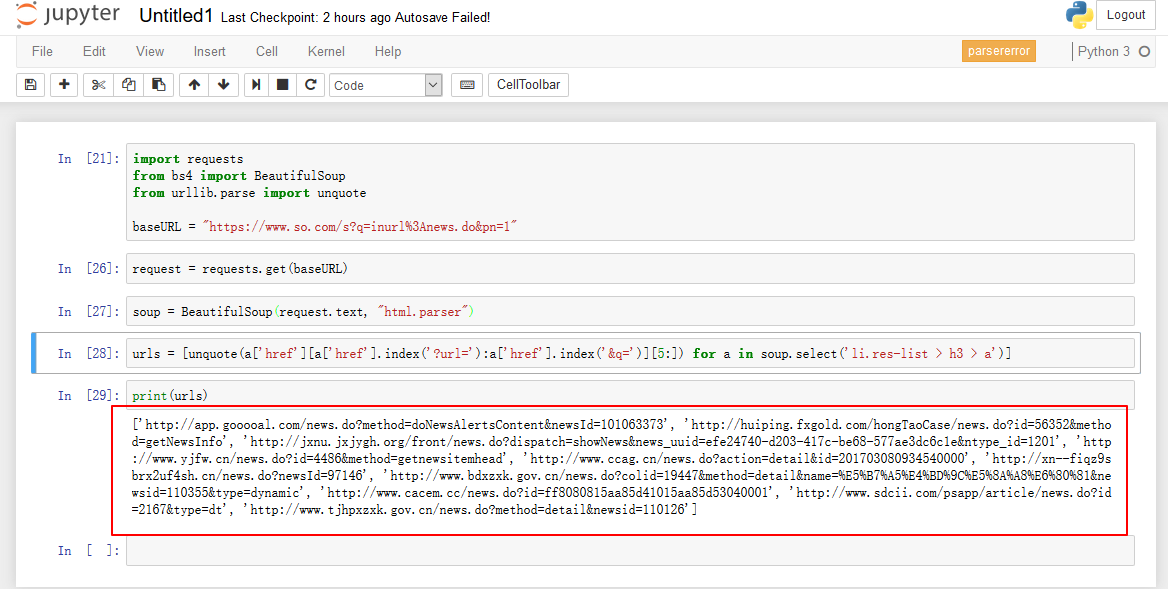
最后上一张测试图
转载请注明出处
360搜索引擎取真实地址-python代码的更多相关文章
- 百度搜索引擎取真实地址-python代码
代码 def parseBaidu(keyword, pagenum): keywordsBaseURL = 'https://www.baidu.com/s?wd=' + str(quote(key ...
- 抓取oschina上面的代码分享python块区下的 标题和对应URL
# -*- coding=utf-8 -*- import requests,re from lxml import etree import sys reload(sys) sys.setdefau ...
- C#取真实IP地址及分析
说一哈,我也是转来的,不是想骗PV,方便自己查而已! 目前网上流行的所谓"取真实IP地址"的方法,都有bug,没有考虑到多层透明代理的情况. 多数代码类似: string IpAd ...
- JSP 获取真实IP地址的代码
[转载]JSP 获取真实IP地址的代码 JSP 获取真实IP地址的代码 在JSP里,获取客户端的IP地址的方法是:request.getRemoteAddr(),这种方法在大部分情况下都是有效的. ...
- 【转载】JSP 获取真实IP地址的代码
JSP 获取真实IP地址的代码 在JSP里,获取客户端的IP地址的方法是:request.getRemoteAddr(),这种方法在大部分情况下都是有效的. 但是在通过了 Apache,Squid ...
- 20行Python代码爬取王者荣耀全英雄皮肤
引言王者荣耀大家都玩过吧,没玩过的也应该听说过,作为时下最火的手机MOBA游戏,咳咳,好像跑题了.我们今天的重点是爬取王者荣耀所有英雄的所有皮肤,而且仅仅使用20行Python代码即可完成. 准备工作 ...
- python爬取网页的通用代码框架
python爬取网页的通用代码框架: def getHTMLText(url):#参数code缺省值为‘utf-8’(编码方式) try: r=requests.get(url,timeout=30) ...
- Python动态网页爬虫-----动态网页真实地址破解原理
参考链接:Python动态网页爬虫-----动态网页真实地址破解原理
- python爬虫构建代理ip池抓取数据库的示例代码
爬虫的小伙伴,肯定经常遇到ip被封的情况,而现在网络上的代理ip免费的已经很难找了,那么现在就用python的requests库从爬取代理ip,创建一个ip代理池,以备使用. 本代码包括ip的爬取,检 ...
随机推荐
- IO model
上节的问题: 协程:遇到IO操作就切换. 但什么时候切回去呢?怎么确定IO操作完了? 很多程序员可能会考虑使用“线程池”或“连接池”.“线程池”旨在减少创建和销毁线程的频率,其维持一定合理数量的线程, ...
- Spark学习之路 (十七)Spark分区
一.分区的概念 分区是RDD内部并行计算的一个计算单元,RDD的数据集在逻辑上被划分为多个分片,每一个分片称为分区,分区的格式决定了并行计算的粒度,而每个分区的数值计算都是在一个任务中进行的,因此任务 ...
- python 测试文件或者文件目录是否存在 测试文件类型,获取文件大小,获取修改日期
----测试一个文件或目录是否存在 >>> import os >>> os.path.exists('/etc/passwd') True >>> ...
- Go语言专题
基础语法 Go语言配置开发环境 Go语言语法基础 Go语言面向对象 Go语言并发编程 Go语言搭建开发环境 语言库 Go语言fmt包 Go语言字节处理 Go语言字符串处理 Go语言JSON处理 Go语 ...
- sqoop使用经验总结及问题汇总
问题导读1.导入数据到HDFS,需要注意什么?2.在测试sqoop语句的时候,如何限制记录数量?3.sqoop导入时什么情况下会多导入一条数据? 一.sqoop 导入数据到HDFS注意事项 分割符的方 ...
- python递归的例子
例子1:递归实现嵌套列表求和 #encoding=utf-8 a=[[1,2,3], [4,5,6], [7,8,9]]def listsum(L): result=0 for i i ...
- 【Error】:svnrdump: E130003: The XML response contains invalid XML
我这边的使用场景是在对远程服务器进行svnrdump dump操作时出现该问题,因为是对远程仓库多级子目录进行备份,结果出现错误. 在网上搜索了很多,有很多帖子是在checkout的时候出现问题,和我 ...
- window下nodejs用nodemon启动koa2项目(用cmd启动不了,要用Git Bash Here 启动才可以)
window下nodejs用nodemon启动koa2项目(用cmd启动不了,要用Git Bash Here 启动才可以)nodemon --watch 'app/**/*' -e ts --exec ...
- v-show v-if 的使用
v-show:通过切换元素的display CSS属性实现显示隐藏: v-if:根据表达式的真假实现显示隐藏,如果隐藏,它绑定的元素都会销毁,显示的时候再重建: <div id="on ...
- 微信小程序细节
微信小程序开发几个细节: 1.界面传值 ①全局参数传值 <!--结果--> <view wx:for="{{data}}" class="case pr ...