
五.hadoop 从mysql中读取数据写到hdfs
目录:
本文是基于windows下来操作,linux下,mysql-connector-java-5.1.46.jar包的放置有讲究。
mr程序
import java.io.DataInput;

import java.io.DataOutput;

import java.io.IOException;

import java.sql.PreparedStatement;

import java.sql.ResultSet;

import java.sql.SQLException;

import java.util.Iterator;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.io.Writable;

import org.apache.hadoop.mapred.FileOutputFormat;

import org.apache.hadoop.mapred.JobClient;

import org.apache.hadoop.mapred.JobConf;

import org.apache.hadoop.mapred.MapReduceBase;

import org.apache.hadoop.mapred.Mapper;

import org.apache.hadoop.mapred.OutputCollector;

import org.apache.hadoop.mapred.Reducer;

import org.apache.hadoop.mapred.Reporter;

import org.apache.hadoop.mapred.lib.db.DBConfiguration;

import org.apache.hadoop.mapred.lib.db.DBInputFormat;

import org.apache.hadoop.mapred.lib.db.DBWritable;

/**

 * @author DELL_pc

 *  @date 2017年6月27日

 */

public class DbaMysql {

     public static class DBAccessMapper extends MapReduceBase    implements Mapper<LongWritable,StudentRecord , IntWritable, Text>

     {

        public void map(LongWritable key, StudentRecord value, OutputCollector<IntWritable, Text> output,

                Reporter reporter) throws IOException {

            // TODO Auto-generated method stub

            output.collect(new IntWritable(value.id), new Text(value.toString()));

        }

     }

      public static class DBAccessReduce extends MapReduceBase implements Reducer<IntWritable, Text, IntWritable, Text>

      {

        public void reduce(IntWritable key, Iterator<Text> values, OutputCollector<IntWritable, Text> output,

                Reporter reporter) throws IOException {

              while (values.hasNext()) {

                  output.collect(key, values.next());

                }

        }

      }

     public static void main(String[] args) {

         System.setProperty("hadoop.home.dir", "D:\\hadoop-2.7.6");//这一行一定要

        Configuration configuration=new Configuration();

        JobConf jobConf=new JobConf(configuration);

        jobConf.setOutputKeyClass(IntWritable.class);

        jobConf.setOutputValueClass(Text.class);

        jobConf.setInputFormat(DBInputFormat.class);

//        String[] fields={"id,name"};

//        DBInputFormat.setInput(jobConf, StudentRecord.class, "bbb", "length(name)>2", "",fields );//bbb是表名,读取方式1

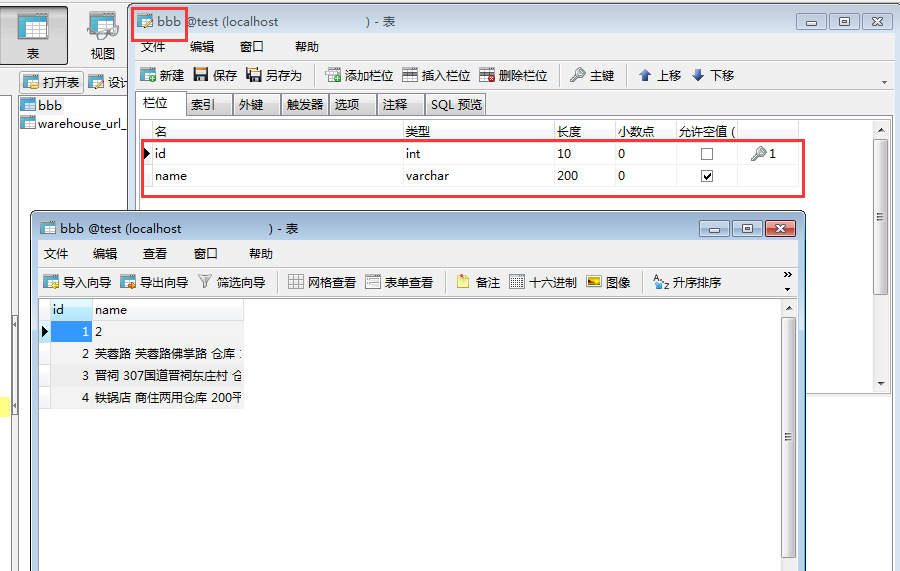
         DBInputFormat.setInput(jobConf, StudentRecord.class,"select id,name from bbb","select 3 from dual");//读取方式2

        DBConfiguration.configureDB(jobConf, "com.mysql.jdbc.Driver", "jdbc:mysql://localhost:3306/test","root","admin");

        jobConf.setMapperClass(DBAccessMapper.class);

        jobConf.setReducerClass(DBAccessReduce.class);

        FileOutputFormat.setOutputPath(jobConf,new Path("output_mysql"));

        try {

            JobClient.runJob(jobConf);

        } catch (IOException e) {

            // TODO Auto-generated catch block

            e.printStackTrace();

        }

    }

    public static class StudentRecord implements Writable, DBWritable {

        int id;

        String name;

        //构造方法

        public StudentRecord() { }

        //Writable接口是对数据流进行操作的,所以输入是DataInput类对象

        public void readFields(DataInput in) throws IOException {

            this.id = in.readInt(); //输入流中的读取下一个整数,并返回

            this.name = Text.readString(in);

        }

        public String toString() {

            return new String(this.id + " " + this.name);

        }

        //DBWritable负责对数据库进行操作,所以输出格式是PreparedStatement

        //PreparedStatement接口继承并扩展了Statement接口,用来执行动态的SQL语句,即包含参数的SQL语句

        public void write(PreparedStatement stmt) throws SQLException {

            stmt.setInt(, this.id);

            stmt.setString(, this.name);

        }

        //DBWritable负责对数据库进行操作,输入格式是ResultSet

        // ResultSet接口类似于一张数据表,用来暂时存放从数据库查询操作所获得的结果集

        public void readFields(ResultSet result) throws SQLException {

            this.id = result.getInt();

            this.name = result.getString();

        }

        //Writable接口是对数据流进行操作的,所以输出是DataOutput类对象

        public void write(DataOutput out) throws IOException {

            out.writeInt(this.id);

            Text.writeString(out, this.name);

        }

    }

}
pom.xml:
<dependencies>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-common</artifactId>

            <version>2.7.</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-mapreduce-client-core</artifactId>

            <version>2.7.</version>

        </dependency>

        <!-- https://mvnrepository.com/artifact/mysql/mysql-connector-java -->

        <dependency>

            <groupId>mysql</groupId>

            <artifactId>mysql-connector-java</artifactId>

            <version>5.1.</version>

        </dependency>

    </dependencies>
————————————————————————————————————————————
附录:
本程序在windows上成功后,把打好的jar包 mstest.jar(jar包内已包含mysql驱动类)丢linux的hadoop上跑,会报错,说
// :: WARN mapreduce.JobResourceUploader: No job jar file set.  User classes may not be found. See Job or Job#setJar(String).

// :: INFO mapreduce.JobSubmitter: Cleaning up the staging area file:/usr/software/hadoop/tmp/mapred/staging/root1889661768/.staging/job_local1889661768_0001

Exception in thread "main" java.lang.RuntimeException: java.lang.RuntimeException: java.lang.ClassNotFoundException: com.mysql.jdbc.Driver

    at org.apache.hadoop.mapreduce.lib.db.DBInputFormat.setConf(DBInputFormat.java:)

    at org.apache.hadoop.util.ReflectionUtils.setConf(ReflectionUtils.java:)

    at org.apache.hadoop.util.ReflectionUtils.newInstance(ReflectionUtils.java:)
既使手动丢个mysql-connector-java-5.1.46.jar到java_home下没用,丢hadoop_home下没用,
最终丢的目录:
[hadoop_home]/share/hadoop/yarn/
然后,mysql就能被hdfs用到了
参考:Sqoop安装与MapReduce读MySql写HDFS加载不了JDBC驱动问题
五.hadoop 从mysql中读取数据写到hdfs的更多相关文章
- Hadoop 从URL中读取数据
package com.hadoop; import java.io.IOException; import java.io.InputStream; import java.net.URL; imp ...
- 一步一步跟我学习hadoop(7)----hadoop连接mysql数据库运行数据读写数据库操作
为了方便 MapReduce 直接訪问关系型数据库(Mysql,Oracle).Hadoop提供了DBInputFormat和DBOutputFormat两个类.通过DBInputFormat ...
- Sqoop(三)将关系型数据库中的数据导入到HDFS(包括hive,hbase中)
一.说明: 将关系型数据库中的数据导入到 HDFS(包括 Hive, HBase) 中,如果导入的是 Hive,那么当 Hive 中没有对应表时,则自动创建. 二.操作 1.创建一张跟mysql中的i ...
- JDBC Java 程序从 MySQL 数据库中读取数据,并备份到 xml 文档中
MySQL 版本:Server version: 5.7.17-log MySQL Community Server (GPL) 相关内容:JDBC Java 程序从 MySQL 数据库中读取数据,并 ...
- hadoop项目实战--ETL--(二)实现自动向mysql中添加数据
四 项目开发 1 创建数据库db_etl,新建两张表user 和oder.表结构如第一部分图所示. 2 编写python脚本,实现自动向mysql中插入数据. 新建python 项目,目录结构如下图 ...
- PHP读取mysql中的数据
<!DOCTYPE HTML> <html> <head> <title> PHP动态读取mysql中的数据 </title> <me ...
- 修改MySQL中的数据
一:insert语句 1.介绍 在执行插入语句前,需要具有执行INSERT语句的INSERT权限. 2.准备环境 3.简单insert语句 4.插入多行 在这种形式中,每行的值列表用逗号分隔. 如果为 ...
- 一个I/O线程可以并发处理N个客户端连接和读写操作 I/O复用模型 基于Buf操作NIO可以读取任意位置的数据 Channel中读取数据到Buffer中或将数据 Buffer 中写入到 Channel 事件驱动消息通知观察者模式
Tomcat那些事儿 https://mp.weixin.qq.com/s?__biz=MzI3MTEwODc5Ng==&mid=2650860016&idx=2&sn=549 ...
- 利用Ajax实现数据的同步传输,从mysql中提取数据,通过echarts可视化
如何将mysql数据库中的方式通过echarts可视化呢,以下面这个简单的例子向大家进行演示: 步骤一:mysql的创表和插入数据,当然这些数据也可以是你通过爬虫抓取的. 步骤二: 创 ...
随机推荐
- python,os.path简单用法
#首先导入os包 import os#引入time模块是因为需要将浮点型的时间转为东八区时间 import time # basename(path),去掉路径名称,单独返回文件名 f = os.pa ...
- [转] 理解CheckPoint及其在Tensorflow & Keras & Pytorch中的使用
作者用游戏的暂停与继续聊明白了checkpoint的作用,在三种主流框架中演示实际使用场景,手动点赞. 转自:https://blog.floydhub.com/checkpointing-tutor ...
- [Kubernetes]CentOS7部署Kubernetes集群
环境介绍及安装前准备 三台机器,用于部署k8s的运行环境: 节点 ip Master 192.168.243.138 Node1 192.168.243.139 Node2 192.168.243.1 ...
- Pftriage:分析和追踪恶意文件,识别特征
项目地址 PFTriage:https://github.com/idiom/pftriage 参考 Pftriage:如何在恶意软件传播过程中对恶意文件进行分析 https://www.freebu ...
- Shell-find . -type f -name "*.php" -print0 | xargs -0 wc -l
统计一个源代码目录中所有 php 文件的行数
- React的Element的创建和render
React的Element是React应用程序的最小构建块,它是用来描述我们在屏幕上看到的浏览器页面上的内容. 在React中构建 Element 有两种方式: 1.JSX的方式,JSX不是React ...
- ethtool 解决网卡丢包严重和网卡原理【转】
转自:https://blog.csdn.net/u011857683/article/details/83758869 版权声明:本文为博主原创文章,未经博主允许不得转载. https://blog ...
- PEP 530 -- 异步推导式
PEP 530 -- 异步推导式 摘要 PEP 492和PEP 525使用async/await语法引入了协程.PEP 530建议添加list,set,dict推导式和生成器推导式的异步版本. 理论和 ...
- 题解-PKUWC2018 Slay the Spire
Problem loj2538 Solution 在考场上当然要学会写暴力,考虑如果手上已经有了\(a\)张攻击牌和\(b\)张强化牌: 首先强化牌会在攻击牌之前用(废话),其次要将两种牌分别从大往小 ...
- 洛谷:P3281 [SCOI2013]数数 (优秀的解法)
刷了这么久的数位 dp ,照样被这题虐,还从早上虐到晚上,对自己无语...(机房里又是只有我一个人,寂寞.) 题目:洛谷P3281 [SCOI2013]数数 题目描述 Fish 是一条生活在海里的鱼, ...