
python爬虫之scrapy模拟登录
背景:
初来乍到的pythoner,刚开始的时候觉得所有的网站无非就是分析HTML、json数据,但是忽略了很多的一个问题,有很多的网站为了反爬虫,除了需要高可用代理IP地址池外,还需要登录。例如知乎,很多信息都是需要登录以后才能爬取,但是频繁登录后就会出现验证码(有些网站直接就让你输入验证码),这就坑了,毕竟运维同学很辛苦,该反的还得反,那我们怎么办呢?这不说验证码的事儿,你可以自己手动输入验证,或者直接用云打码平台,这里我们介绍一个scrapy的登录用法。
测试登录地址:http://example.webscraping.com/places/default/user/login
测试主页:http://example.webscraping.com/user/profile
1、这里不在叙述如何创建scrapy项目和spider,可以看我前面的博客
2、快速登录方法。
我们在这里做了一个简单的介绍,我们都知道scrapy的基本请求流程是start_request方法遍历start_urls列表,然后make_requests_from_url方法,里面执行Request方法,请求start_urls里面的地址,但是这里我们用的不再是GET方法,而用的是POST方法,也就常说的登录。
1、首先我们改写start_reqeusts方法,直接GET登录页面的HTML信息(有些人说你不是POST登录么,干嘛还GET,别着急,你得先GET到登录页面的登录信息,才知道登录的账户、密码等怎么提交,往哪里提交)
2、start_request方法GET到数据后,用callback参数,执行拿到response后要接下来执行哪个方法,然后在login方法里面写入登录用户名和密码(还是老样子,一定要用dict),然后只用Request子类scrapy.FormRequest这个方法提交数据,这我一个的是FormRequest.from_response方m_法。
有些人会问,这个from__response的基本使用是条用是需要传入一个response对象作为第一个参数,这个方法会从页面中form表单中,帮助用户创建FormRequest对象,最最最最重要的是它会帮你把隐藏的input标签中的信息自动跳入表达,使用这个中方法,我们直接写用户名和密码即可,我们在最后面再介绍传统方法。
3、parse_login方法是提交完表单后callback回调函数指定要执行的方法,为了验证是否成功。这里我们直接在response中搜索Welcome Liu这个字眼就证明登录成功。这个好理解,重点是yield from super().start_resquests(),这个代表着如果一旦登录成功后,就直接带着登录成功后Cookie值,方法start_urls里面的地址。这样的话登录成功后的response可以直接在parse里面写。
 # -*- coding: utf-8 -*-

 import scrapy

 from scrapy import FormRequest,Request

 class ExampleLoginSpider(scrapy.Spider):

     name = "login_"

     allowed_domains = ["example.webscraping.com"]

     start_urls = ['http://example.webscraping.com/user/profile']

     login_url = 'http://example.webscraping.com/places/default/user/login'

     def parse(self, response):

         print(response.text)

     def start_requests(self):

         yield scrapy.Request(self.login_url,callback=self.login)

     def login(self,response):

         formdata = {

             'email':'liushuo@webscraping.com','password':''}

         yield FormRequest.from_response(response,formdata=formdata,

                                         callback=self.parse_login)

     def parse_login(self,response):

         # print('>>>>>>>>'+response.text)

         if 'Welcome Liu' in response.text:

             yield from super().start_requests()
有的同学可能问了,login方法里面不是应该写reture 么,其实上面的写法跟下面的这种写法是一样效果,如果再有个CSRF的话,也可以直接在login里面写拿到CSRF信息,写入到formdata里面跟用户名和密码一起提交。
return [FormRequest.from_response(response,formdata=formdata,callback=self.parse_login)]
登录成功

3、传统登录方法:
1、首先要明确一件事情,一般情况下需要登录的网站,不只需要登录用户和密码,接下来我们聊聊上面说的传统登录模式。用户在登录的时候并不是只需要登录账户信息,除了常见直观的验证码和CSRF信息外,也有可能需要提交其它信息,我们必须把它们都提取到一起提交给服务器。
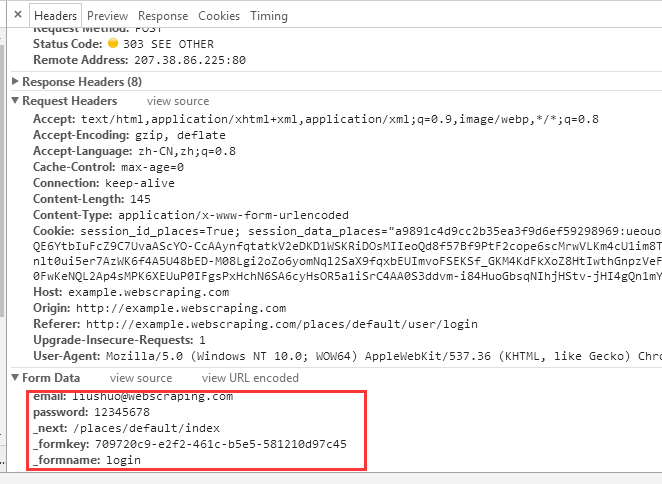
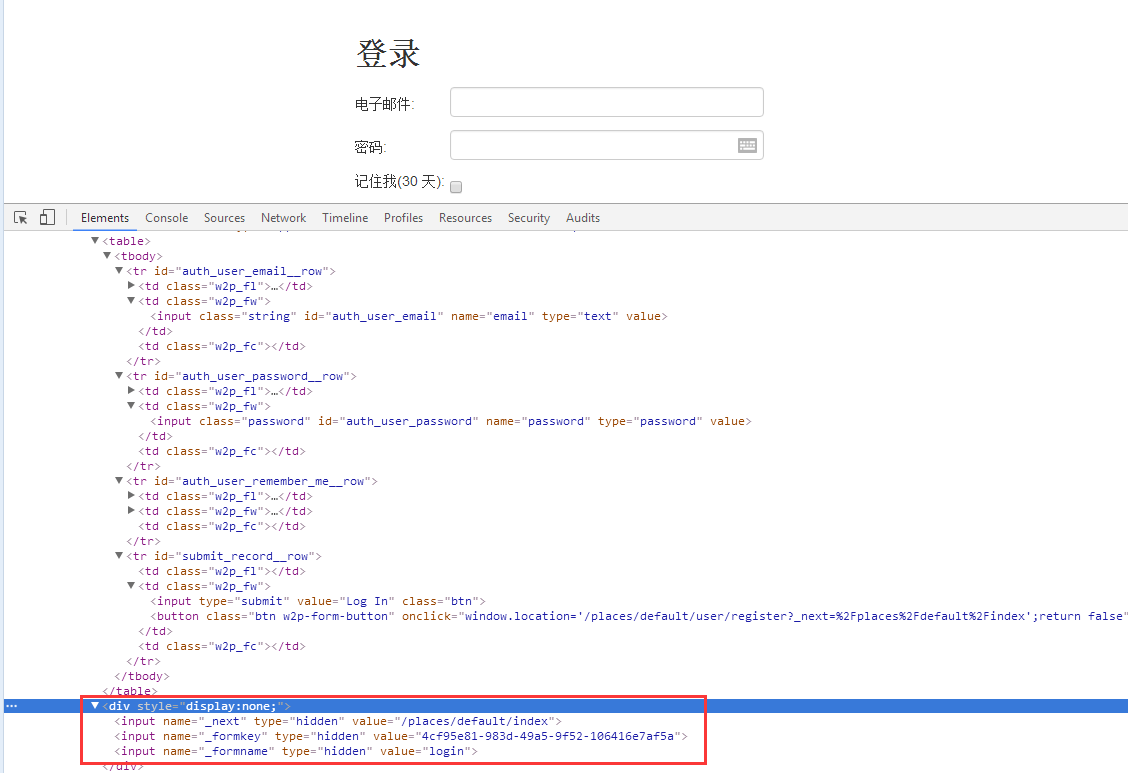
2、我们在form表单下面找到了一个display:none的div标签,里面的input标签的value值正好是我们要提交的数据,那我们就提取到他。
python爬虫之scrapy模拟登录的更多相关文章
- 《转载》python爬虫实践之模拟登录
有些网站设置了权限,只有在登录了之后才能爬取网站的内容,如何模拟登录,目前的方法主要是利用浏览器cookie模拟登录. 浏览器访问服务器的过程 在用户访问网页时,不论是通过URL输入域名或IP ...
- Python 爬虫实战5 模拟登录淘宝并获取所有订单
经过多次尝试,模拟登录淘宝终于成功了,实在是不容易,淘宝的登录加密和验证太复杂了,煞费苦心,在此写出来和大家一起分享,希望大家支持. 本篇内容 python模拟登录淘宝网页 获取登录用户的所有订单详情 ...
- scrapy模拟登录微博
http://blog.csdn.net/pipisorry/article/details/47008981 这篇文章是介绍使用scrapy模拟登录微博,并爬取微博相关内容.关于登录流程为嘛如此设置 ...
- 教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http://www.xiaohuar.com/,让你体验爬取校花的成就感. Scr ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Linux 安装python爬虫框架 scrapy
Linux 安装python爬虫框架 scrapy http://scrapy.org/ Scrapy是python最好用的一个爬虫框架.要求: python2.7.x. 1. Ubuntu14.04 ...
- Python爬虫框架Scrapy实例(三)数据存储到MongoDB
Python爬虫框架Scrapy实例(三)数据存储到MongoDB任务目标:爬取豆瓣电影top250,将数据存储到MongoDB中. items.py文件复制代码# -*- coding: utf-8 ...
- 《Python3网络爬虫开发实战》PDF+源代码+《精通Python爬虫框架Scrapy》中英文PDF源代码
下载:https://pan.baidu.com/s/1oejHek3Vmu0ZYvp4w9ZLsw <Python 3网络爬虫开发实战>中文PDF+源代码 下载:https://pan. ...
- Python爬虫框架Scrapy教程(1)—入门
最近实验室的项目中有一个需求是这样的,需要爬取若干个(数目不小)网站发布的文章元数据(标题.时间.正文等).问题是这些网站都很老旧和小众,当然也不可能遵守 Microdata 这类标准.这时候所有网页 ...
随机推荐
- python六十四课——高阶函数练习题(二)
总结:高阶函数以及匿名函数之间的配合使用 from functools import reduce #模块一:lambda和filter的结合使用 #lt = [1,2,3,4,5,6,7,8,9] ...
- SpringMVC handleMapping映射过程
初始化IOC容器 Spring初始化的时候会优先初始化自定义的类,下面这个就是 org.springframework.web.servlet.mvc.method.annotation.Reques ...
- 转://Oracle 高可用技术与云基础架构
众所周知Oracle云基础架构已经在越来越多的行业里应用.大家了解云基础架构是如何演进的嘛?可能有人会说Oracle高可用技术是组成云架构的基础,那它们的关系是怎么样的?大家又了解Oracle高可用技 ...
- rabbitmq的五种工作模式
abbitmq的五种工作模式
- 微服务框架surging学习之路——序列化 (转载https://www.cnblogs.com/alangur/p/10407727.html)
微服务框架surging学习之路——序列化 1.对微服务的理解 之前看到在群里的朋友门都在讨论微服务,看到他们的讨论,我也有了一些自己的理解,所谓微服务就是系统里的每个服务都 可以自由组合.自由组 ...
- 吴恩达课后作业学习2-week1-3梯度校验
参考:https://blog.csdn.net/u013733326/article/details/79847918 希望大家直接到上面的网址去查看代码,下面是本人的笔记 5.梯度校验 在我们执行 ...
- sqlplus编译失效对象
原文整理自:http://www.51testing.com/?uid-16403-action-viewspace-itemid-98161:http://www.eygle.com/archive ...
- 理解 vue-router的beforeEach无限循环的问题
在理解beforeEach无限循环之前,我们先来看一下beforeEach相关的知识点,该篇文章的项目是基于 express+vue+mongodb+session实现注册登录 这篇文章项目基础之上进 ...
- echart自定义浮窗 增加点击事件
一:情景 做一个柱状图,需要在柱状图显示lable,并且浮窗上每个条目可以被点击或者跳转. 我使用的做图插件是echarts,但是echart的浮窗是图片,而且不可以被点击,不能识别html,而且这个 ...
- 01-vue学习篇-以优雅的姿势创建vue项目
前言 小白一枚,今年(2019)准备学习一下前端的技术,因为发现自己对后端(python)相对比较熟悉但是还是写不出一个优雅的系统,可见前端的重要性,于是静下心来跟大佬学习.在不断的激励自己调整自己的 ...