
065 updateStateByKey的函数API
一:使用场景
1.应用场景
数据的累加
一段时间内的数据的累加
2.说明
每个批次都输出自己批次的数据,
这个时候,可以使用这个API,使得他们之间产生联系。
3.说明2
在累加器的时候,起到的效果和这里的说明想法有些相同,都可以输出上一个批次的信息
二:程序
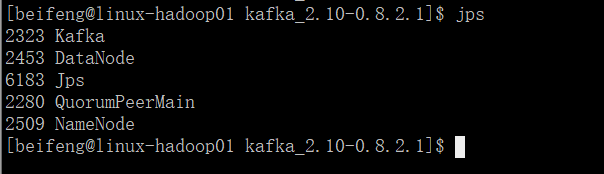
1.需要启动一些服务
需要使用hadoop
2.程序
 package com.stream.it

 import kafka.serializer.StringDecoder

 import org.apache.spark.rdd.RDD

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.kafka.KafkaUtils

 import org.apache.spark.streaming.{Seconds, StreamingContext}

 import org.apache.spark.{HashPartitioner, SparkConf, SparkContext}

 object UpdateStateByKeyKafkaWordcount {

   def main(args: Array[String]): Unit = {

     val conf=new SparkConf()

         .setAppName("spark-streaming-wordcount")

           .setMaster("local[*]")

     val sc=SparkContext.getOrCreate(conf)

     val ssc=new StreamingContext(sc,Seconds(15))

     val kafkaParams=Map("group.id"->"stream-sparking-0",

           "zookeeper.connect"->"linux-hadoop01.ibeifeng.com:2181/kafka",

           "auto.offset.reset"->"smallest"

     )

     val topics=Map("beifeng"->1)

     val dStream=KafkaUtils.createStream[String,String,StringDecoder,StringDecoder](

       ssc,             //给定sparkStreaming的上下文

       kafkaParams,     //kafka的参数信息,通过kafka HightLevelComsumerApi连接

       topics,          //给定读取对应的topic的名称以及读取数据的线程数量

       StorageLevel.MEMORY_AND_DISK_2     //数据接收器接收到kafka的数据后的保存级别

     ).map(_._2)

     // 当调用updateStateByKey函数API的时候,必须给定checkpoint dir

     // 路径对应的文件夹不能存在

     ssc.checkpoint("hdfs://linux-hadoop01.ibeifeng.com:8020/beifeng/spark/streaming/chkdir01")

     /**

       def updateStateByKey[S: ClassTag](

         updateFunc: (Seq[V], Option[S]) => Option[S],

         partitioner: Partitioner,

         initialRDD: RDD[(K, S)]

       ): DStream[(K, S)]

       */

     val resultWordcount=dStream

       .filter(line=>line.nonEmpty)

         .flatMap(line=>line.split(" ").map((_,1)))

         .reduceByKey(_+_)

         .updateStateByKey(

           (values: Seq[Int], state: Option[Long]) => {

             // 从value中获取累加值

             val sum = values.sum

             // 获取以前的累加值

             val oldStateSum = state.getOrElse(0L)

             // 更新状态值并返回

             Some(oldStateSum + sum)

           }

       )

     resultWordcount.foreachRDD(rdd=>{

       rdd.foreachPartition(iter=>iter.foreach(println))

     })

     //启动

     ssc.start()

     //等到

     ssc.awaitTermination()

   }

 }
三:updateStateByKey的优化
1.说明
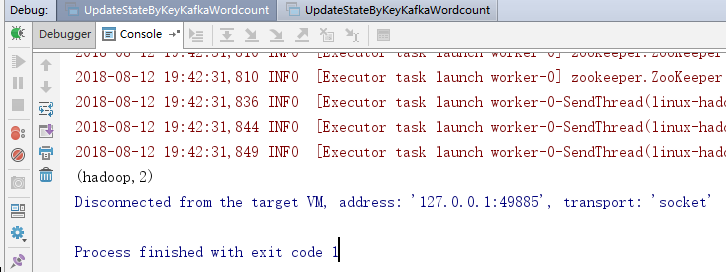
主要的情况是,程序停止,刚刚累加的数据不再存在。
重启后效果如下:
只剩下,已经被checkPoint的数据,后面的数据不再存在。
2.优化的程序
多加两个参数。
 package com.stream.it

 import kafka.serializer.StringDecoder

 import org.apache.spark.rdd.RDD

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.kafka.KafkaUtils

 import org.apache.spark.streaming.{Seconds, StreamingContext}

 import org.apache.spark.{HashPartitioner, SparkConf, SparkContext}

 object UpdateStateByKeyKafkaWordcount {

   def main(args: Array[String]): Unit = {

     val conf=new SparkConf()

         .setAppName("spark-streaming-wordcount")

           .setMaster("local[*]")

     val sc=SparkContext.getOrCreate(conf)

     val ssc=new StreamingContext(sc,Seconds(15))

     val kafkaParams=Map("group.id"->"stream-sparking-0",

           "zookeeper.connect"->"linux-hadoop01.ibeifeng.com:2181/kafka",

           "auto.offset.reset"->"largest"

     )

     val topics=Map("beifeng"->1)

     val dStream=KafkaUtils.createStream[String,String,StringDecoder,StringDecoder](

       ssc,             //给定sparkStreaming的上下文

       kafkaParams,     //kafka的参数信息,通过kafka HightLevelComsumerApi连接

       topics,          //给定读取对应的topic的名称以及读取数据的线程数量

       StorageLevel.MEMORY_AND_DISK_2     //数据接收器接收到kafka的数据后的保存级别

     ).map(_._2)

     // 当调用updateStateByKey函数API的时候,必须给定checkpoint dir

     // 路径对应的文件夹不能存在

     ssc.checkpoint("hdfs://linux-hadoop01.ibeifeng.com:8020/beifeng/spark/streaming/chkdir01")

     // 初始化updateStateByKey用到的状态值

     // 从保存状态值的地方(HBase)读取状态值, 这里采用模拟的方式

     val initialRDD: RDD[(String, Long)] = sc.parallelize(

       Array(

         ("hadoop", 100L),

         ("spark", 25L)

       )

     )

     /**

       def updateStateByKey[S: ClassTag](

         updateFunc: (Seq[V], Option[S]) => Option[S],

         partitioner: Partitioner,

         initialRDD: RDD[(K, S)]

       ): DStream[(K, S)]

       */

     val resultWordcount=dStream

       .filter(line=>line.nonEmpty)

         .flatMap(line=>line.split(" ").map((_,1)))

         .reduceByKey(_+_)

         .updateStateByKey(

           (values: Seq[Int], state: Option[Long]) => {

             // 从value中获取累加值

             val sum = values.sum

             // 获取以前的累加值

             val oldStateSum = state.getOrElse(0L)

             // 更新状态值并返回

             Some(oldStateSum + sum)

           },

           new HashPartitioner(ssc.sparkContext.defaultParallelism), // 分区器

           initialRDD // 初始化状态值

       )

     resultWordcount.foreachRDD(rdd=>{

       rdd.foreachPartition(iter=>iter.foreach(println))

     })

     //启动

     ssc.start()

     //等到

     ssc.awaitTermination()

   }

 }
3.运行效果

4.注意点
需要有checkPoint的路径。
累加值存在硬盘中,长时间不访问会被删除。
065 updateStateByKey的函数API的更多相关文章
- HTML5 Audio标签方法和函数API介绍
问说网 > 文章教程 > 网页制作 > HTML5 Audio标签方法和函数API介绍 Audio APIHTML5HTML5 Audio预加载 HTML5 Audio标签方法和函数 ...
- MySQL Crash Course #05# Chapter 9. 10. 11. 12 正则.函数. API
索引 正则表达式:MySQL only supports a small subset of what is supported in most regular expression implemen ...
- Unix/Linux系统时间函数API
首先说明关于几个时间的概念: 世界时:起初,国际上的标准时间是格林尼治标准时间,以太阳横穿本初子午线的时刻为标准时间正午12点.它根据天文环境来定义,就像古代人们根据日晷来计时一样,如下图: 原子时: ...
- Atitit.跨平台预定义函数 魔术方法 魔术函数 钩子函数 api兼容性草案 v2 q216 java c# php js.docx
Atitit.跨平台预定义函数 魔术方法 魔术函数 钩子函数 api兼容性草案 v2 q216 java c# php js.docx 1.1. 预定义函数 魔术方法 魔术函数是什么1 1.2. & ...
- kotlin函数api
原 Kotlin学习(4)Lambda 2017年09月26日 21:00:03 gwt0425 阅读数:551 记住Lambda的本质,还是一个对象.和JS,Python等不同的是,Kotlin ...
- jQuery函数API,各版本新特性汇总
jQuery API 速查表 选择器 基本 #id element .class * selector1,selector2,selectorN 层级 ancestor descendant pare ...
- Azure 静态 web 应用集成 Azure 函数 API
前几次我们演示了如果通过Azure静态web应用功能发布vue跟blazor的项目.但是一个真正的web应用,总是免不了需要后台api服务为前端提供数据或者处理数据的能力.同样前面我们也介绍了Azur ...
- cocosCreator 新版本的动作函数API的应用
利用触摸位置判断,点击的是屏幕的左侧还是右侧,控制主角左右移动: 见代码: InputControl:function () { var self=this; //cc.systemEvent sel ...
- 【原创】自己动手写的一个查看函数API地址的小工具
C开源代码如下: #include <stdio.h> #include <windows.h> #include <winbase.h> typedef void ...
随机推荐
- atop工具检测linux硬件异常
引言 Linux以其稳定性,越来越多地被用作服务器的操作系统(当然,有人会较真地说一句:Linux只是操作系统内核:).但使用了Linux作为底层的操作系统,是否我们就能保证我们的服务做到7*24地稳 ...
- GIT 版本管理-github&码云
GIT 是什么 git是一个用于帮助用户实现版本控制的软件. 把本地代码push到远程服务器 git add.git commitpush code to remove machine.git pus ...
- [maven] dependency标签理解
在maven pom.xml文件中最多的就是dependency标签,我们用maven管理我们项目的依赖.这篇文章简单介绍dependency标签内部各个子标签的意义. 下面是dependency标签 ...
- 树·二叉查找树ADT(二叉搜索树/排序树)
1.定义 对于每个节点X,它的左子树中所有的项的值小于X的值,右子树所有项的值大于X的值. 如图:任意一个节点,都满足定义,其左子树的所有值小于它,右子树的所有值大于它. 2.平均深度 在大O模型中, ...
- swift 学习- 11 -- 属性
// '属性'将值跟特定的类, 结构体或枚举关联, 存储属性常量或变量作为实例的一部分,而计算属性计算(不是存储) 一个值, 计算属性可以用于 类, 结构体, 枚举, 存储属性只能用于 类 和 结构体 ...
- java 中int与integer的区别
int与integer的区别从大的方面来说就是基本数据类型与其包装类的区别: int 是基本类型,直接存数值,而integer是对象,用一个引用指向这个对象 1.Java 中的数据类型分为基本数据类型 ...
- C# 通用数据库配置界面,微软原生DLL重整合
C# 通用数据库配置界面,微软原生DLL重整合 自己整合了 微软自带的数据连接配置界面对话库 Microsoft.Data.ConnectionUI.Dialog.dll 微软自带的数据连接配 ...
- Confluence 6 白名单允许进入和禁用
允许进入 启用 CORS 请求,将会从特定的 URL 来源中允许进入(Allow Incoming).URL 格式必须匹配格式 scheme://host[:port],结尾是没有反斜杠的(:port ...
- Confluence 6 PostgreSQL 测试你的数据库连接
在你的数据库设置界面,有一个 测试连接(Test connection)按钮可以检查: Confluence 可以连接你的数据库服务器 数据库字符集的编码是否设置正确 你的数据库用户是否有正确的权限可 ...
- Confluence 6 导入模板的定义
模板是一个预先定义的页面,这个预先定义的页面可以在创建新页面的时候预先载入.模板能够给一个页面统一的样式或格式. 你可以在 Confluence 中创建你自己的模板,请查看页面 Create a Te ...