
Entropy Search for Information-Efficient Global Optimization
@article{hennig2012entropy,
title={Entropy search for information-efficient global optimization},
author={Hennig, Philipp and Schuler, Christian J},
journal={Journal of Machine Learning Research},
volume={13},
number={1},
pages={1809--1837},
year={2012}}
概
贝叶斯优化中的 Entropy Search (EI) 方法.
主要内容
这篇文章关注的是
\]
的问题, 且假设定义域\(I\)是有界的.
一般, 通过高斯过程定义\(f(x)\)的概率替代函数, 假设
y = f(x) + \epsilon, \: \epsilon \sim \mathcal{N}(0, \sigma^2).
\]
在已经观测到\(X = \{x_1, \ldots, x_T\}\)以及\(Y = \{y_1, \ldots, y_T\}\)的基础上, 我们可以求得\(f(x^*)\)的后验分布为以
\sigma_*^2(x^*)=k(x^*, x^*) - k(x^*, X)^T (k(X,X)+\sigma I)^{-1}k(x^*,X)
\]
为均值和方差的正态分布.
我们的目的是在已有这些条件的基础上, 寻找下一个(或多个)评估点.
定义:
p_{min}(x) =p[x = \arg \min f(x)] = \int_{ f:I \rightarrow R} p(f) \prod_{\tilde{x} \in I, \tilde{x} \not = x} \theta[f(\tilde{x})-f(x)] \mathrm{d}f,
\]
其中\(\theta(x) = 1, x\ge0, else \: 0\). \(\prod\)的部分在针对连续型的定义域时需要特别的定义. 显然(1)表示\(x\)为最小值点的概率.
再定义损失函数(当然损失函数不选择KL散度也是可以的, 但这是EI的名字的由来):
\mathcal{L}(p_{min}) = \mathcal{L}_{KL}(p_{min})=-\int_Ip_{min}(x) \log \frac{p_{min}(x)}{b(x)} \mathrm{d}x.
\]
当我们选择\(b(x)\)为\(I\)上的均匀分布的时候, 当我们最小化\(\mathcal{L}\)的时候, \(p_{min}\)会趋向Dirac分布(即某个点处的概率密度为无穷, 其余为0, 显然, 该点我们有足够的信心认为其是\(f(x)\)的最小值点).
但是这样还不够, 我们进一步关心其期望损失(最小化):
\langle \mathcal{L} \rangle_{x} = \int p(y|x) \mathcal{L}(p_{min} (\cdot|Y, X, y, x)) \mathrm{d}y.
\]
通过最小化(3),我们可以获得接下来的评估点.
接下来的问题是如果去估计.
\(p_{min}\)的估计
比较麻烦的是\(\prod\)的部分, 策略是挑选\(N\)个点\(\tilde{x} = \{\tilde{x}_1, \ldots, \tilde{x}_N\}\). 一种是简单粗暴的网格的方式, 但是这种方式往往需要较大的\(N\), 另一种是给定一个测度\(u\), 根据已有的观察\((X, Y)\), 通过\(u(X, Y)\)采样\(\tilde{x}\). 一个好的\(u\)应该在使得令损失能够产生较大变化的区域多采样点, 针对本文的情况 应该在\(p_{min}\)值比较高的地方多采样点.
文中给了俩种方法, 一种直接的方法是\(p_{min}\)可以用蒙特卡洛积分去逼近,
一下是我猜想的用MC积分的方式(文中未给出具体的形式)"
- 根据一定策略选取\(\tilde{x}\);
- 重复J次:
- 根据概率\(p(f)\)采样\(f(\tilde{x}), f(x)\),
- 计算\(\prod\)部分
- 取平均
作者选择的是 Expectation Propagation (EP)的方法, 这种方法能够估计出\(\tilde{x}_i, i=1,\ldots,N\)处的概率\(q_{min}(\tilde{x_i})\): \(f_{min}\)存在于以\(\tilde{x}_i\)为"中心"的一定范围内(文中用step)的概率. 当\(N\)足够的的时候, 这个step正比于\((Nu(\tilde{x}_i))^{-1}\), 则:
\]
这样我们就完成了\(p_{min}\)的估计, 一个更加好的性质是\(q_{min}\)关于\(\mu, \sigma_*\)的导数是有解析表达式的, 且\(Z_u\)是不必计算的(后续最小化过程中可以省略掉).
\(\mathcal{L}_{KL}\)的估计
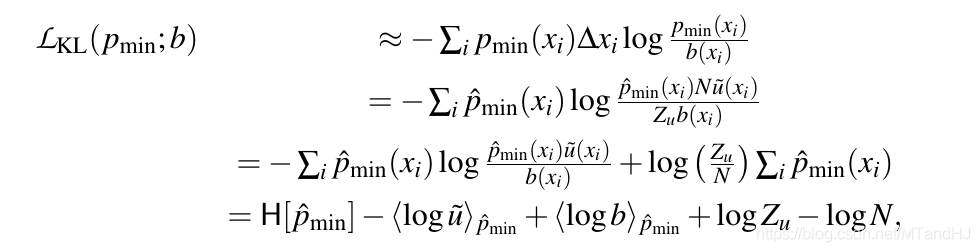
其中\(\hat{p}_{min}=q_{min}\).
\(\langle \Delta \mathcal{L} \rangle\)
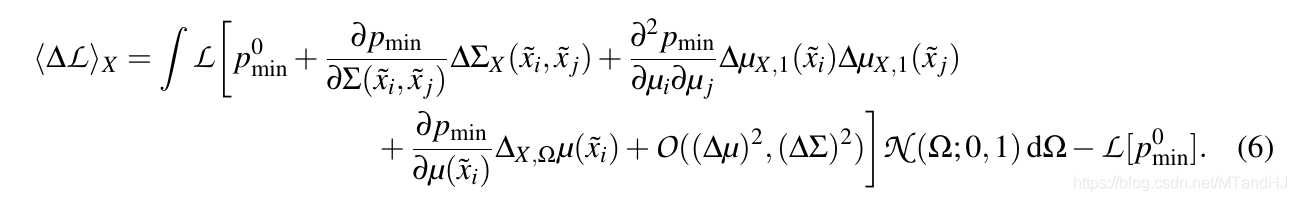
\(\arg \min_X \langle \mathcal{L} \rangle_X\) 用最小化一阶近似替代, 积分可以用MC积分逼近.
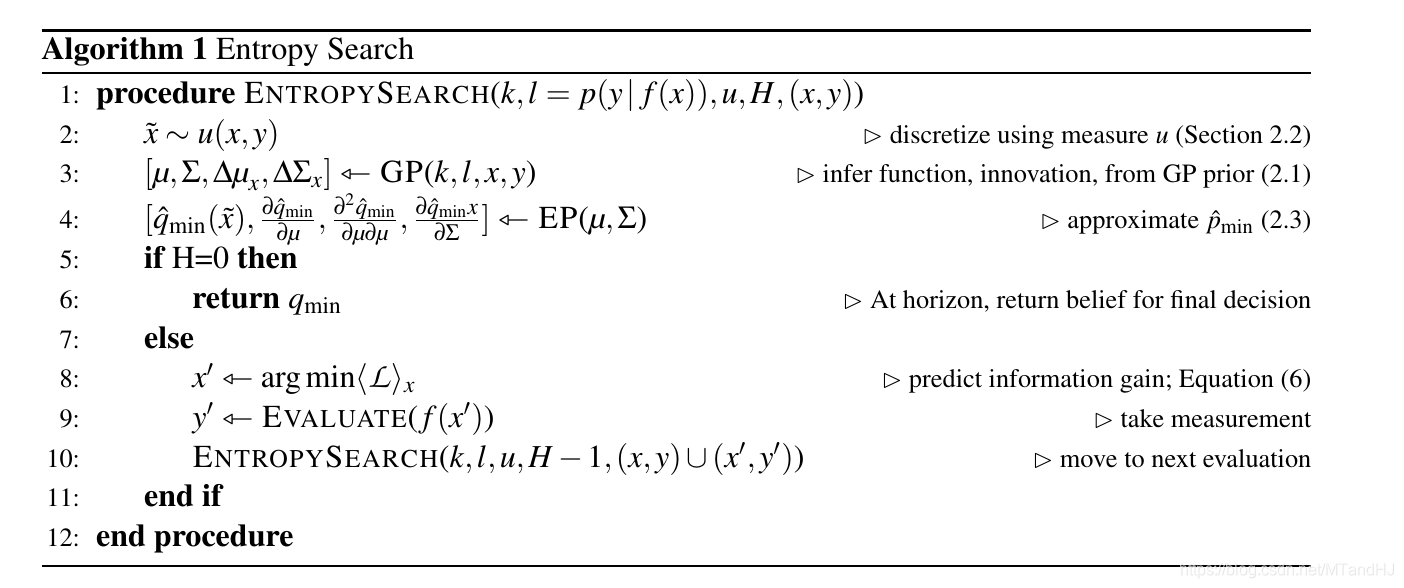
最后给出算法:
Entropy Search for Information-Efficient Global Optimization的更多相关文章
- 论文阅读 <Relocalization, Global Optimization and Map Merging for Monocular Visual-Inertial SLAM>
看了一下港科的基于vins拓展的论文<relocalization, global optimization and merging for vins>,在回环的实现部分总体没有什么变化, ...
- Entropy, relative entropy and mutual information
目录 Entropy Joint Entropy Conditional Entropy Chain rule Mutual Information Relative Entropy Chain Ru ...
- 论文笔记系列-Simple And Efficient Architecture Search For Neural Networks
摘要 本文提出了一种新方法,可以基于简单的爬山过程自动搜索性能良好的CNN架构,该算法运算符应用网络态射,然后通过余弦退火进行短期优化运行. 令人惊讶的是,这种简单的方法产生了有竞争力的结果,尽管只需 ...
- Community Cloud零基础学习(二)信誉等级设置 & Global Search设定
当我们创建了Community以后,我们需要对他进行定制页面来使community用户更好的使用.此篇主要描述两点,信誉等级设定以及Global Search 设定.其他的内容后期再慢慢描述. 一. ...
- Research Guide for Neural Architecture Search
Research Guide for Neural Architecture Search 2019-09-19 09:29:04 This blog is from: https://heartbe ...
- state-of-the-art implementations related to visual recognition and search
http://rogerioferis.com/VisualRecognitionAndSearch2014/Resources.html Source Code Non-exhaustive lis ...
- First release of mlrMBO - the toolbox for (Bayesian) Black-Box Optimization
We are happy to finally announce the first release of mlrMBO on cran after a quite long development ...
- 贝叶斯优化(Bayesian Optimization)深入理解
目前在研究Automated Machine Learning,其中有一个子领域是实现网络超参数自动化搜索,而常见的搜索方法有Grid Search.Random Search以及贝叶斯优化搜索.前两 ...
- Information retrieval信息检索
https://en.wikipedia.org/wiki/Information_retrieval 信息检索 (一种信息技术) 信息检索(Information Retrieval)是指信息按一定 ...
随机推荐
- Git(一)【基本使用,集成IDEA,GitHub】
目录 一.本地库操作 ①基本操作 1.初始化本地库 2.设置用户签名|用户名|邮箱 3.查看本地库状态 4.添加暂存区 5.提交到本地库 6.查看文件modify详情 ②历史版本以及回退 1.查看历史 ...
- 零基础学习java------32---------css,javascript,jQuery
一. CSS简单了解 需要掌握: 概念见day11中的课堂笔记 css:修饰html标签的样式 1.每个元素有一个style属性,其形式为:style="属性:值:属性:值...." ...
- MySQL 迁移到 Redis 记
前些日子,一个悠闲又不悠闲的下午,我还在用 Node.js 写着某个移动互联网应用的 API 服务端.那时还是用 MySQL 作为数据库,一切都很好,所有功能正常运行.可是有很多问题让人不安: 频繁的 ...
- Android,iOS系统有什么区别
两者运行机制不同:IOS采用的是沙盒运行机制,安卓采用的是虚拟机运行机制.Android是一种基于Linux的自由及开源的操作系统,iOS是由苹果公司开发的移动操作系统IOS中用于UI指令权限最高,安 ...
- this指针的用法和基本分析
当在不同的对象中采用this指针,就已经是在给它赋值了.对象各自的this指针指向各自对象的首地址,所以不同对象的this指针一定指向不同的内存地址. this 指针是由系统自动提供的指向对象的特殊指 ...
- 创建线程的第二种方式------实现Runnable接口的方式
package cn.itcast.demo16.Demo07.Runnable;/** * @author newcityman * @date 2019/7/22 - 23:17 */public ...
- Springboot集成velocity
1.加入maven包 <parent> <groupId>org.springframework.boot</groupId> <artifactId> ...
- 【Java】基本语法学习笔记
1.数组 *数组的创建 int[] array = {1,2,3,4,5}; 注意区别于C++ int a[] = (1)两种输出方法 public class number { public sta ...
- 安全刻不容缓「GitHub 热点速览 v.21.50」
作者:HelloGitHub-小鱼干 本周最热的事件莫过于 Log4j 漏洞,攻击者仅需向目标输入一段代码,不需要用户执行任何多余操作即可触发该漏洞,使攻击者可以远程控制用户受害者服务器,90% 以上 ...
- Redis学习推荐资料合集
目录 一.官方 二.书籍 三.推荐博客 一.官方 redis官网 redis中文网 redis中文命令网 redis模块 redis-github源码 redis报告 二.书籍 <Redis开发 ...