
Kafka日志存储原理
引言
Kafka中的Message是以topic为基本单位组织的,不同的topic之间是相互独立的。每个topic又可以分成几个不同的partition(每个topic有几个partition是在创建topic时指定的),每个partition存储一部分Message。借用官方的一张图,可以直观地看到topic和partition的关系。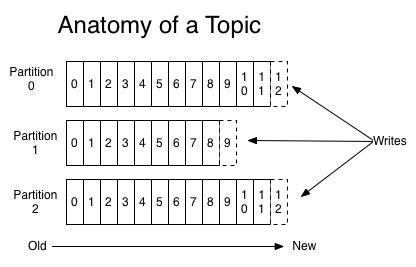
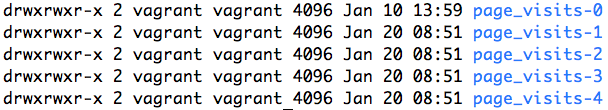
partition是以文件的形式存储在文件系统中,比如,创建了一个名为page_visits的topic,其有5个partition,那么在Kafka的数据目录中(由配置文件中的log.dirs指定的)中就有这样5个目录: page_visits-0, page_visits-1,page_visits-2,page_visits-3,page_visits-4,其命名规则为<topic_name>-<partition_id>,里面存储的分别就是这5个partition的数据。
接下来,本文将分析partition目录中的文件的存储格式和相关的代码所在的位置。
Partition的数据文件
Partition中的每条Message由offset来表示它在这个partition中的偏移量,这个offset不是该Message在partition数据文件中的实际存储位置,而是逻辑上一个值,它唯一确定了partition中的一条Message。因此,可以认为offset是partition中Message的id。partition中的每条Message包含了以下三个属性:
- offset
- MessageSize
- data
其中offset为long型,MessageSize为int32,表示data有多大,data为message的具体内容。它的格式和Kafka通讯协议中介绍的MessageSet格式是一致。
Partition的数据文件则包含了若干条上述格式的Message,按offset由小到大排列在一起。它的实现类为FileMessageSet,类图如下:
它的主要方法如下:
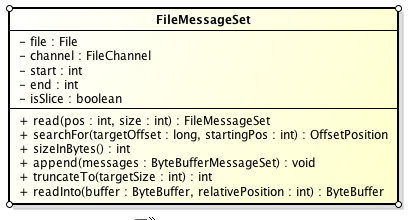
- append: 把给定的ByteBufferMessageSet中的Message写入到这个数据文件中。
- searchFor: 从指定的startingPosition开始搜索找到第一个Message其offset是大于或者等于指定的offset,并返回其在文件中的位置Position。它的实现方式是从startingPosition开始读取12个字节,分别是当前MessageSet的offset和size。如果当前offset小于指定的offset,那么将position向后移动LogOverHead+MessageSize(其中LogOverHead为offset+messagesize,为12个字节)。
- read:准确名字应该是slice,它截取其中一部分返回一个新的FileMessageSet。它不保证截取的位置数据的完整性。
- sizeInBytes: 表示这个FileMessageSet占有了多少字节的空间。
- truncateTo: 把这个文件截断,这个方法不保证截断位置的Message的完整性。
- readInto: 从指定的相对位置开始把文件的内容读取到对应的ByteBuffer中。
我们来思考一下,如果一个partition只有一个数据文件会怎么样?
- 新数据是添加在文件末尾(调用FileMessageSet的append方法),不论文件数据文件有多大,这个操作永远都是O(1)的。
- 查找某个offset的Message(调用FileMessageSet的searchFor方法)是顺序查找的。因此,如果数据文件很大的话,查找的效率就低。
那Kafka是如何解决查找效率的的问题呢?有两大法宝:1) 分段 2) 索引。
数据文件的分段
Kafka解决查询效率的手段之一是将数据文件分段,比如有100条Message,它们的offset是从0到99。假设将数据文件分成5段,第一段为0-19,第二段为20-39,以此类推,每段放在一个单独的数据文件里面,数据文件以该段中最小的offset命名。这样在查找指定offset的Message的时候,用二分查找就可以定位到该Message在哪个段中。
为数据文件建索引
数据文件分段使得可以在一个较小的数据文件中查找对应offset的Message了,但是这依然需要顺序扫描才能找到对应offset的Message。为了进一步提高查找的效率,Kafka为每个分段后的数据文件建立了索引文件,文件名与数据文件的名字是一样的,只是文件扩展名为.index。
索引文件中包含若干个索引条目,每个条目表示数据文件中一条Message的索引。索引包含两个部分(均为4个字节的数字),分别为相对offset和position。
- 相对offset:因为数据文件分段以后,每个数据文件的起始offset不为0,相对offset表示这条Message相对于其所属数据文件中最小的offset的大小。举例,分段后的一个数据文件的offset是从20开始,那么offset为25的Message在index文件中的相对offset就是25-20 = 5。存储相对offset可以减小索引文件占用的空间。
- position,表示该条Message在数据文件中的绝对位置。只要打开文件并移动文件指针到这个position就可以读取对应的Message了。
index文件中并没有为数据文件中的每条Message建立索引,而是采用了稀疏存储的方式,每隔一定字节的数据建立一条索引。这样避免了索引文件占用过多的空间,从而可以将索引文件保留在内存中。但缺点是没有建立索引的Message也不能一次定位到其在数据文件的位置,从而需要做一次顺序扫描,但是这次顺序扫描的范围就很小了。
在Kafka中,索引文件的实现类为OffsetIndex,它的类图如下:
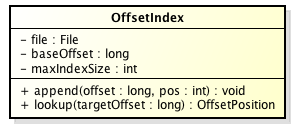
主要的方法有:
- append方法,添加一对offset和position到index文件中,这里的offset将会被转成相对的offset。
- lookup, 用二分查找的方式去查找小于或等于给定offset的最大的那个offset
小结
我们以几张图来总结一下Message是如何在Kafka中存储的,以及如何查找指定offset的Message的。
Message是按照topic来组织,每个topic可以分成多个的partition,比如:有5个partition的名为为page_visits的topic的目录结构为:
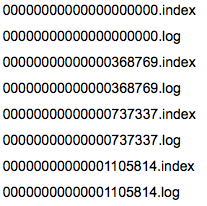
partition是分段的,每个段叫LogSegment,包括了一个数据文件和一个索引文件,下图是某个partition目录下的文件:
可以看到,这个partition有4个LogSegment。
查找Message原理图:
比如:要查找绝对offset为7的Message:
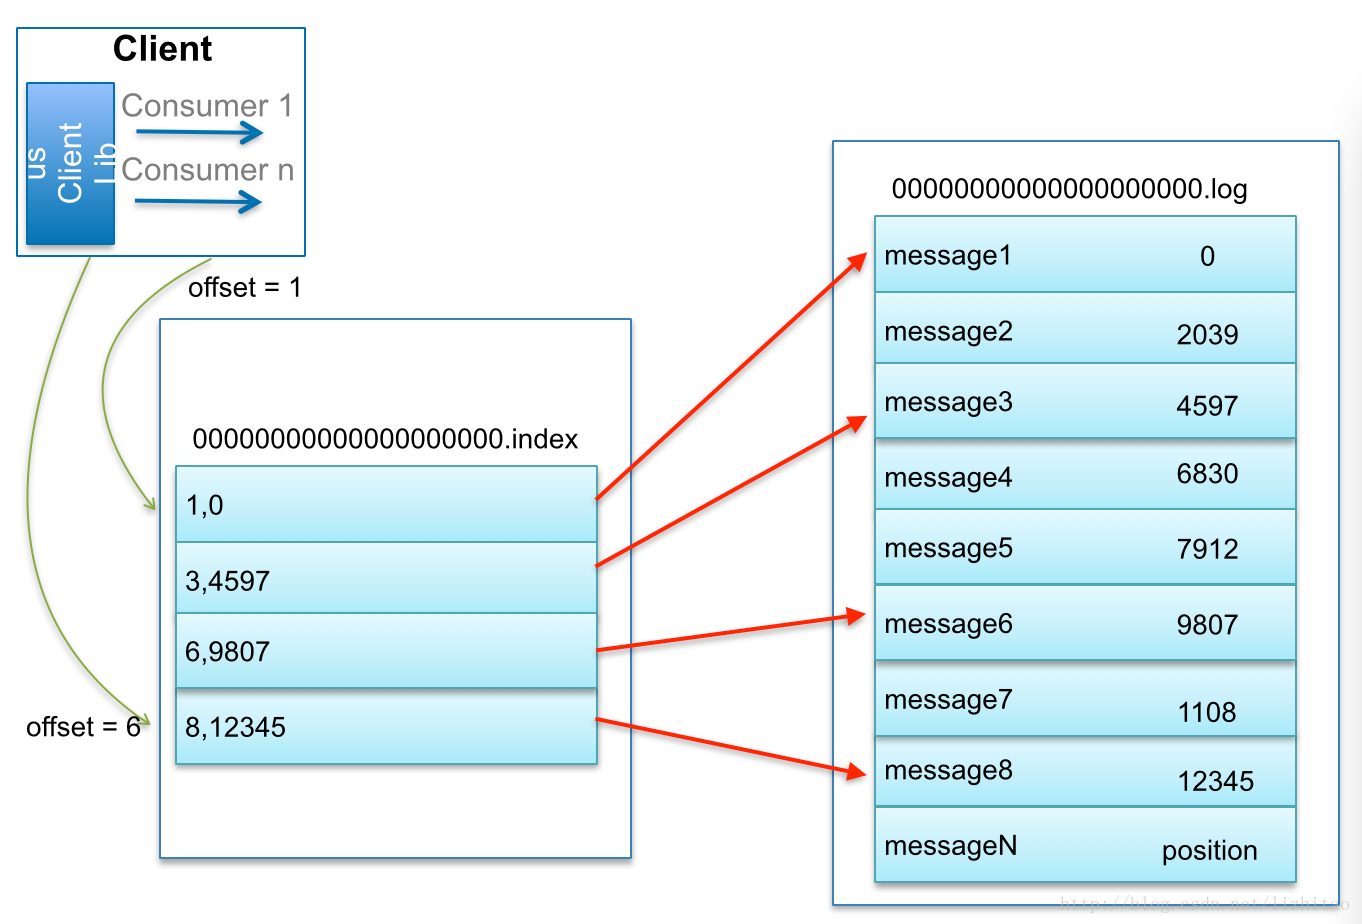
- 首先是用二分查找确定它是在哪个LogSegment中,自然是在第一个Segment中。
- 打开这个Segment的index文件,也是用二分查找找到offset小于或者等于指定offset的索引条目中最大的那个offset。自然offset为6的那个索引是我们要找的,通过索引文件我们知道offset为6的Message在数据文件中的位置为9807。
- 打开数据文件,从位置为9807的那个地方开始顺序扫描直到找到offset为7的那条Message。
这套机制是建立在offset是有序的。索引文件被映射到内存中,所以查找的速度还是很快的。
一句话,Kafka的Message存储采用了分区(partition),分段(LogSegment)和稀疏索引这几个手段来达到了高效性。
Kafka日志存储原理的更多相关文章
- 【原创】阿里三面:搞透Kafka的存储架构,看这篇就够了
阅读本文大约需要30分钟.这篇文章干货很多,希望你可以耐心读完. 你好, 我是华仔,在这个 1024 程序员特殊的节日里,又和大家见面了. 从这篇文章开始,我将对 Kafka 专项知识进行深度剖析, ...
- Es+kafka搭建日志存储查询系统(设计)
现在使用的比较常用的日志分析系统有Splunk和Elk,Splunk功能齐全,处理能力强,但是是商用项目,而且收费高.Elk则是Splunk项目的一个开源实现,Elk是ElasticSearch(Es ...
- kafka知识体系-kafka设计和原理分析-kafka文件存储机制
kafka文件存储机制 topic中partition存储分布 假设实验环境中Kafka集群只有一个broker,xxx/message-folder为数据文件存储根目录,在Kafka broker中 ...
- kafka知识体系-kafka设计和原理分析
kafka设计和原理分析 kafka在1.0版本以前,官方主要定义为分布式多分区多副本的消息队列,而1.0后定义为分布式流处理平台,就是说处理传递消息外,kafka还能进行流式计算,类似Strom和S ...
- Kafka文件存储机制及partition和offset
转载自: https://yq.aliyun.com/ziliao/65771 参考: Kafka集群partition replication默认自动分配分析 如何为kafka选择合适的p ...
- 深入剖析kafka架构内部原理
1 概述 Kakfa起初是由LinkedIn公司开发的一个分布式的消息系统,后成为Apache的一部分,它使用Scala编写,以可水平扩展和高吞吐率而被广泛使用.目前越来越多的开源分布式处理系统如Cl ...
- Kafka文件存储机制及offset存取
Kafka是什么 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx ...
- Kafka文件存储机制那些事
Kafka是什么 Kafka是最初由Linkedin公司开发,是一个分布式.分区的.多副本的.多订阅者,基于zookeeper协调的分布式日志系统(也可以当做MQ系统),常见可以用于web/nginx ...
- kafka日志同步至elasticsearch和kibana展示
kafka日志同步至elasticsearch和kibana展示 一 kafka consumer准备 前面的章节进行了分布式job的自动计算的概念讲解以及实践.上次分布式日志说过日志写进kafka, ...
随机推荐
- 使用 Django WebSocket Redis 搭建在线即时通讯工具
话不多说先上效果图演示 项目:http://112.74.164.107:9990/ 1.安装组建 redis: yum install redis/apt install redis 2.创建虚拟化 ...
- pdo的用处,用法
PDO主要是用来对数据库进行访问的.PDO扩展为PHP访问数据库定义了一个轻量级的一致接口,不同数据库在访问时,采用相同方法名称,解决了连接数据库不统一问题.PDO扩展自身并不能实现任何数据库功能,必 ...
- Appium+python的单元测试框架unittest(1)(转)
unittest为python语言自带的单元测试框架,python把unittest封装为一个标准模块封装在python开发包中.unittest中常用的类有:unittest.TestCase.un ...
- mysql面试常见题目2
Sutdent表的定义 字段名 字段描述 数据类型 主键 外键 非空 唯一 自增 Id 学号 INT(10) 是 否 是 是 是 sName 姓名 VARCHAR(20) 否 否 是 否 否 Sex ...
- Eclipse web项目更改项目名称
1. 右键工程:Refactor->Rename,更改项目名称: 2. 修改项目目录下:.project文件 <?xml version="1.0" encoding= ...
- HackRF 无线门铃信号录制与重放
本文内容.开发板及配件仅限用于学校或科研院所开展科研实验! 淘宝店铺名称:开源SDR实验室 HackRF链接:https://item.taobao.com/item.htm?spm=a1z10.1- ...
- 51nod-1298 圆与三角形(计算几何超详解)
题目链接:http://www.51nod.com/onlineJudge/questionCode.html#!problemId=1298 给出圆的圆心和半径,以及三角形的三个顶点,问圆同三角形是 ...
- Windows10子系统安装ubuntu+kali渗透环境
Windows10安装子系统ubuntu,安装完ubuntu后再安装katoolin才能使用kali. (katoolin渗透测试的Linux发行版,它可以让你在其他Linux发行版上使用Kali的全 ...
- Ubuntu 1804 本地显示远程服务器文件
本地是 Ubuntu 1804 最近想查看服务器上的图片,之前都是scp到本地,感觉太麻烦,于是查到有一种方法,ssh图形界面那种: 1.在File 界面下,左侧文件栏的最后一列有 “+ Other ...
- Redux和React-Redux的实现(二):Provider组件和connect的实现
接着上一篇讲,上一篇我们实现了自己的Redux和介绍了React的context以及Provider的原理. 1. Provider组件的实现 Provider组件主要有以下下两个作用 在整个应用上包 ...