
Hadoop提交作业流程
一 、需要知道的内容
1.ResourceManager ------>yarn的老大
2.NodeManager ------>yarn的小弟
3.ResourceManager调度器 a.默认调度器------>先进先出FIFO
b.公平调度器------>每个任务都有执行的机会
......
4.心跳机制 ------>NodeManager可通过心跳机制将节点健康状况实时汇报给ResourceManager,而ResourceManager则会 根据每个NodeManager的健康状况适当调整分配的任务数目。当NodeManager认为自己的健康状况“欠 佳”时,可让ResourceManager不再分配任务,待健康状况好转时,再分配新任务。
5.NodeManager子进程------>独立于NodeManager,不在NodeManager内部
二 、Hadoop工作流程:
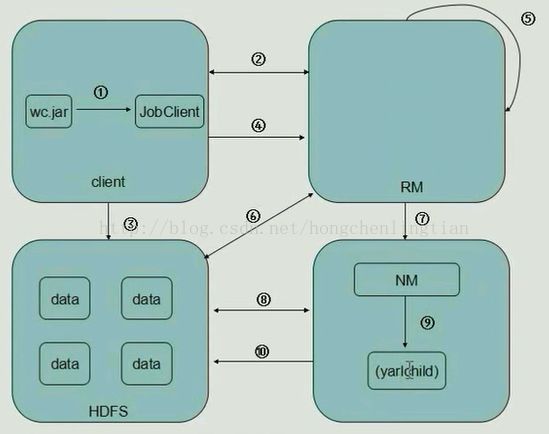
1.Client中,客户端提交一个mr的jar包给JobClient(提交方式:hadoop jar ...)
2.JobClient持有ResourceManager的一个代理对象,它向ResourceManager发送一个RPC请求,告诉ResourceManager作业开始,
然后ResourceManager返回一个JobID和一个存放jar包的路径给Client
3.Client将得到的jar包的路径作为前缀,JobID作为后缀(path = hdfs上的地址 + jobId) 拼接成一个新的hdfs的路径,然后Client通过FileSystem向hdfs中存放jar包,默认存放10份
(NameNode和DateNode等操作)
4.开始提交任务,Client将作业的描述信息(JobID和拼接后的存放jar包的路径等)RPC返回给ResourceManager
5.ResourceManager进行初始化任务,然后放到一个调度器中
6.ResourceManager读取HDFS上的要处理的文件,开始计算输入分片,每一个分片对应一个MapperTask,根据数据量确定起多少个mapper,多少个reducer
7.NodeManager 通过心跳机制向ResourceManager领取任务(任务的描述信息)
8.领取到任务的NodeManager去Hdfs上下载jar包,配置文件等
9.NodeManager启动相应的子进程yarnchild,运行mapreduce,运行maptask或者reducetask
10.map从hdfs中读取数据,然后传给reduce,reduce将输出的数据给回hdfs
---------------------
本文来自 小虹尘 的CSDN 博客 ,全文地址请点击:https://blog.csdn.net/hongchenlingtian/article/details/53524705?utm_source=copy
Hadoop提交作业流程的更多相关文章
- git 提交作业流程
git 提交作业流程,主要分为4个步骤 # 拉取远程git最新版本到本地,每次都可以先执行这条命令,因为会有其他同学更新仓库 git pull # add需要上传的文件,那个文件修改或者新增的,就ad ...
- hadoop提交作业自定义排序和分组
现有数据如下: 3 3 3 2 3 1 2 2 2 1 1 1 要求为: 先按第一列从小到大排序,如果第一列相同,按第二列从小到大排序 如果是hadoop默认的排序方式,只能比较key,也就是第一列, ...
- eclipse 提交作业到JobTracker Hadoop的数据类型要求必须实现Writable接口
问:在eclipse中的写的代码如何提交作业到JobTracker中的哪?答:(1)在eclipse中调用的job.waitForCompletion(true)实际上执行如下方法 connect() ...
- Spark源码系列(一)spark-submit提交作业过程
前言 折腾了很久,终于开始学习Spark的源码了,第一篇我打算讲一下Spark作业的提交过程. 这个是Spark的App运行图,它通过一个Driver来和集群通信,集群负责作业的分配.今天我要讲的是如 ...
- Spark集群之yarn提交作业优化案例
Spark集群之yarn提交作业优化案例 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.启动Hadoop集群 1>.自定义批量管理脚本 [yinzhengjie@s101 ...
- Hadoop yarn工作流程详解
yarn是什么?1.它是一个资源调度及提供作业运行的系统环境平台 资源:cpu.mem等 作业:map task.reduce Task yarn产生背景?它是从hadoop2.x版本才引入1.had ...
- 如何使用git 提交作业 收作业
如何使用git 提交作业 收作业 方法论: 今天就来用一个通俗易懂的自然模型来解释Git的commit,pull和push.不过,我们首先要理解两个名词,remote,local. remote,翻译 ...
- oozie 重新提交作业
在oozie的运行过程当中可能会出现错误,比如数据库连接不上,或者作业执行报错导致流程进入suspend或者killed状态,这个时候我们就要分析了,如果确实是数据或者是网络有问题,我们比如把问题解决 ...
- oozie java api提交作业
今晚试验用java的api来提交代码,由于代码是在我机器上写的,然后提交到我的虚拟机集群当中去,所以中间产生了一个错误..要想在任意一台机器上向oozie提交作业的话,需要对hadoop的core-s ...
随机推荐
- .net core获取服务器本地IP及Request访问端口
string str = (Request.HttpContext.Connection.LocalIpAddress.MapToIPv4().ToString() + ":" + ...
- NetCore入门篇:(七)Net Core项目使用Controller之二
一.简介 1.说明Post,Get定义的区别. 2.说明如何路由定义. 二.Get.Post定义 1.api不定义访问方式时,同时支持get 和 post.如果定义某种方式,则仅支持某种方式.具体看代 ...
- Ocelot中文文档入门
入门 Ocelot仅适用于.NET Core,目前是根据netstandard2.0构建的,如果Ocelot适合您,这个文档可能会有用. .NET Core 2.1 安装NuGet包 使用nuget安 ...
- Sql Server字符串拆分(Split)方法汇总
详细链接:https://shop499704308.taobao.com/?spm=a1z38n.10677092.card.11.594c1debsAGeak--方法0:动态SQL法 declar ...
- FunDA(12)- 示范:强类型数据源 - strong typed data sources
FunDA设计的主要目的是解决FRM(Functional Relation Mapping)如Slick这样的批次型操作工具库数据源行间游动操作的缺失问题.FRM产生的结果集就是一种静态集合,缺乏动 ...
- 非对齐访问(unaligned accesses)
从CPU角度看内存访问对齐 结构体成员非对齐访问所带来的思考 ARM体系中存储系统非对齐的存储访问操作 什么是cache line? cache line就是处理器从RAM load/store数据到 ...
- JavaScript把函数作为另一函数的参数
首先说一下这个问题是怎么产生的:今天看排序算法,想要比较不同的排序算法的时间花费. 最简单的时间统计方法是在程序块开始和结束时分别计时,求一下时间差就能得出该段代码的耗时. 如: var foo = ...
- nc,远程传输文件
linux互传文件nc命令 使用nc命令可以很快的在两台主机传递文件,且不需要在同一网段,只要设置好端口即可. 一.安装(CentOS下) yum install -y nc (需要root权限 ...
- 【apio2007】【ctsc2007】 数据备份 贪心+链表+堆
题目大意:有n个点,k条链,每个点离原点有一定的距离.要你用k条链连接2k个点,使得k条链的长度最短. 首先每次肯定是链相邻的2个点,所以我们先把相邻2个点的差值求出来,得到有n-1个数的数列. 然后 ...
- windows7下部署tomcat
需要准备的软件: 1.JDK 安装程序 2.Tomcat 安装程序 JDK安装步骤: 安装方式:使用安装程序进行安装.使用JDK文件夹,免安装,以下步骤使用的是文件夹免安装,只需配置环境变量 配置环境 ...