
Python网络爬虫实战(四)模拟登录
对于一个网站的首页来说,它可能需要你进行登录,比如知乎,同一个URL下,你登录与未登录当然在右上角个人信息那里是不一样的。
(登录过)
(未登录)
那么你在用爬虫爬取的时候获得的页面究竟是哪个呢?
肯定是第二个,不可能说你不用登录就可以访问到一个用户自己的主页信息,那么是什么让同一个URL在爬虫访问时出现不同内容的情况呢?
在第一篇中我们提到了一个概念,cookie,因为HTTP是无状态的,所以对方服务器并不知道这次请求到底来自于谁,就好像突然你收到了一封信,上面让你给他寄一些东西,但是信上却没有他的联系方式。
在HTTP中也是如此,我们普通的请求都类似于匿名信,而cookie的出现,就是让这封信上盖上了你自己的名字。
在请求时附带上你的cookie,服务器放就会知道这次请求来自于谁,然后你点击个人信息页,服务器就知道是要返回这个cookie对应的用户的信息页了。
在谷歌浏览器中,你可以在控制台Application里面找到当前网站的所有cookie键值对。一般来说用于确认你个人信息的只有一个键值对,但是你也可以把所有的都用上,并不能保证对方服务器是不是对某些键值对也进行检查了。
很多网站在你没有登录的情况下并不会给过多的数据让你看,所以你的爬虫需要进行一次模拟登录。
模拟登录需要从一个网站的登录界面开始,因为我们要在这里用爬虫发送post请求附带账号密码来登录对方网站。
拿人人网来举例。
人人网登录地址:http://www.renren.com/
打开控制台,我们可以先尝试观察一次登录的网络请求。很容易就能在里面找到一个/login的POST请求,登录的请求都会是POST,因为GET请求的参数会放在URL上,很容易被人拦截看到你的账号密码。
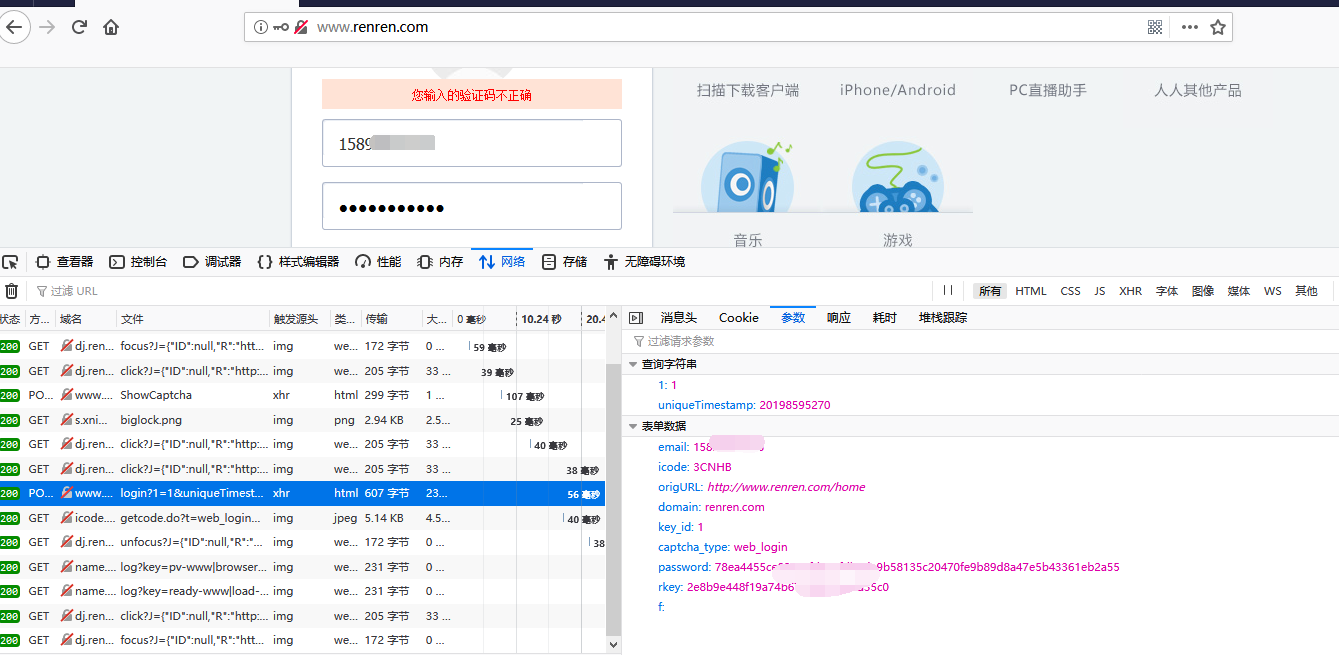
在表单参数中,我们需要注意的就只有email,password和rkey了,其他的照填即可。
email是我们的账号名,可以是邮箱也可以是电话号。
password是密码,这个密码明显是加密过的,对于这种情况,我们在请求时也要用同样的算法对密码进行加密,但是我们如何知道对方采用了什么加密算法呢?
这种情况大多数你都可以在控制台sources里面找到,在这里你可以找到网站加载过的所有文件,而加密算法一般会在js文件中。
sources里面很明显有一个叫login.js的文件,那么它一定和登录有关系,因为在sources里面打开js太难看了,会缩成一行,所以我就在控制台打开它了。
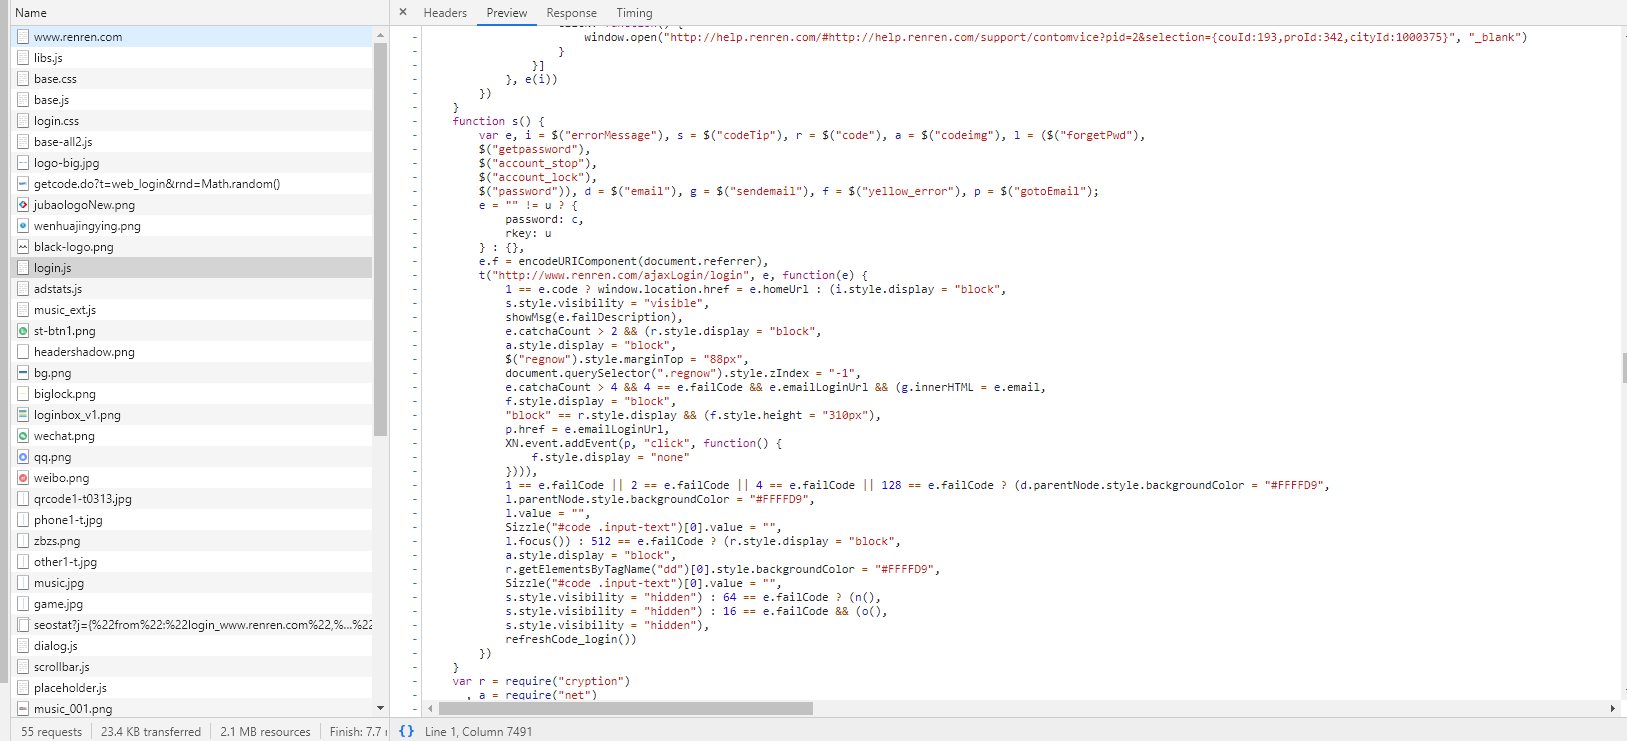
根据password定位到这里。
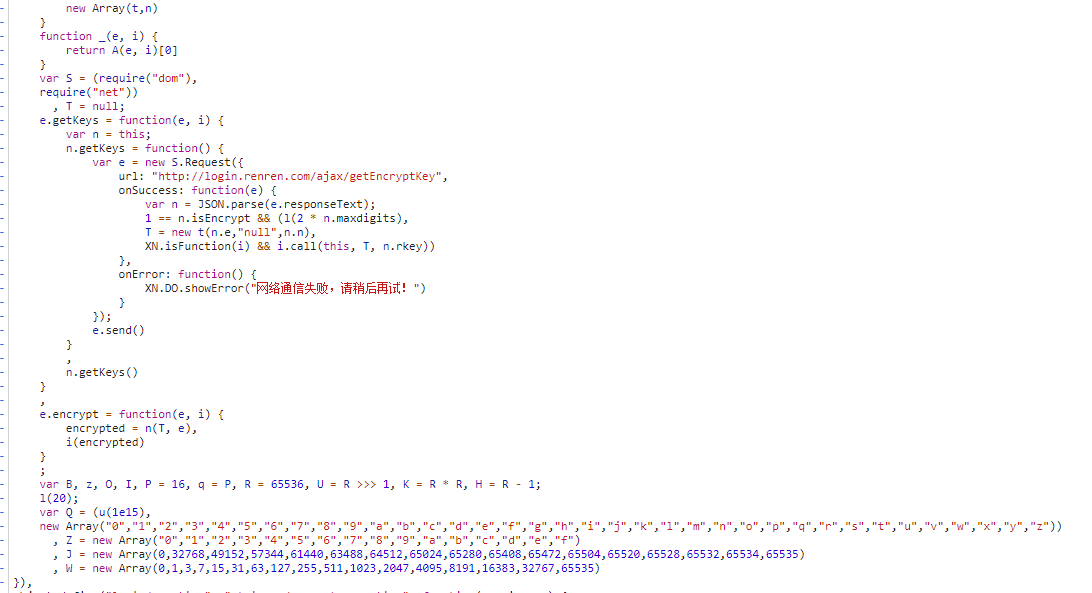
可以找到关于登录时密码加密的算法,顺便一提,人人网这个login.js的函数命名真的是没救了,abcd...xyz用了个遍,不知道是为了恶心自己人还是恶心别人写爬虫分析它这个login。但是很遗憾的是人人网给爬虫留下了一个很方便的登录途径,我们甚至可以不用自己加密密文!!!
虽然说这里可以不用自己转义加密算法了,但是其实很多网站并不会像人人网这样暴露出一个action的do事件让我们可以直接调用的,所以最好还是掌握一些密文加密的那部分。
再来看人人网暴露出的爬虫便捷登录的接口。
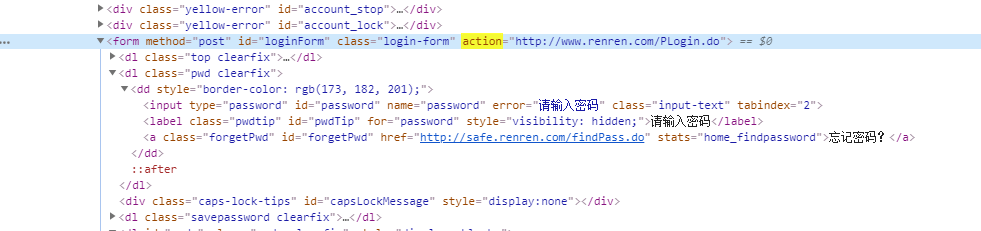
我们只需要调用这个do即可完成登录。
也就是说,我们模拟这个form来完成请求,在请求前,我们需要把信息装填到form中。
先安装scrapy依赖
pip install scrapy
import scrapy

url = "http://www.renren.com/PLogin.do"

data = {"email": "xxxxx", "password": "xxxxx"}

response = scrapy.FormRequest(url,formdata=data,callback=self.parse_page)
登录成功之后,我们就可以从response中拿到cookie,然后在之后的请求中都附带上cookie,这样对方服务器就知道我们是谁了。
如果之前在网页登录失败次数过多,可能会导致爬虫模拟登录需要验证码,而此处是考虑不需要验证码的情况,所以可能会登录失败,解决方法可以是清理本机Cookie。
Python网络爬虫实战(四)模拟登录的更多相关文章
- python网络爬虫实战PDF高清完整版免费下载|百度云盘|Python基础教程免费电子书
点击获取提取码:vg1y python网络爬虫实战帮助读者学习Python并开发出符合自己要求的网络爬虫.网络爬虫,又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动地抓取互联网信息的程序或者脚 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- Python网络爬虫实战(一)快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
- python网络爬虫实战之快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
- 关于Python网络爬虫实战笔记①
python网络爬虫项目实战笔记①如何下载韩寒的博客文章 python网络爬虫项目实战笔记①如何下载韩寒的博客文章 1. 打开韩寒博客列表页面 http://blog.sina.com.cn/s/ar ...
- Python 爬虫实战5 模拟登录淘宝并获取所有订单
经过多次尝试,模拟登录淘宝终于成功了,实在是不容易,淘宝的登录加密和验证太复杂了,煞费苦心,在此写出来和大家一起分享,希望大家支持. 本篇内容 python模拟登录淘宝网页 获取登录用户的所有订单详情 ...
- Python网络爬虫实战入门
一.网络爬虫 网络爬虫(又被称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序. 爬虫的基本流程: 发起请求: 通过HTTP库向目标站点发起请求,也就是发送一个Request ...
- Python网络爬虫实战:根据天猫胸罩销售数据分析中国女性胸部大小分布
本文实现一个非常有趣的项目,这个项目是关于胸罩销售数据分析的.是网络爬虫和数据分析的综合应用项目.本项目会从天猫抓取胸罩销售数据,并将这些数据保存到SQLite数据库中,然后对数据进行清洗,最后通过S ...
- Python网络爬虫实战(三)照片定位与B站弹幕
之前两篇已经说完了如何爬取网页以及如何解析其中的数据,那么今天我们就可以开始第一次实战了. 这篇实战包含两个内容. * 利用爬虫调用Api来解析照片的拍摄位置 * 利用爬虫爬取Bilibili视频中的 ...
随机推荐
- Day 01--选题与设计(一)
1.第一天我们主要确定了软件课设的项目,做一个学校内食堂订送餐的微信小程序.我们大体的设计思路是:可以实现学生身份的认证,幷使学生们能自行选择校园内的食堂,挑选各个食堂各个窗口菜谱上可以选择的菜,选择 ...
- Redis缓存,持久化,高可用
一,Redis作缓存服务器 本篇博客是接着上一篇博客未分享完的技术点. redis作为缓存服务器是众多企业中的选择之一,虽然该技术很成熟但也是存在一定的问题.就是缓存带来的缓存穿透,缓存击穿, ...
- JavaScript中一个方法同时发送两个ajax请求问题
今天在做项目中遇到一个问题,大概是在一个jsp页面同时有一个select下拉搜索条件框和一个Bootstrap表格展示列表.这两个都要通过ajax向后台拿数据,而且要在页面加载时完成.当时的做法是: ...
- hbase性能优化,看这篇就够了
HDFS(hdfs-site.xml)相关调整 dfs.datanode.synconclose = true dfs.datanode.synconclose set to false in hdf ...
- 导入 SQL 时出现 Invalid default value for 'create_time' 报错解决方法
问题描述 十三在 GitHub 仓库中开源了一个 Spring Boot 技术栈开发的 My-Blog 项目: 因为功能比较多,数据的存储就选择了 MySQL 数据库,该项目的表结构也放到了仓库中,方 ...
- LSTM 反向传播算法
1. https://www.cnblogs.com/pinard/p/6519110.html (详细原理!) 2. https://blog.csdn.net/abeldeng/article/d ...
- Java 并发编程(一):摩拳擦掌
这篇文章的标题原本叫做——Java 并发编程(一):简介,作者名叫小二.但我在接到投稿时觉得这标题不够新颖,不够吸引读者的眼球,就在发文的时候强行修改了标题(也不咋滴). 小二是一名 Java 程序员 ...
- Python Web Flask源码解读(一)——启动流程
关于我 一个有思想的程序猿,终身学习实践者,目前在一个创业团队任team lead,技术栈涉及Android.Python.Java和Go,这个也是我们团队的主要技术栈. Github:https:/ ...
- javaScript 基础知识汇总(三)
1.循环:while 和 for while 循环 while(condition){ //代码 循环体 } do ... while 循环 let i =0; do { //循环体 }while( ...
- 你真的了解Mybatis的${}和#{}吗?是否了解应用场景?
转自:https://www.cnblogs.com/mytzq/p/9321526.html 动态sql是mybatis的主要特性之一.在mapper中定义的参数传到xml中之后,在查询之前myba ...