
(原)torch和caffe中的BatchNorm层
转载请注明出处:
http://www.cnblogs.com/darkknightzh/p/6015990.html
BatchNorm具体网上搜索。
caffe中batchNorm层是通过BatchNorm+Scale实现的,但是默认没有bias。torch中的BatchNorm层使用函数SpatialBatchNormalization实现,该函数中有weight和bias。
如下代码:
local net = nn.Sequential()

net:add(nn.SpatialBatchNormalization())

net:add(nn.SpatialBatchNormalization(, 1e-5, 0.1, false))

print(net.modules)
输出如下:
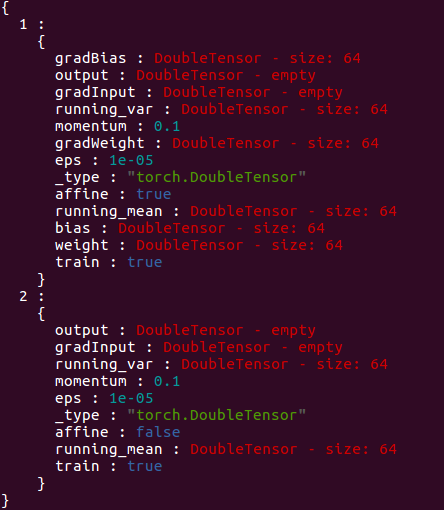
其中第一个为nn.SpatialBatchNormalization(64),第二个为nn.SpatialBatchNormalization(64, 1e-5, 0.1, false)。
SpatialBatchNormalization 参数如下:
nn.SpatialBatchNormalization(N [,eps] [, momentum] [,affine])
默认情况下,eps=1e-5,momentum =0.1,affine=true。因而若要和caffe中的BatchNorm一样,均没有weight和bias,则需要将affine设置为false。若affine为默认值,有如下两种方法可以使torch和caffe参数一致(不太确定):
1. 手动将bias设置为0,此时能和caffe中BatchNorm+Scale(默认的)一样。
2. caffe中ScaleParameter的bias_term(equivalent to a ScaleLayer+BiasLayer)设置为true(该值默认为false)。
========================================================================
161110更新(可能有不对的地方):
对于Caffe:
在使用BatchNorm时,Batch层共3个参数,1个存储均值向量,一个存储方差向量,第三个存储缩放的值。最终的均值向量=均值向量/缩放;最终的方差向量=方差向量/缩放。
Scale层共2个参数,一个存储的是γ向量,一个存储的是β向量。
假设caffe中BatchNorm层输入为1(batch size)*64(channel)*128(height)*128(width)(输出和输入一样),则BatchNorm层共3个参数:mean(64维的向量),variance(64维的向量),scalefactor(1维的向量)。其中mean存储了每一channel的均值,variance存储了每一channel的方差,scalefactor看着caffe的参数,好像都是999.982361(没有过多测试,不太确定)。
在TEST阶段,当输入一个数,如0.001932,对应的mean= -5122.504395,variance=385844.062500,scale= 999.982361时,
缩放后的mean:-5122.504395/999.982361=-5.1225947524488384450613324368429
缩放后的variance:385844.062500/999.982361=385.85086852346988548531007538442
标准差:(385.85086852346988548531007538442+1e(-5))^0.5=
19.643087296132191385983152758013
缩放后的值:
(0.001932-(-5.1225947524488384450613324368429))/ 19.643087296132191385983152758013= 0.26088194158042966422836995726056
实际上得到的为0.260882。在精度范围内一致。
总结起来就是,对每个维度使用对应的均值和方差。不同batch使用对应的参数。
在TRAIN阶段,则是首先计算每个batch不同channel的均值及方差,而后通过论文中公式得到对应的输出。
${{\hat{x_i}}}=\frac{{{x}_{i}}-{{\mu }_{B}}}{\sqrt{\sigma _{B}^{2}+\varepsilon }}$
$E\left[ x \right]={{E}_{B}}\left[ {{\mu }_{B}} \right]$
$Var\left[ x \right]=\frac{m}{m-1}{{E}_{B}}\left[ \sigma _{B}^{2} \right]$
实际中感觉caffe中,即便在训练阶段,依旧使用上面的var来计算方差。
caffe中scale层,得到的scale_param包括weight和bias,均为channel维的向量(如64)。之后对于输入,通过下式计算输出。注意的是,不同channel使用各自的weight和bias,同一个channel的weight和bias都一样。
${{y}_{i}}=\gamma {{\hat{x_i}}}+\beta $
对于torch:
torch中SpatialBatchNormalization是跟在conv层之后,其输入为4D数据(应该是batch_size*channel*height*width),另一个BatchNormalization层是跟在一般的层后面(这样说不太准确吧),其输入为2D数据(应该是batch_size*channel)。SpatialBatchNormalization继承自BatchNormalization。
SpatialBatchNormalization和BatchNormalization的第一个参数N代表特征的维数(channel)。
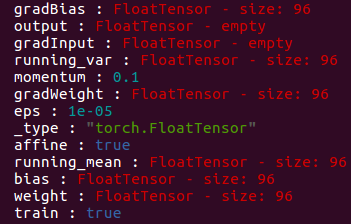
当affine=true时,SpatialBatchNormalization中结构:
当affine=false时,SpatialBatchNormalization中结构:
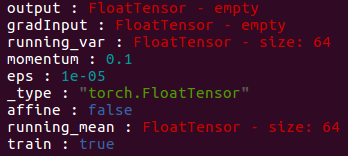
当net:evaluate()时,上两图中最后一个参数train为false。
其中,running_mean存储的是特征的mean(对应于caffe中最终的均指向量),running_var存储的是特征的方差(对应于caffe中最终的方差向量)。weight存储的是缩放时特征的γ,bias存储的是缩放时特征的β。
BatchNorm的论文为:Batch Normalization Accelerating Deep Network Training by Reducing Internal Covariate Shift。
161110更新结束
161121更新
今天使用cudnn的BatchNormalization时,提示Only CUDA tensors are supported for cudnn.BatchNormalization,而后程序崩溃。网上搜索了一下,https://github.com/soumith/cudnn.torch/issues/219遇到了类似的问题。具体原因可能不太一样吧。我这边是使用BatchNormalization(或者SpatialBatchNormalization)的问题。该层affine=true时,会使用仿射(有weight和bias),affine=false时,无weight和bias。而cudnn实际上只支持affine=true的情况(目前是这样),我这边程序有affine=false的时候,此时使用cudnn的BatchNormalization(SpatialBatchNormalization继承自BatchNormalization,下面不在说明SpatialBatchNormalization)就会直接assert错误了。
cudnn的BatchNormalization的部分初始化代码如下(位置:/home/XXX/torch/install/share/lua/5.1/cudnn/BatchNormalization.lua):
function BatchNormalization:__init(nFeature, eps, momentum, affine)

   parent.__init(self)

   assert(nFeature and type(nFeature) == 'number',

          'Missing argument #1: Number of feature planes. ')

   assert(nFeature ~= , 'To set affine=false call BatchNormalization'

     .. '(nFeature,  eps, momentum, false) ')

   assert(affine == true or affine == nil, 'only affine supported')
实际上assert错误的地方是下面代码的最后一行:
function BatchNormalization:createIODescriptors(input)

   assert(input:dim() == self.nDim)

   assert(torch.typename(self.weight) == 'torch.CudaTensor' and torch.typename(self.bias) == 'torch.CudaTensor',

          'Only CUDA tensors are supported for cudnn.BatchNormalization!')
从初始化代码可以看出,cudnn的BatchNormalization只支持affine=true的情况。
该网页也提供了解决方法:byronwwang在第5层的回复中注释的代码就是解决方法。在使用cudnn.convert时,可以通过第三个参数,不转换某些层。https://github.com/soumith/cudnn.torch里面也给出了不转换层时的代码(Conversion between cudnn and nn这部分):
cudnn.convert(net, cudnn, function(module)

   return torch.type(module):find('BatchNormalization')

end)
此时BatchNormalization会使用nn模块中的BatchNormalization。
161121更新结束
========================================================================
(原)torch和caffe中的BatchNorm层的更多相关文章
- caffe中的BatchNorm层
在训练一个小的分类网络时,发现加上BatchNorm层之后的检索效果相对于之前,效果会有提升,因此将该网络结构记录在这里,供以后查阅使用: 添加该层之前: layer { name: "co ...
- caffe 中 python 数据层
caffe中大多数层用C++写成. 但是对于自己数据的输入要写对应的输入层,比如你要去图像中的一部分,不能用LMDB,或者你的label 需要特殊的标记. 这时候就需要用python 写一个输入层. ...
- caffe中全卷积层和全连接层训练参数如何确定
今天来仔细讲一下卷基层和全连接层训练参数个数如何确定的问题.我们以Mnist为例,首先贴出网络配置文件: name: "LeNet" layer { name: "mni ...
- caffe中添加local层
下载caffe-local,解压缩; 修改makefile.config:我是将cuudn注释掉,去掉cpu_only的注释; make all make test(其中local_test出错,将文 ...
- 转载:caffe中的Reshape层
http://blog.csdn.net/terrenceyuu/article/details/76228317 #作用:在不改变数据的情况下,改变输入的维度 layer { name: " ...
- 深度学习中 batchnorm 层是咋回事?
作者:Double_V_ 来源:CSDN 原文:https://blog.csdn.net/qq_25737169/article/details/79048516 版权声明:本文为博主原创文章,转载 ...
- caffe中各层的作用:
关于caffe中的solver: cafffe中的sover的方法都有: Stochastic Gradient Descent (type: "SGD"), AdaDelta ( ...
- caffe中ConvolutionLayer的前向和反向传播解析及源码阅读
一.前向传播 在caffe中,卷积层做卷积的过程被转化成了由卷积核的参数组成的权重矩阵weights(简记为W)和feature map中的元素组成的输入矩阵(简记为Cin)的矩阵乘积W * Cin. ...
- caffe中batch norm源码阅读
1. batch norm 输入batch norm层的数据为[N, C, H, W], 该层计算得到均值为C个,方差为C个,输出数据为[N, C, H, W]. <1> 形象点说,均值的 ...
随机推荐
- Zepto源码笔记(一)
最近在研究Zepto的源码,这是第一篇分析,欢迎大家继续关注,第一次写源码笔记,希望大家多指点指点,第一篇文章由于首次分析原因不会有太多干货,希望后面的文章能成为各位大大心目中的干货. Zepto是一 ...
- 网狐6603 cocos2dx 棋牌、捕鱼、休闲类游戏《李逵捕鱼》手机端完整源码分析及分享
该资源说明: cocos2d 棋牌.捕鱼.休闲类游戏<李逵捕鱼>手机端完整源码,网狐6603配套手机版源码,可以选桌子,适合新手学习参考,小编已亲测试,绝对完整可编译手机端,下载后将文件考 ...
- 创建区域Areas,添加TagHelper
创建区域Areas,添加TagHelper 目录索引 [无私分享:ASP.NET CORE 项目实战]目录索引 简介 在Asp.net Core VS2015中,我们发现还有很多不太简便的地方,比如右 ...
- Android学习笔记--Menu菜单的使用
实现选项菜单.上下文菜单,以及菜单内部的子菜单. 视图效果: MainActivity 选项菜单 选项菜单的子菜单 上下文菜单(按住按钮或者EditText弹出) 注意:上下文菜单如何弹出?在注册该菜 ...
- HBase笔记--安装及启动过程中的问题
1.使用hbase shell的时候运行命令执行失败 例如:在shell下执行 status,失败. 可能的原因:节点之间的时间差距过大 解决方法调整两个节点的时间,使二者一致,这里用了个比较笨的方法 ...
- 转:从BeagleBone谈AM335x硬件系统设计
链接:http://blog.chinaunix.net/uid-730738-id-3266690.html 作者:chenzhufly 从BeagleBone谈AM335x硬件系统设计 日期 ...
- 采购IC应该知道的十大网站
http://www.hcsindex.com (华强北指数网,查价格的)http://www.hqew.com (华强电子网,针对华强北市场)http://www.dzsc.com (维库电子 ...
- Spring注解 @Resource和@Autowired
@Resource和@Autowired两者都是做bean的注入使用.其实@Resource并不是Spring的注解,他的包是javax.annotation.Resource 需要导入.但是Spri ...
- 利用linux信号机制调试段错误(Segment fault)
在实际开发过程中,大家可能会遇到段错误的问题,虽然是个老问题,但是其带来的隐患是极大的,只要出现一次,程序立即崩溃中止.如果程序运行在PC中,segment fault的调试相对比较方便,因为可以通过 ...
- bzoj 1193
http://www.lydsy.com/JudgeOnline/problem.php?id=1193 大范围贪心,小范围宽搜. 膜拜大神 http://blog.csdn.net/u0129155 ...