
Spark 源码解析 : DAGScheduler中的DAG划分与提交
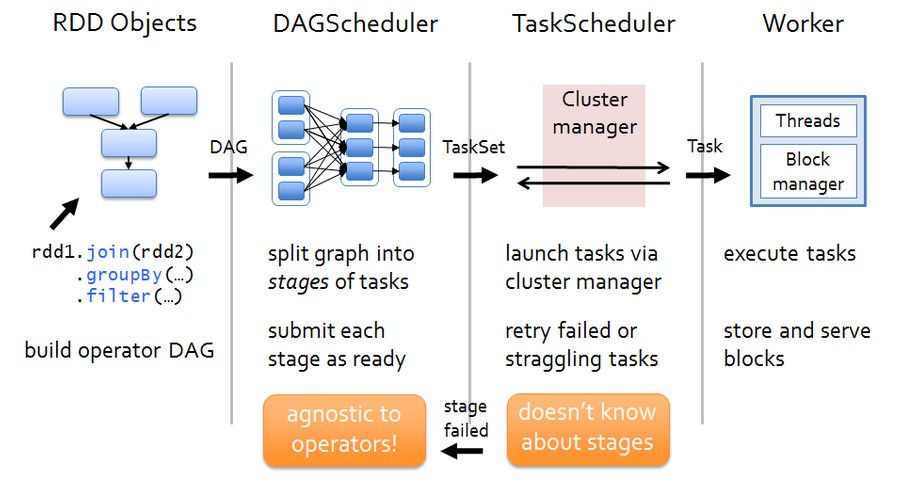
一、Spark 运行架构
def submitJob[T, U](rdd: RDD[T],func: (TaskContext, Iterator[T]) => U,partitions: Seq[Int],callSite: CallSite,resultHandler: (Int, U) => Unit,properties: Properties): JobWaiter[U] = {// Check to make sure we are not launching a task on a partition that does not exist.val maxPartitions = rdd.partitions.lengthpartitions.find(p => p >= maxPartitions || p < 0).foreach { p =>throw new IllegalArgumentException("Attempting to access a non-existent partition: " + p + ". " +"Total number of partitions: " + maxPartitions)}val jobId = nextJobId.getAndIncrement()if (partitions.size == 0) {// Return immediately if the job is running 0 tasksreturn new JobWaiter[U](this, jobId, 0, resultHandler)}assert(partitions.size > 0)val func2 = func.asInstanceOf[(TaskContext, Iterator[_]) => _]val waiter = new JobWaiter(this, jobId, partitions.size, resultHandler)//给eventProcessLoop发送JobSubmitted消息eventProcessLoop.post(JobSubmitted(jobId, rdd, func2, partitions.toArray, callSite, waiter,SerializationUtils.clone(properties)))waiter}
private[scheduler] val eventProcessLoop = new DAGSchedulerEventProcessLoop(this)
private def doOnReceive(event: DAGSchedulerEvent): Unit = event match {//Job提交
case JobSubmitted(jobId, rdd, func, partitions, callSite, listener, properties) =>dagScheduler.handleJobSubmitted(jobId, rdd, func, partitions, callSite, listener, properties)case MapStageSubmitted(jobId, dependency, callSite, listener, properties) =>dagScheduler.handleMapStageSubmitted(jobId, dependency, callSite, listener, properties)case StageCancelled(stageId) =>dagScheduler.handleStageCancellation(stageId)case JobCancelled(jobId) =>dagScheduler.handleJobCancellation(jobId)case JobGroupCancelled(groupId) =>dagScheduler.handleJobGroupCancelled(groupId)case AllJobsCancelled =>dagScheduler.doCancelAllJobs()case ExecutorAdded(execId, host) =>dagScheduler.handleExecutorAdded(execId, host)case ExecutorLost(execId) =>dagScheduler.handleExecutorLost(execId, fetchFailed = false)case BeginEvent(task, taskInfo) =>dagScheduler.handleBeginEvent(task, taskInfo)case GettingResultEvent(taskInfo) =>dagScheduler.handleGetTaskResult(taskInfo)case completion: CompletionEvent =>dagScheduler.handleTaskCompletion(completion)case TaskSetFailed(taskSet, reason, exception) =>dagScheduler.handleTaskSetFailed(taskSet, reason, exception)case ResubmitFailedStages =>dagScheduler.resubmitFailedStages()}
try {//创建新stage可能出现异常,比如job运行依赖hdfs文文件被删除finalStage = newResultStage(finalRDD, func, partitions, jobId, callSite)} catch {case e: Exception =>logWarning("Creating new stage failed due to exception - job: " + jobId, e)listener.jobFailed(e)return}
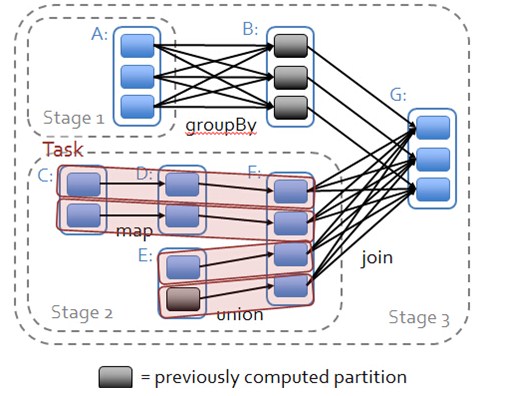
private def getMissingParentStages(stage: Stage): List[Stage] = {val missing = new HashSet[Stage] //存储需要返回的父Stageval visited = new HashSet[RDD[_]] //存储访问过的RDD//自己建立栈,以免函数的递归调用导致val waitingForVisit = new Stack[RDD[_]]def visit(rdd: RDD[_]) {if (!visited(rdd)) {visited += rddval rddHasUncachedPartitions = getCacheLocs(rdd).contains(Nil)if (rddHasUncachedPartitions) {for (dep <- rdd.dependencies) {dep match {case shufDep: ShuffleDependency[_, _, _] =>val mapStage = getShuffleMapStage(shufDep, stage.firstJobId)if (!mapStage.isAvailable) {missing += mapStage //遇到宽依赖,加入父stage}case narrowDep: NarrowDependency[_] =>waitingForVisit.push(narrowDep.rdd) //窄依赖入栈,}}}}}- //回溯的起始RDD入栈
waitingForVisit.push(stage.rdd)while (waitingForVisit.nonEmpty) {visit(waitingForVisit.pop())}missing.toList}
private def newOrUsedShuffleStage(shuffleDep: ShuffleDependency[_, _, _],firstJobId: Int): ShuffleMapStage = {val rdd = shuffleDep.rddval numTasks = rdd.partitions.lengthval stage = newShuffleMapStage(rdd, numTasks, shuffleDep, firstJobId, rdd.creationSite)if (mapOutputTracker.containsShuffle(shuffleDep.shuffleId)) {//Stage已经被计算过,从MapOutputTracker中获取计算结果val serLocs = mapOutputTracker.getSerializedMapOutputStatuses(shuffleDep.shuffleId)val locs = MapOutputTracker.deserializeMapStatuses(serLocs)(0 until locs.length).foreach { i =>if (locs(i) ne null) {// locs(i) will be null if missingstage.addOutputLoc(i, locs(i))}}} else {// Kind of ugly: need to register RDDs with the cache and map output tracker here// since we can't do it in the RDD constructor because # of partitions is unknownlogInfo("Registering RDD " + rdd.id + " (" + rdd.getCreationSite + ")")mapOutputTracker.registerShuffle(shuffleDep.shuffleId, rdd.partitions.length)}stage}
/** Submits stage, but first recursively submits any missing parents. */private def submitStage(stage: Stage) {val jobId = activeJobForStage(stage)if (jobId.isDefined) {logDebug("submitStage(" + stage + ")")if (!waitingStages(stage) && !runningStages(stage) && !failedStages(stage)) {val missing = getMissingParentStages(stage).sortBy(_.id)logDebug("missing: " + missing)if (missing.isEmpty) {logInfo("Submitting " + stage + " (" + stage.rdd + "), which has no missing parents")//如果没有父stage,则提交当前stagesubmitMissingTasks(stage, jobId.get)} else {for (parent <- missing) {//如果有父stage,则递归提交父stagesubmitStage(parent)}waitingStages += stage}}} else {abortStage(stage, "No active job for stage " + stage.id, None)}}
Spark 源码解析 : DAGScheduler中的DAG划分与提交的更多相关文章
- Spark 源码解析:TaskScheduler的任务提交和task最佳位置算法
上篇文章< Spark 源码解析 : DAGScheduler中的DAG划分与提交 >介绍了DAGScheduler的Stage划分算法. 本文继续分析Stage被封装成TaskSet, ...
- Spark源码分析 – DAGScheduler
DAGScheduler的架构其实非常简单, 1. eventQueue, 所有需要DAGScheduler处理的事情都需要往eventQueue中发送event 2. eventLoop Threa ...
- spark 源码分析之十九 -- DAG的生成和Stage的划分
上篇文章 spark 源码分析之十八 -- Spark存储体系剖析 重点剖析了 Spark的存储体系.从本篇文章开始,剖析Spark作业的调度和计算体系. 在说DAG之前,先简单说一下RDD. 对RD ...
- Scala实战高手****第4课:零基础彻底实战Scala控制结构及Spark源码解析
1.环境搭建 基础环境配置 jdk+idea+maven+scala2.11.以上工具安装配置此处不再赘述. 2.源码导入 官网下载spark源码后解压到合适的项目目录下,打开idea,File-&g ...
- Spark源码在Eclipse中部署/编译/运行
(1)下载Spark源码 到官方网站下载:Openfire.Spark.Smack,其中Spark只能使用SVN下载,源码的文件夹分别对应Openfire.Spark和Smack. 直接下载Openf ...
- 源码解析.Net中IConfiguration配置的实现
前言 关于IConfituration的使用,我觉得大部分人都已经比较熟悉了,如果不熟悉的可以看这里.因为本篇不准备讲IConfiguration都是怎么使用的,但是在源码部分的解读,网上资源相对少一 ...
- 源码解析.Net中DependencyInjection的实现
前言 笔者的这篇文章和上篇文章思路一样,不注重依赖注入的使用方法,更加注重源码的实现,我尽量的表达清楚内容,让读者能够真正的学到东西.如果有不太清楚依赖注入是什么或怎么在.Net项目中使用的话,请点击 ...
- 源码解析.Net中Middleware的实现
前言 本篇继续之前的思路,不注重用法,如果还不知道有哪些用法的小伙伴,可以点击这里,微软文档说的很详细,在阅读本篇文章前,还是希望你对中间件有大致的了解,这样你读起来可能更加能够意会到意思.废话不多说 ...
- 源码解析.Net中Host主机的构建过程
前言 本篇文章着重讲一下在.Net中Host主机的构建过程,依旧延续之前文章的思路,着重讲解其源码,如果有不知道有哪些用法的同学可以点击这里,废话不多说,咱们直接进入正题 Host构建过程 下图是我自 ...
随机推荐
- 微信小程序传值
方式一:通过设置id方式传值 <button class="btninvest" bindtap="goinvet" id="{{item.tx ...
- XML签名Cannot resolve element with ID XXXX 解决方案
最近同银行做接口联调,需要对XML文件做加签和解签操作,本地的开发环境是Mac 10.10,JDK的版本是1.6.0.65.小小的一段加签代码,一直报错,却久久也找不到解决方法,网上的资料非常少,错误 ...
- 《深入Java虚拟机》笔记
当运行一个Java程序的同时,也就在运行了一个Java虚拟机实例.Java虚拟机实例通过调用某个初始类的mian()方法来运行一个Java程序运行中Java程序的每一个线程都是一个独立的虚拟机执行引擎 ...
- DialogFragment 将数据传回Activity的onActivityResult方法
在MyActivity中 弹出一个DialogFragment (某一个控件的点击事件) search= findViewById(R.id.search); search.setOnClickLis ...
- Codeforces 797 F Mice and Holes
http://codeforces.com/problemset/problem/797/F F. Mice and Holes time limit per test 1.5 ...
- 【BZOJ】3091: 城市旅行 Link-Cut Tree
[题意]参考PoPoQQQ. 给定一棵树,每个点有一个点权,提供四种操作: 1.删除两点之间的连边 不存在边则无视 2.在两点之前连接一条边 两点已经联通则无视 3.在两点之间的路径上所有点的点权加上 ...
- 天梯赛L2-008 最长对称子串 (字符串处理)
对给定的字符串,本题要求你输出最长对称子串的长度.例如,给定"Is PAT&TAP symmetric?",最长对称子串为"s PAT&TAP s&quo ...
- Linux 脚本内容指定用户执行
#!/bin/bash set -x ## 因为这些变量在下面要用,所以要写在最上面, ## 如果直接写在下面,则变量获取不到,并且下面的 $ 标识的都要用 引号引起来,否则这些参数接收不到 tarf ...
- Coursera在线学习---第三节.归一化处理(Normalize)
一.归一化(也说标准化)作用 1)将有量纲特征转化为无量纲特征 2)能够加快收敛(主要指梯度下降法时) 二.Octave中计算 mean(A) 求解矩阵中每一列的均值 std(A ...
- 数据库管理软件 Navicat Premium12 破解步骤
数据库管理软件 Navicat Premium12B https://pan.baidu.com/s/1QnAQwW-q0SQ1JglpFGxKOA 密码 : mwqc 里面的软件和补丁是 ...