
深度学习与人类语言处理-语音识别(part2)
上节回顾深度学习与人类语言处理-语音识别(part1),这节课我们将学习如何将seq2seq模型用在语音识别
LAS
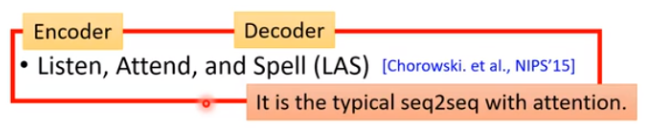
那我们来看看LAS的Encoder,Attend,Decoder分别是什么
Listen
Listen是一个典型的Encoder结构,输入为声学特征\({x^1,x^2,...,x^T}\),输出和输入长度相同,是对声学特征的高阶表示,\({h^1,h^2,...,h^T}\).
我们希望Encoder可以做到以下两件事:
- 提取输入的内容信息
- 移除不同说话者之间的差异,去掉噪音
那Encoder怎么做呢?可以用RNN、CNN、self-attention
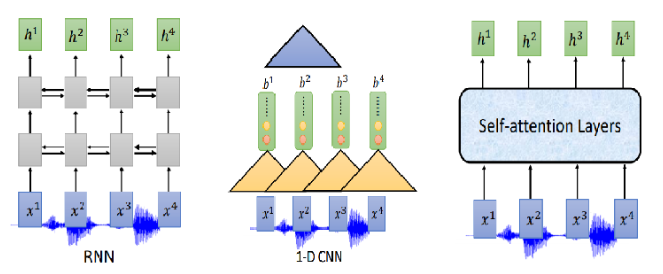
通常我们需要对声音信号进行下采样,为什么呢?当然是声音信号太长了,1s的声音信号就有100个向量(上节声学特征部分讲过),而且相邻的信号之间的差异不是特别大,下采样可以帮助我们有效的进行训练。下图是关于RNN的两个下采样方法
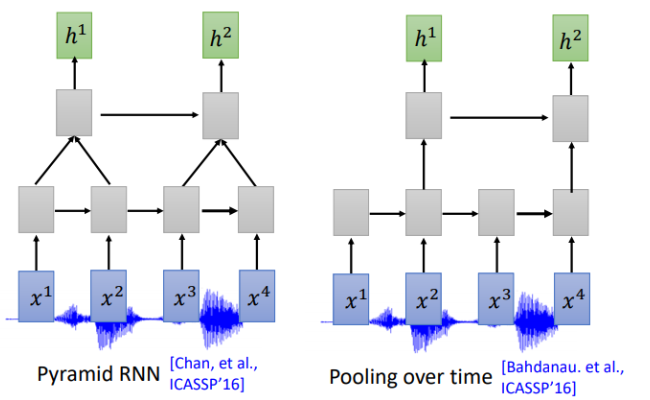
Pyramid RNN将下层每两个隐状态加起来作为下一层,实践证明这种方法还是很有效的。Pooling over time 和Pyramid RNN 很像,不同没有加起来,直接每两个隐状态取一次作为下层输入。
那CNN和self-attention是不是也可以用类似的下采样呢?答案是肯定的。对于CNN常用的变形是TDNN (Time-delay DNN),不同于传统的CNN做卷积操作时会考虑范围内所有的输入,TDNN相当于只让部分参与了运算,提高效率。
同样,对于self-attention,在机器翻译等任务中每一个位置的输入会看过序列中所有的输入,但是在语音识别中,序列实在太长了,Truncated Self-attention 就是让每一个位置的输入只看窗口范围内的其他输入,窗口大小是一个可以调节的参数,例如可以只看未来4个,看以前的30个。

attention
LAS的attention和机器翻译中的attention并没有什么不同,文献中提到了两种attention计算方法,dot-product attention 和additive attention
- dot-product attention
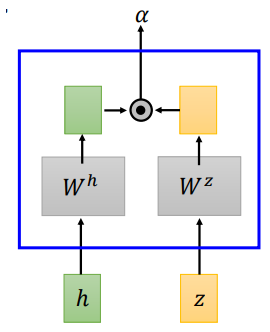
dot-product attention 将输入\(h\)和\(z\)经过矩阵\(W^h、W^z\)转换,将转换结果进行点积,得到\(\alpha\)
- additive attention
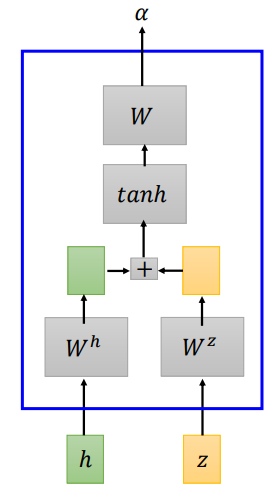
additive attention 将输入\(h\)和\(z\)经过矩阵\(W^h、W^z\)转换,将转换结果相加,经过一个线性变换得到\(\alpha\)
我们来看看LAS的attention具体怎么做的
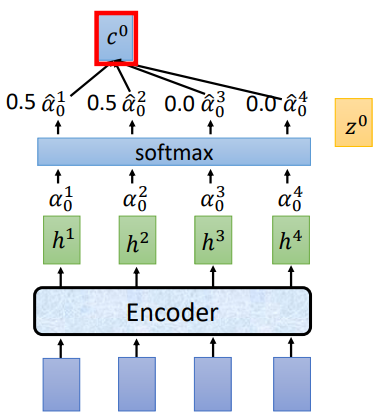
将\(z^0\)分别和\(h^1,h^2,h^3,h^4\)做attention运算得到\(\alpha ^1 _ 0,\alpha ^2 _ 0,\alpha ^3 _ 0,\alpha ^4 _ 0\),经过softmax归一化,再将归一化后的结果和\(h^i\)相乘求和得到 \(c^0\),将 \(c^0\)作为Decoder部分的输入
举个栗子:
讲过attention计算和softmax归一化后,得到的\(\hat{\alpha_0}\)为[0.5,0.5,0.0,0.0],\(c^0 = \sum\hat{\alpha}^i_0h^i=0.5h^1+0.5h^2\).
Spell
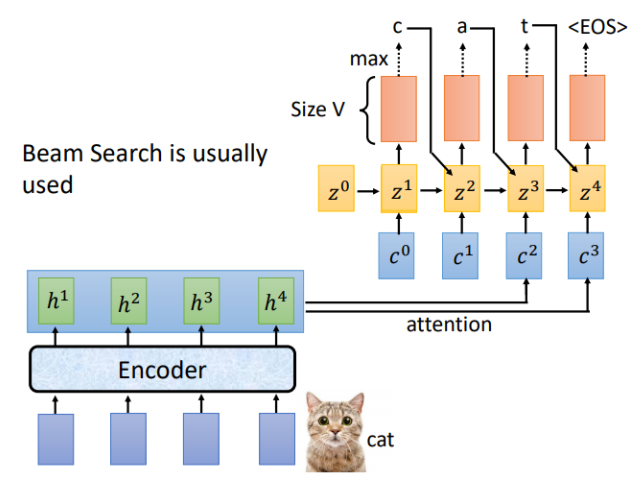
LAS的Listen对应Encoder,Spell对应的就是Decoder,假设Encoder的输入为“cat",Decoder的每一个时间步对应的输出就是词汇表中每个词的分布,通常会选概率最大的那个作为输出。

刚才是用\(z^0\)计算得到\(c^0\),现在我们用\(z^1\)进行运算,重复attention过程,就得到了\(c^1\),对应的结果如下

完整的Spell流程如下,通常输出结果会用束搜索(beam search),有关beam search 的内容可以自行了解。
Trainging
训练过程有一个重要的不同就是Teacher Forcing。刚才在Spell部分我们说到,一个时刻的输入其实有三个部分(\(c^1,z^0,o^0)\),当前位置的attention结果context向量,上一时刻的隐状态,以及上一时刻的预测输出。但是在training阶段,我们会将\(o^0\)换成真实的上一时刻的输出。假如\(t_0\)预测的输出为\(x\),实际应该输出\(c\),我们会将\(c\)作为下一时刻的输入。这就是Teacher Forcing
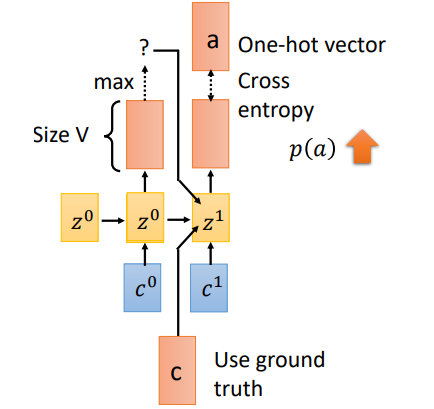
那为什么需要Teacher forcing呢?我们来看看如果使用上一时刻预测的输出作为输入会发生什么
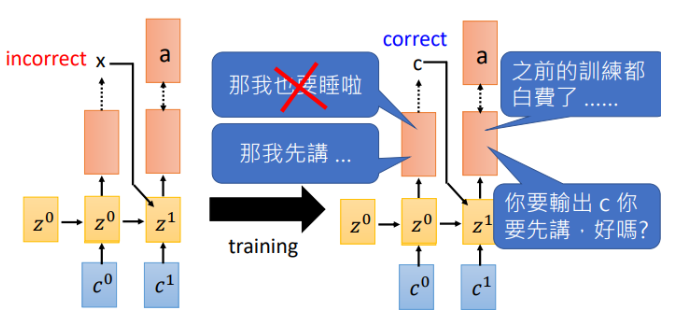
假如在\(t_0\)输出了\(x\),下一时刻机器就会学习在输入为\(x\)时我需要输出\(a\),然而等到训练的一定回合时,\(t_0\)可以做出正确的预测了,告诉机器输入\(c\)需要输出\(a\),此刻机器已经懵了,刚才不是说\(x\)对应\(a\)吗,那之前的训练就白费了。就开始互掐了。。。
- back to attention
我们在回到之前的attention操作,attention计算得到的context被用于下一时刻的输入(左图),现在还有另一种attention架构,将context直接用于当前时刻的输入(右图)
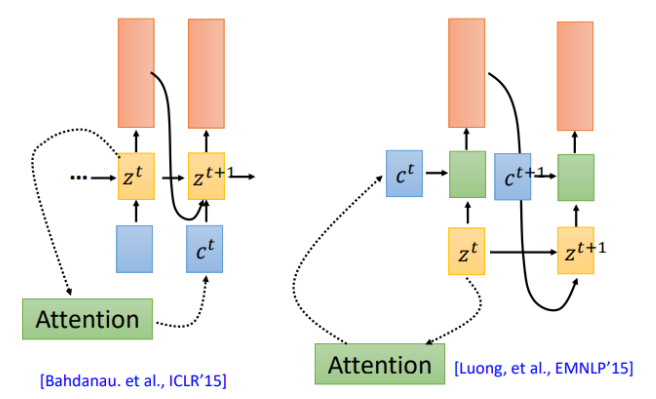
那么哪一种更有效呢?该用那个呢。第一篇使用seq2seq做语音识别的论文说:我全都要。context向量即作用于当前位置,也作用于下一位置
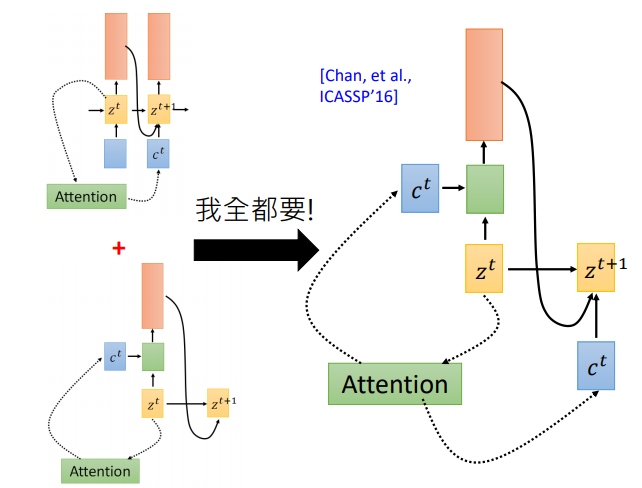
使用Attention作语音识别真的好吗?
有点杀鸡用牛刀的感觉!为好么呢,我们知道用attention的seq2seq模型首先用在机器翻译上,在翻译任务中,输入和输出没有一致的对应关系,需要attention自己寻找对应的那个词。但是对语音来说输入输出是对应的,有人提出了location-aware attention
LAS —Does it work?
刚开始的时候LAS其实打不过传统模型,后来随着训练集的增加以及各种trick,LAS已经很厉害了。可以看到刚开始的时候,打不过传统模型,2018年google在12500小时的训练集上训练,最终打败了传统模型,并没有使用location-aware attention,而且最重要的是模型变小了,从原来的7.2G变成0.4G

那LAS还有什么问题呢?
LAS采用经典的Encoder和Decoder架构,也就是说,只有在完整的听完一句话之后模型才会输出,那如果我们希望机器在听到声音的同时就输出怎么做呢?我们下节课再讲。
深度学习与人类语言处理-语音识别(part2)的更多相关文章
- 深度学习与人类语言处理-语音识别(part1)
语音识别 语音识别该何去何从? 1969年,J.R. PIERCE:"语音识别就像把水变成汽油.从大海中淘金.治疗癌症.人类登陆月球" 当然,这是50年前的想法,那么语音识别该如何 ...
- 深度学习与人类语言处理-语音识别(part3)
上节回顾深度学习与人类语言处理-语音识别(part2),这节课我们接着看seq2seq模型怎么做语音识别 上节课我们知道LAS做语音识别需要看完一个完整的序列才能输出,把我们希望语音识别模型可以在听到 ...
- 李宏毅深度学习与人类语言处理-introduction
深度学习与人类语言处理(Deep learning for Human Language Processing) 李宏毅老师深度学习与人类语言处理课程笔记,请看正文 这门课会学到什么? 为什么叫人类语 ...
- 纯干货:深度学习实现之空间变换网络-part2
https://www.jianshu.com/p/854d111670b6 纯干货:深度学习实现之空间变换网络-part1 在第一部分中,我们主要介绍了两个非常重要的概念:仿射变换和双线性插值,并了 ...
- 【PyTorch深度学习60分钟快速入门 】Part2:Autograd自动化微分
在PyTorch中,集中于所有神经网络的是autograd包.首先,我们简要地看一下此工具包,然后我们将训练第一个神经网络. autograd包为张量的所有操作提供了自动微分.它是一个运行式定义的 ...
- R语言︱H2o深度学习的一些R语言实践——H2o包
每每以为攀得众山小,可.每每又切实来到起点,大牛们,缓缓脚步来俺笔记葩分享一下吧,please~ --------------------------- R语言H2o包的几个应用案例 笔者寄语:受启发 ...
- 碎片︱R语言与深度学习
笔者:受alphago影响,想看看深度学习,但是其在R语言中的应用包可谓少之又少,更多的是在matlab和python中或者是调用.整理一下目前我看到的R语言的材料: ---------------- ...
- [翻译]深度学习的机器(The learning machines)
学习的机器 用大量的数据识别图像和语音,深度学习的计算机(deep-learning computers) 向真正意义上的人工智能迈出了一大步. Nicola Jones Computer Scien ...
- Bengio最新博文:深度学习展望
Bengio最新博文:深度学习展望 人类一直梦想着创造有智能的机器.早在第一台可编程计算机问世前100多年,发明家就对如何能让由连杆和齿轮组成的设备也变得更加智能这一命题充满好奇.后来,20世纪40年 ...
随机推荐
- python中的reduce函数
python中的reduce python中的reduce内建函数是一个二元操作函数,他用来将一个数据集合(链表,元组等)中的所有数据进行下列操作:用传给reduce中的函数 func()(必须是 ...
- Web前端性能
6.1前端性能示例 性能测试工具: Apache Benchmark(ab)得到的响应时间仅为从请求发出开始到接收到HTML的最后一个字节所消耗的全部时间.ab命令行如下: ab -c [并发用户数] ...
- Mysql错误问题:ERROR 1005 (HY000): Can't create table 'crm_1.tbl_client' (errno: 150)
MySQL外键创建条件: 1.两个表必须是InnoDB数据引擎2.外键表的外键字段必须是主键3.字段类型必须一致 创建表时创建外键: create table tbl_client(userName ...
- ES6-Set与Map数据结构
Set 实例的属性和方法 Set类似与数组,但是成员值唯一没有重复! let arr = [3, 5, 2, 2, 5, 5]; let unique = [...new Set(arr)]; // ...
- TCP\IP协议簇-分层模型
OSI 模型 数据单元 层 功能 主机层 Data(数据) 7. 应用层 网络进程到应用程序. 6. 表示层 数据表示形式,加密和解密,把机器相关的数据转换成独立于机器的数据. 5. 会话层 主机 ...
- Django中加载static无法成功的解决方法
我试着进入/admin/ 结果它的/static/ 能够正常找到目标文件…真是日了哈*奇了. 我的link标签href=/static/…. 并没有什么问题 试着在urls中加入下面代码,但是没什么用 ...
- Google在百慕大避税几十亿美金,为什么巨头和富豪都会选百慕大避税?
为什么"越有钱越有钱"?为什么富豪只要不自己"作",就能让自己的财富疯狂增加?除了经营意识之外,关键他们还可以利用自己的资源.实力等去做很多看似让人不齿,但其实 ...
- QA、EPG、PMO各自的职能划分及关系是什么?
团队 职能 主要工作内容 EPG 负责过程持续改进工作 公司规范的建设和推广,并持续改进.收集过程改进需求,制定过程改进计划,获得高层的支持,并实施改进工作. PMO 负责公司内所有项目的审核.管理 ...
- -scp Linux之间复制文件和目录
scp 简介 scp是secure copy的简写,用于在Linux下进行远程拷贝文件的命令,和它类似的命令有cp,不过cp只是在本机进行拷贝不能跨服务器,而且scp传输是加密的.可能会稍微影响一下速 ...
- LeetCode 题解 | 1. 两数之和
题目描述: 给定一个整数数组和一个目标值,找出数组中和为目标值的两个数. 你可以假设每个输入只对应一种答案,且同样的元素不能被重复利用. 示例: 给定 nums = [2, 7, 11, 15], t ...