
CentOS7 部署 Hadoop 3.2.1 (伪分布式)
CentOS: Linux localhost.localdomain 3.10.0-862.el7.x86_64 #1 SMP Fri Apr 20 16:44:24 UTC 2018 x86_64 x86_64 x86_64 GNU/Linux
JDK: Oracle jdk1.8.0_241 , https://www.oracle.com/java/technologies/javase-jdk8-downloads.html
Hadoop : hadoop-3.2.1.tar.gz
官方安装文档:https://hadoop.apache.org/docs/r3.2.1/hadoop-project-dist/hadoop-common/SingleCluster.html
1、设置自身免登陆,输入命令(红色部分)
# ssh-keygen

Generating public/private rsa key pair.

Enter file in which to save the key (/root/.ssh/id_rsa):

Enter passphrase (empty for no passphrase):

Enter same passphrase again:

Your identification has been saved in /root/.ssh/id_rsa.

Your public key has been saved in /root/.ssh/id_rsa.pub.

The key fingerprint is:

1b:e4:ff::::6a:2f:::b0:ec::fe:5b: root@localhost.localdomain

The key's randomart image is:

+--[ RSA ]----+

|         ....   .|

|        . ..   o.|

|       ..o  . o. |

|      ooo    +.  |

|       ESo  o..  |

|        o+. .o . |

|        .......  |

|          o..    |

|         .  ..   |

+-----------------+
# cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
# chmod 600 ~/.ssh/authorized_keys

# ssh root@localhost

Last login: Sun Mar  ::
2.关闭selinux、防火墙
a. 永久有效
修改 /etc/selinux/config 文件中的 SELINUX=enforcing 修改为 SELINUX=disabled ,然后重启。
b. 临时生效
# setenforce
# systemctl stop firewalld.service

# systemctl disable iptables.service
3.下载Java SDK,前往 https://www.oracle.com/java/technologies/javase-jdk8-downloads.html 下载
# mkdir /data/server/hadoop/

# cd /data/server/hadoop/

# rz #选择你下载好的文件,上传到当前目录下

# tar zxvf jdk-8u241-linux-x64.tar.gz
4. 下载Hadoop,前往https://downloads.apache.org/hadoop/common/ 选择你想要的版本,这里选最新版本3.2.1
# cd /data/server/hadoop

# wget https://downloads.apache.org/hadoop/common/hadoop-3.2.1/hadoop-3.2.1.tar.gz

# tar zxvf hadoop-3.2..tar.gz

# mv hadoop-3.2./ 3.2.
5.设置Hadoop环境变量,vi /etc/profile ,在末尾增加如下内容:
#hadoop

export HADOOP_HOME=/data/server/hadoop/3.2.

export HADOOP_HDFS_HOME=$HADOOP_HOME

export HADOOP_YARN_HOME=$HADOOP_HOME

export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop

export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin

export HDFS_DATANODE_USER=root

export HDFS_DATANODE_SECURE_USER=root

export HDFS_NAMENODE_USER=root

export HDFS_SECONDARYNAMENODE_USER=root

export YARN_RESOURCEMANAGER_USER=root

export YARN_NODEMANAGER_USER=root
再执行使变量生效
# source /etc/profile
6.设置JAVA_HOME, vi 3.2.1/etc/hadoop/hadoop-env.sh ,末尾添加如下内容:
export JAVA_HOME=/data/server/hadoop/jdk1.8.0_241
7.查看是否正常
# hadoop version

Hadoop 3.2.

Source code repository https://gitbox.apache.org/repos/asf/hadoop.git -r b3cbbb467e22ea829b3808f4b7b01d07e0bf3842

Compiled by rohithsharmaks on --10T15:56Z

Compiled with protoc 2.5.

From source with checksum 776eaf9eee9c0ffc370bcbc1888737

This command was run using /home/data/server/hadoop/3.2./share/hadoop/common/hadoop-common-3.2..jar
8.重命名启动脚本,避免和spark服务脚本冲突(可不删除cmd脚本)。
rm -rf ./3.2./sbin/*.cmd

rm -rf ./3.2.1/bin/*.cmd

mv ./3.2.1/sbin/start-all.sh ./3.2.1/sbin/start-hadoop-all.sh

mv ./3.2.1/sbin/stop-all.sh ./3.2.1/sbin/stop-hadoop-all.sh
Hadoop设置
编辑 3.2.1/etc/hadoop/core-site.xml :
<configuration>

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://172.16.1.122:9000</value>

        <description>指定HDFS Master(namenode)的通信地址,默认端口</description>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/data/server/hadoop/3.2.1/tmp</value>

        <description>指定hadoop运行时产生文件的存储路径</description>

    </property>

    <property>

        <name>hadoop.native.lib</name>

        <value>false</value>

        <description>是否应使用本机hadoop库(如果存在)</description>

    </property>

</configuration>
编辑 3.2.1/etc/hadoop/hdfs-site.xml(参考:https://www.cnblogs.com/duanxz/p/3799467.html) :
<configuration>

    <property>

        <name>dfs.replication</name>

        <value>1</value>

        <description>设置数据块应该被复制的份数</description>

    </property>

    <property>

        <name>dfs.safemode.threshold.pct</name>

        <value>0</value>

        <description>小于等于0意味不进入安全模式,大于1意味一直处于安全模式</description>

    </property>

    <property>

        <name>dfs.permissions</name>

        <value>false</value>

        <description>文件操作时的权限检查标识, 关闭</description>

    </property>

</configuration>
编辑 3.2.1/etc/hadoop/yarn-site.xml (参考:https://www.cnblogs.com/yinchengzhe/p/5142659.html):
<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

        <description>NodeManager上运行的附属服务。需配置成mapreduce_shuffle,才可运行MapReduce程序</description>

    </property>

    <property>

        <name>yarn.nodemanager.env-whitelist</name>

        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>

    </property>

</configuration>
编辑 3.2.1/etc/hadoop/mapred-site.xml :
<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

        <description>yarn模式</description>

    </property>

    <property>

        <name>yarn.nodemanager.env-whitelist</name>

        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>

    </property>

</configuration>
格式化hdfs
# hdfs namenode -format
启动hadoop
# start-hadoop-all.sh
查看启动情况(红色部分)
# /data/server/hadoop/jdk1..0_241/bin/jps

20400 NodeManager

 QuorumPeerMain

20054 SecondaryNameNode

19687 NameNode

 Jps

19817 DataNode

18108 ResourceManager
至此,hadoop启动成功;
验证hadoop
下面运行一次经典的WorkCount程序来检查hadoop工作是否正常:
创建input文件夹:
# hdfs dfs -mkdir /input
将test.txt文件上传的hdfs的/input目录下:
# hdfs dfs -put ./3.2./LICENSE.txt /input/test.txt
接运行hadoop安装包中自带的workcount程序:
hadoop jar ./3.2./share/hadoop/mapreduce/hadoop-mapreduce-examples-3.2..jar wordcount /input/test.txt /output/
控制台输出结果:
-- ::, INFO client.RMProxy: Connecting to ResourceManager at /172.16.1.122:

-- ::, INFO mapreduce.JobResourceUploader: Disabling Erasure Coding for path: /tmp/hadoop-yarn/staging/root/.staging/job_1585465225552_0004

-- ::, INFO sasl.SaslDataTransferClient: SASL encryption trust check: localHostTrusted = false, remoteHostTrusted = false

-- ::, INFO input.FileInputFormat: Total input files to process :

-- ::, INFO sasl.SaslDataTransferClient: SASL encryption trust check: localHostTrusted = false, remoteHostTrusted = false

-- ::, INFO sasl.SaslDataTransferClient: SASL encryption trust check: localHostTrusted = false, remoteHostTrusted = false

-- ::, INFO mapreduce.JobSubmitter: number of splits:

-- ::, INFO sasl.SaslDataTransferClient: SASL encryption trust check: localHostTrusted = false, remoteHostTrusted = false

-- ::, INFO mapreduce.JobSubmitter: Submitting tokens for job: job_1585465225552_0004

-- ::, INFO mapreduce.JobSubmitter: Executing with tokens: []

-- ::, INFO conf.Configuration: resource-types.xml not found

-- ::, INFO resource.ResourceUtils: Unable to find 'resource-types.xml'.

-- ::, INFO impl.YarnClientImpl: Submitted application application_1585465225552_0004

-- ::, INFO mapreduce.Job: The url to track the job: http://172.16.1.122:8088/proxy/application_1585465225552_0004/

-- ::, INFO mapreduce.Job: Running job: job_1585465225552_0004

-- ::, INFO mapreduce.Job: Job job_1585465225552_0004 running in uber mode : false

-- ::, INFO mapreduce.Job:  map % reduce %

-- ::, INFO mapreduce.Job:  map % reduce %

-- ::, INFO mapreduce.Job:  map % reduce %

-- ::, INFO mapreduce.Job: Job job_1585465225552_0004 completed successfully

-- ::, INFO mapreduce.Job: Counters:

    File System Counters

        FILE: Number of bytes read=

        FILE: Number of bytes written=

        FILE: Number of read operations=

        FILE: Number of large read operations=

        FILE: Number of write operations=

        HDFS: Number of bytes read=

        HDFS: Number of bytes written=

        HDFS: Number of read operations=

        HDFS: Number of large read operations=

        HDFS: Number of write operations=

        HDFS: Number of bytes read erasure-coded=

    Job Counters

        Launched map tasks=

        Launched reduce tasks=

        Data-local map tasks=

        Total time spent by all maps in occupied slots (ms)=

        Total time spent by all reduces in occupied slots (ms)=

        Total time spent by all map tasks (ms)=

        Total time spent by all reduce tasks (ms)=

        Total vcore-milliseconds taken by all map tasks=

        Total vcore-milliseconds taken by all reduce tasks=

        Total megabyte-milliseconds taken by all map tasks=

        Total megabyte-milliseconds taken by all reduce tasks=

    Map-Reduce Framework

        Map input records=

        Map output records=

        Map output bytes=

        Map output materialized bytes=

        Input split bytes=

        Combine input records=

        Combine output records=

        Reduce input groups=

        Reduce shuffle bytes=

        Reduce input records=

        Reduce output records=

        Spilled Records=

        Shuffled Maps =

        Failed Shuffles=

        Merged Map outputs=

        GC time elapsed (ms)=

        CPU time spent (ms)=

        Physical memory (bytes) snapshot=

        Virtual memory (bytes) snapshot=

        Total committed heap usage (bytes)=

        Peak Map Physical memory (bytes)=

        Peak Map Virtual memory (bytes)=

        Peak Reduce Physical memory (bytes)=

        Peak Reduce Virtual memory (bytes)=

    Shuffle Errors

        BAD_ID=

        CONNECTION=

        IO_ERROR=

        WRONG_LENGTH=

        WRONG_MAP=

        WRONG_REDUCE=

    File Input Format Counters

        Bytes Read=

    File Output Format Counters

        Bytes Written=
查看输出结果:
# hdfs dfs -ls /output
可见hdfs的/output目录下,有两个文件:
Found  items

-rw-r--r--    root supergroup           -- : /output/_SUCCESS

-rw-r--r--    root supergroup       -- : /output/part-r-
看一下文件part-r-00000的内容:
# hdfs dfs -cat /output/part-r-

hadoop

hbase

hive

mapreduce

spark

sqoop

storm
可见WorkCount计算成功,结果符合预期;
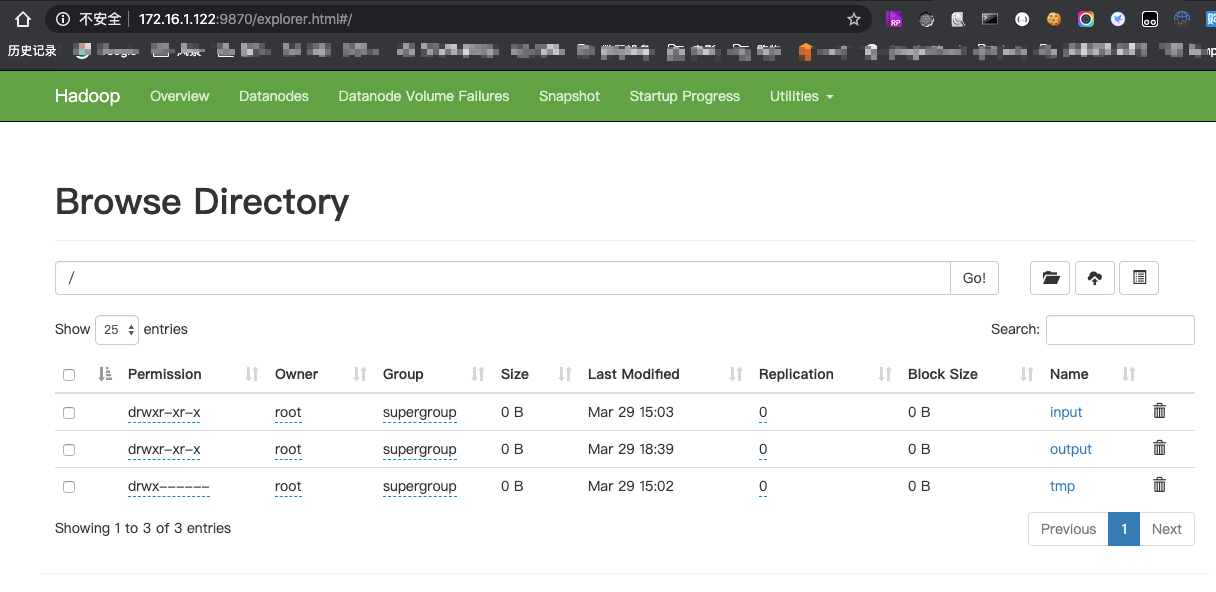
7. hdfs网页如下图,可以看到文件信息,地址:http://172.16.1.122:9870/
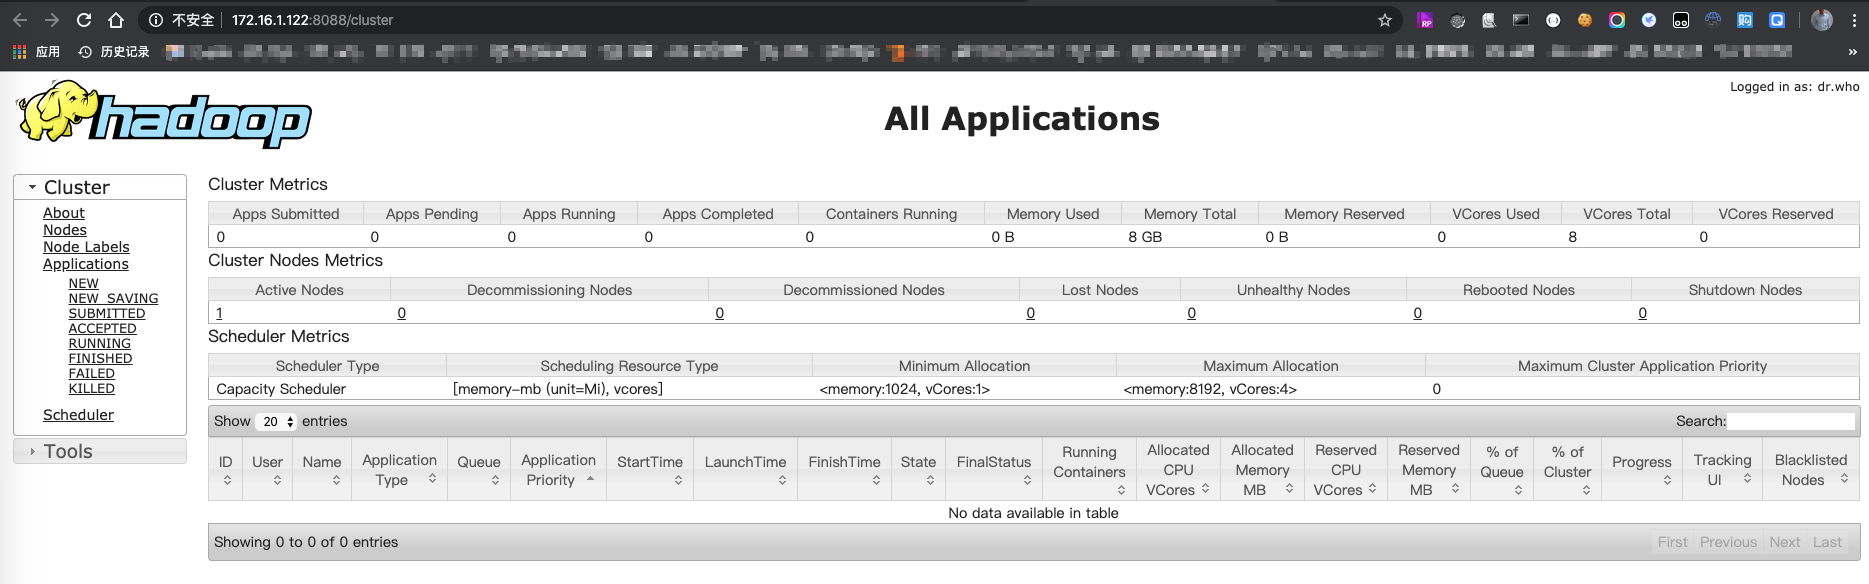
8. yarn的网页如下图,可以看到任务信息,地址:http://172.16.1.122:8088/cluster
至此,hadoop3.2.1伪分布式搭建和验证完毕。
PS:
https://blog.csdn.net/u010476739/article/details/86647585?depth_1-utm_source=distribute.pc_relevant.none-task&utm_source=distribute.pc_relevant.none-task
https://blog.csdn.net/lu1171901273/article/details/86518494
https://blog.csdn.net/chenxun_2010/article/details/78238251
https://www.cnblogs.com/jancco/p/4447756.html
https://blog.csdn.net/pengjunlee/article/details/104290537
CentOS7 部署 Hadoop 3.2.1 (伪分布式)的更多相关文章
- hadoop 2.7.3伪分布式安装
hadoop 2.7.3伪分布式安装 hadoop集群的伪分布式部署由于只需要一台服务器,在测试,开发过程中还是很方便实用的,有必要将搭建伪分布式的过程记录下来,好记性不如烂笔头. hadoop 2. ...
- hadoop 2.7.3伪分布式环境运行官方wordcount
hadoop 2.7.3伪分布式模式运行wordcount 基本环境: 系统:win7 虚机环境:virtualBox 虚机:centos 7 hadoop版本:2.7.3 本次以伪分布式模式来运行w ...
- Hadoop 在windows 上伪分布式的安装过程
第一部分:Hadoop 在windows 上伪分布式的安装过程 安装JDK 1.下载JDK http://www.oracle.com/technetwork/java/javaee/d ...
- Hadoop Single Node Setup(hadoop本地模式和伪分布式模式安装-官方文档翻译 2.7.3)
Purpose(目标) This document describes how to set up and configure a single-node Hadoop installation so ...
- Hadoop生态圈-hbase介绍-伪分布式安装
Hadoop生态圈-hbase介绍-伪分布式安装 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HBase简介 HBase是一个分布式的,持久的,强一致性的存储系统,具有近似最 ...
- centos 7下Hadoop 2.7.2 伪分布式安装
centos 7 下Hadoop 2.7.2 伪分布式安装,安装jdk,免密匙登录,配置mapreduce,配置YARN.详细步骤如下: 1.0 安装JDK 1.1 查看是否安装了openjdk [l ...
- 安装部署Apache Hadoop (本地模式和伪分布式)
本节内容: Hadoop版本 安装部署Hadoop 一.Hadoop版本 1. Hadoop版本种类 目前Hadoop发行版非常多,有华为发行版.Intel发行版.Cloudera发行版(CDH)等, ...
- Hadoop + Hive + HBase + Kylin伪分布式安装
问题导读 1. Centos7如何安装配置? 2. linux网络配置如何进行? 3. linux环境下java 如何安装? 4. linux环境下SSH免密码登录如何配置? 5. linux环境下H ...
- Hadoop环境搭建 (伪分布式搭建)
一,Hadoop版本下载 建议下载:Hadoop2.5.0 (虽然是老版本,但是在企业级别中运用非常稳定,新版本虽然添加了些小功能但是版本稳定性有带与考核) 1.下载地址: hadoop.apache ...
随机推荐
- ES6学习总结(五)
与其说是对象合并,还不如说是JavaScript中对象属性的复制和转移,将多个对象中的属性合并到一个对象中 12345678 var person = { name : 'John', age : 2 ...
- Activity源码解析 - 读书笔记
1. Activity启动 Activity是一个比较好的模板方法模式.在Android系统启动时,第一个启动的进程是zygote进程,然后由zygote启动SystemServer,再后就是启动AW ...
- 在博客中显示图片_Mac版
主要是防止自己忘掉 为了解决一开始自己想在写入的博客中添加本地图片,直接链接的话在自己的电脑倒是可以显示图片,但是在别人的电脑上就没办法加载图片了,问各路大神也没人愿意解答,百度也没有想要的答案,只好 ...
- 代工黑马,纬创如何强吞iPhone?
现在,智能手机市场非常得意兴阑珊,以苹果为首的最强大脑似乎再也想不出什么好的创意,iPhone7也只不过是旧机种的翻新款式,看上去跟一块板砖.一块镜子差不多:软体方面则出现了大批的"过度 ...
- Flink命令行提交job (源码分析)
这篇文章主要介绍从命令行到任务在Driver端运行的过程 通过flink run 命令提交jar包运行程序 以yarn 模式提交任务命令类似于: flink run -m yarn-cluster X ...
- 制作UEFI(64位)下的WinPE + Ubuntu + Acronis多启动U盘
最近研究了一下如何制作一个多启动U盘,其中想包含的功能是WinPE(这里选择WEPE),Ubuntu 18.04,Acronis True Image 2018的ISO恢复盘.这里分享一下制作的经验和 ...
- Docker实战之Zookeeper集群
1. 概述 这里是 Docker 实战系列第四篇.主要介绍分布式系统中的元老级组件 Zookeeper. ZooKeeper 是一个开源的分布式协调服务,是 Hadoop,HBase 和其他分布式框架 ...
- Angular 1 深度解析:脏数据检查与 angular 性能优化
TL;DR 脏检查是一种模型到视图的数据映射机制,由 $apply 或 $digest 触发. 脏检查的范围是整个页面,不受区域或组件划分影响 使用尽量简单的绑定表达式提升脏检查执行速度 尽量减少页面 ...
- 【开发技巧】再见,BLE的那些坑!
蓝牙,平常你用的多吗?上班路上戴着蓝牙耳机听音乐.看视频打开蓝牙分享个人热点给小伙伴们解锁共享单车时,打开蓝牙就能迅速解锁...... BLE-蓝牙低能耗技术,方便了我们的生活,但是开发者在开发过程中 ...
- 动手搞一个Promise
Javascript语言的执行环境是"单线程"(single thread).所谓"单线程",就是指一次只能完成一件任务.如果有多个任务,就必须排队,前面一个任 ...