
scrapy处理post请求的传参和日志等级
一.Scrapy的日志等级
- 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息。
- 日志信息的种类:
        ERROR : 一般错误

        WARNING : 警告

        INFO : 一般的信息

        DEBUG : 调试信息
- 设置日志信息指定输出:
在settings.py配置文件中,加入
LOG_LEVEL = ‘指定日志信息种类’即可。
LOG_FILE = 'log.txt'则表示将日志信息写入到指定文件中进行存储。
二.请求传参
- 在某些情况下,我们爬取的数据不在同一个页面中,例如,我们爬取一个电影网站,电影的名称,评分在一级页面,而要爬取的其他电影详情在其二级子页面中。这时我们就需要用到请求传参。
处理post请求的参数:
创建项目:

代码:
import scrapy

class PostSpider(scrapy.Spider):

    name = 'post'

    # allowed_domains = ['www.xxx.com']

    start_urls = ['https://fanyi.baidu.com/sug']

    def start_requests(self):

        data = {

            'kw':'dog'

        }

        for url in self.start_urls:

            yield scrapy.FormRequest(url=url,formdata=data,callback=self.parse)

    def parse(self, response):

        print(response.text)
settings.py
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.119 Safari/537.36'

# Obey robots.txt rules

ROBOTSTXT_OBEY = False
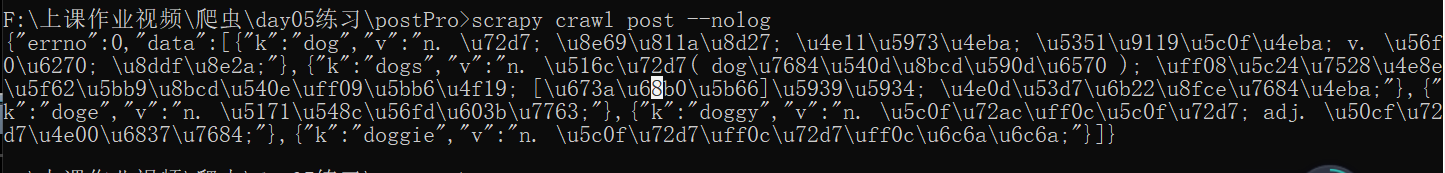
查看请求的数据:
案例二:
# -*- coding: utf-8 -*-

import scrapy

from moviePro.items import MovieproItem

class MovieSpider(scrapy.Spider):

    name = 'movie'

    # allowed_domains = ['www.xxx.com']

    start_urls = ['https://www.4567tv.tv/frim/index1.html']

    #解析详情页中的数据

    def parse_detail(self,response):

        #response.meta返回接收到的meta字典

        item = response.meta['item']

        actor = response.xpath('/html/body/div[1]/div/div/div/div[2]/p[3]/a/text()').extract_first()

        item['actor'] = actor

        yield item

    def parse(self, response):

        li_list = response.xpath('//li[@class="col-md-6 col-sm-4 col-xs-3"]')

        for li in li_list:

            item = MovieproItem()

            name = li.xpath('./div/a/@title').extract_first()

            detail_url = 'https://www.4567tv.tv'+li.xpath('./div/a/@href').extract_first()

            item['name'] = name

            #meta参数:请求传参.meta字典就会传递给回调函数的response参数

            yield scrapy.Request(url=detail_url,callback=self.parse_detail,meta={'item':item})
settings.py

LOG_LEVEL = "ERROE"

LOG_FILE = './log.txt'    #输出日志
items.py
# -*- coding: utf-8 -*-

# Define here the models for your scraped items

#

# See documentation in:

# https://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class MoveproItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    name = scrapy.Field()

    actor = scrapy.Field()
scrapy处理post请求的传参和日志等级的更多相关文章
- SpringBoot 2.x (2):请求和传参
其实请求和传参这些知识属于SpringMVC 不过这也属于必须掌握的知识,巩固基础吧 GET请求: 以第一篇文章自动的方式创建SpringBoot项目: 然后新建Controller: package ...
- vue 使用 axios 时 post 请求方法传参无法发送至后台
axios 时 post 请求方法传参无法发送至后台报错如下 Response to preflight request doesn't pass access control check: No ' ...
- http请求与传参
这并不算是文章,暂时只做粗略地记录,以免忘记,因此会显得杂乱无章,随便抓了几个包和对postman截图,日后有空再完善 1.get方式 只有一种方式,那就是在url后面跟参数 2.post方式 1)表 ...
- vue axios传参报错的解决方法
今天有人问同一套后台系统为什么jquery可以正常使用,axios却报错呢,下面总结如下: 总的来说是jquery和axios传参类型不同,那为什么jquery和axios请求时传参类型不同? 1)j ...
- SpringMVC前后端分离交互传参详细教程
温故而知新,本文为一时兴起写出,如有错误还请指正 本文后台基于SpringBoot2.5.6编写,前端基于Vue2 + axios和微信小程序JS版分别编写进行联调测试,用于理解前后端分离式开发的交互 ...
- 13.scrapy框架的日志等级和请求传参
今日概要 日志等级 请求传参 如何提高scrapy的爬取效率 今日详情 一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是s ...
- scrapy框架的日志等级和请求传参
日志等级 请求传参 如何提高scrapy的爬取效率 一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息 ...
- scrapy框架之日志等级和请求传参-cookie-代理
一.Scrapy的日志等级 - 在使用scrapy crawl spiderFileName运行程序时,在终端里打印输出的就是scrapy的日志信息. - 日志信息的种类: ERROR : 一般错误 ...
- Scrapy的日志等级和请求传参
日志等级 日志信息: 使用命令:scrapy crawl 爬虫文件 运行程序时,在终端输出的就是日志信息: 日志信息的种类: ERROR:一般错误: WARNING:警告: INFO:一般的信息: ...
随机推荐
- leetcode 27. 移除元素(python)
1. 题目描述 给定一个数组 nums 和一个值 val,你需要原地移除所有数值等于 val 的元素,返回移除后数组的新长度. 不要使用额外的数组空间,你必须在原地修改输入数组并在使用 O(1) 额外 ...
- 阶段3 1.Mybatis_09.Mybatis的多表操作_8 mybatis多对多操作-查询角色获取角色下所属用户信息
一个角色对应多个用户 生成getter和setter 查看两个表的数据 中间表定义了谁有角色,谁没有角色 根据中间表的关系,最终查询出来的列表的数据样子.这需要两个左外链接才能实现功能. 第一个左外链 ...
- oracle ogg--ogg搭建过程中遇到的错误及处理
1 PRVF-0002 : Could not retrieve local nodename---# Begin Stacktrace #---------------------------ID: ...
- 【MyBatis】-----初识【MyBatis】
一.核心配置文件 <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration ...
- wsl 下安装docker
docker for windows本身其实是可以直接用的,但是仍然有很多不足,比如说:权限问题.没有docker.sock文件.文件编码问题等.而win10自带的wsl可以非常完美地解决这些问题. ...
- 【转载】PHP中foreach的用法
http://www.php.cn/php-weizijiaocheng-399438.html 很好用的PHP中foreach的用法详解,收藏!
- ARP协议基础
ARP 什么是ARP协议 ARP协议是能够根据IP地址解析出该IP地址所在设备的MAC地址,叫(Address Resolution Protocol)地址解析协议 ARP地址的工作流程 当一台主机A ...
- 【Linux开发】如何在./configure的时候将编译参数传入,改变默认的编译器gcc成arm-linux-gcc
如何在configure时,将编译参数传入,改变默认的编译器gcc成arm-linux-gcc [问题] 想要用交叉编译工具arm-linux-gcc去编译lrzsz, 但是在./configure的 ...
- git.ZC一套命令_稀疏签出(sparse-checkout)
1. git init git remote add origin https://gitee.com/?????/movieHome.git git config core.sparsechecko ...
- linux/linux学习笔记-初识linux(mooc)
一.linux简介 linux版本:内核版本和发行版本 linux企业应用: 1.基于linux的企业服务器 2.linux在嵌入式领域应用 android底层Linux : ios底层unix li ...