
【深度学习】之Caffe的solver文件配置(转载自csdn)
原文: http://blog.csdn.net/czp0322/article/details/52161759
今天在做FCN实验的时候,发现solver.prototxt文件一直用的都是model里自带的,一直都对里面的参数不是很了解,所以今天认真学习了一下里面各个参数的意义。
DL的任务中,几乎找不到解析解,所以将其转化为数学中的优化问题。sovler的主要作用就是交替调用前向传导和反向传导 (forward & backward) 来更新神经网络的连接权值,从而达到最小化loss,实际上就是迭代优化算法中的参数。
Caffe的solver类提供了6种优化算法,配置文件中可以通过type关键字设置:
- Stochastic Gradient Descent (type: “SGD”)
- AdaDelta (type: “AdaDelta”)
- Adaptive Gradient (type: “AdaGrad”)
- Adam (type: “Adam”)
- Nesterov’s Accelerated Gradient (type: “Nesterov”)
- RMSprop (type: “RMSProp”)
简单地讲,solver就是一个告诉caffe你需要网络如何被训练的一个配置文件。
Solver.prototxt 流程
- 首先设计好需要优化的对象,以及用于学习的训练网络和测试网络的prototxt文件(通常是train.prototxt和test.prototxt文件)
- 通过forward和backward迭代进行优化来更新参数
- 定期对网络进行评价
- 优化过程中显示模型和solver的状态
solver参数
base_lr
这个参数代表的是此网络最开始的学习速率(Beginning Learning rate),一般是个浮点数,根据机器学习中的知识,lr过大会导致不收敛,过小会导致收敛过慢,所以这个参数设置也很重要。
lr_policy
这个参数代表的是learning rate应该遵守什么样的变化规则,这个参数对应的是字符串,选项及说明如下:
- “step” - 需要设置一个stepsize参数,返回base_lr * gamma ^ ( floor ( iter / stepsize ) ),iter为当前迭代次数
- “multistep” - 和step相近,但是需要stepvalue参数,step是均匀等间隔变化,而multistep是根据stepvalue的值进行变化
- “fixed” - 保持base_lr不变
- “exp” - 返回base_lr * gamma ^ iter, iter为当前迭代次数
- “poly” - 学习率进行多项式误差衰减,返回 base_lr ( 1 - iter / max_iter ) ^ ( power )
- “sigmoid” - 学习率进行sigmod函数衰减,返回 base_lr ( 1/ 1+exp ( -gamma * ( iter - stepsize ) ) )
gamma
这个参数就是和learning rate相关的,lr_policy中包含此参数的话,需要进行设置,一般是一个实数。
stepsize
This parameter indicates how often (at some iteration count) that we should move onto the next “step” of training. This value is a positive integer.
stepvalue
This parameter indicates one of potentially many iteration counts that we should move onto the next “step” of training. This value is a positive integer. There are often more than one of these parameters present, each one indicated the next step iteration.
max_iter
最大迭代次数,这个数值告诉网络何时停止训练,太小会达不到收敛,太大会导致震荡,为正整数。
momentum
上一次梯度更新的权重,real fraction
weight_decay
权重衰减项,用于防止过拟合。
solver_mode
选择CPU训练或者GPU训练。
snapshot
训练快照,确定多久保存一次model和solverstate,positive integer。
snapshot_prefix
snapshot的前缀,就是model和solverstate的命名前缀,也代表路径。
net
path to prototxt (train and val)
test_iter
每次test_interval的test的迭代次数,假设测试样本总数为10000张图片,一次性执行全部的话效率很低,所以将测试数据分为几个批次进行测试,每个批次的数量就是batch_size。如果batch_size=100,那么需要迭代100次才能将10000个数据全部执行完,所以test_iter设置为100。
test_interval
测试间隔,每训练多少次进行一次测试。
display
间隔多久对结果进行输出
iter_size
这个参数乘上train.prototxt中的batch size是你实际使用的batch size。 相当于读取batchsize * itersize个图像才做一下gradient decent。 这个参数可以规避由于gpu内存不足而导致的batchsize的限制 因为你可以用多个iteration做到很大的batch 即使单次batch有限。
average_loss
取多次foward的loss作平均,进行显示输出。
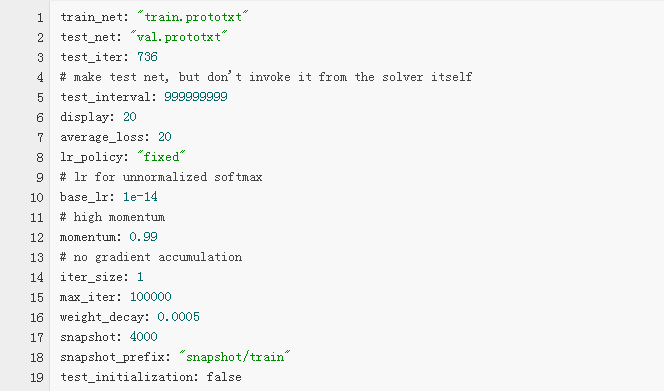
FCN的solver.prototxt文件
【深度学习】之Caffe的solver文件配置(转载自csdn)的更多相关文章
- 【转】Caffe的solver文件配置
http://blog.csdn.net/czp0322/article/details/52161759 solver.prototxt 今天在做FCN实验的时候,发现solver.prototxt ...
- 深度学习框架Caffe的编译安装
深度学习框架caffe特点,富有表达性.快速.模块化.下面介绍caffe如何在Ubuntu上编译安装. 1. 前提条件 安装依赖的软件包: CUDA 用来使用GPU模式计算. 建议使用 7.0 以上最 ...
- 深度学习框架-caffe安装-环境[Mac OSX 10.12]
深度学习框架-caffe安装 [Mac OSX 10.12] [参考资源] 1.英文原文:(使用GPU) [http://hoondy.com/2015/04/03/how-to-install-ca ...
- 深度学习框架-caffe安装-Mac OSX 10.12
p.p1 { margin: 0.0px 0.0px 0.0px 0.0px; font: 12.0px ".PingFang SC"; color: #454545 } p.p2 ...
- 常用深度学习框——Caffe/ TensorFlow / Keras/ PyTorch/MXNet
常用深度学习框--Caffe/ TensorFlow / Keras/ PyTorch/MXNet 一.概述 近几年来,深度学习的研究和应用的热潮持续高涨,各种开源深度学习框架层出不穷,包括Tenso ...
- Caffe学习系列(7):solver及其配置
solver算是caffe的核心的核心,它协调着整个模型的运作.caffe程序运行必带的一个参数就是solver配置文件.运行代码一般为 # caffe train --solver=*_slover ...
- caffe(7) solver及其配置
solver算是caffe的核心的核心,它协调着整个模型的运作.caffe程序运行必带的一个参数就是solver配置文件.运行代码一般为 # caffe train --solver=*_slover ...
- 【神经网络与深度学习】Caffe使用step by step:caffe框架下的基本操作和分析
caffe虽然已经安装了快一个月了,但是caffe使用进展比较缓慢,果然如刘老师说的那样,搭建起来caffe框架环境比较简单,但是完整的从数据准备->模型训练->调参数->合理结果需 ...
- 开源深度学习架构Caffe
Caffe 全称为 Convolutional Architecture for Fast Feature Embedding,是一个被广泛使用的开源深度学习框架(在 TensorFlow 出现之前一 ...
随机推荐
- 关于iOS导航控制器隐藏和显示会出现返回键失效,导航栏标题动画异常
最近做的demo bug出现了,我觉得这个bug出现得很经典所以贴出来给大家看看, bug演示就是:点击返回键失效出现如下gif图演示的内容 为啥会出现如此奇葩的bug,系统的返回键居然失效了,尴尬 ...
- MFC之TreeCtrl控件使用经验总结
树形控件可以用于树形的结构,其中有一个根接点(Root)然后下面有许多子结点,而每个子结点上有允许有一个或多个或没有子结点.MFC中使用CTreeCtrl类来封装树形控件的各种操作.通过调用BOOL ...
- JAVA双列集合HashMap
HashMap 双列集合HashMap是属于java集合框架3大类接口的Map类, Map接口储存一组成对的键-值对象,提供key(键)到value(值)的映射.Map中的key不要求有序,不允许 ...
- 对于undefined和null,还有处理这一类的数组
var total=0; var data=new Array(5);//定义了data数组,length为5,但是都是元素都是undefined. for(i=0;i<data.length; ...
- 安装ant问题
1 设置path, 在windwos 7下要重启 2 重启后,cmd----ant -version Unable to locate tools.jar. Expected to find i ...
- Linux中vim的简单配置
本文主要分享Linux中vim的简单配置 ★配置文件的位置 在目录/etc.下面,有个名为vimrc的文件,这就是系统中公共的vim配置文件,对所有用户都开放.而在每个用户的主目录下,都可以自 ...
- NPOI 数据导入导出
{ //数据导入 OpenFileDialog open = new OpenFileDialog(); open.Filter = "Excle文件|*.xls"; open.T ...
- python bytes to string
python bytes 转化成 string 会遇到如下错误: codec can't decode byte 0xff in position 5: illegal multibyte seque ...
- shader forge卡通渲染!
自从用了shader forge,妈妈我再也不写shader了...... 写了3种,分别用的顶点法线.法线贴图.顶点法线+法线贴图,然后还有自发光和受光两种模式,那就是6种了吧... 最后来一张sh ...
- css声明应用优先级
1.特殊性 选择器的特殊值由四部分组成:0,0,0,0 第一位预留给内联样式 <h1 style="color:red;"></h1> 第二位属于ID选 ...