
hadoop2.7.3+spark2.1.0+scala2.12.1环境搭建(4)SPARK 安装
hadoop2.7.3+spark2.1.0+scala2.12.1环境搭建(4)SPARK 安装
一、依赖文件安装
1.1 JDK
参见博文:http://www.cnblogs.com/liugh/p/6623530.html
1.2 Hadoop
参见博文:http://www.cnblogs.com/liugh/p/6624872.html
1.3 Scala
参见博文:http://www.cnblogs.com/liugh/p/6624491.html
二、文件准备
spark-2.1.0-bin-hadoop2.7.tgz
下载地址:http://spark.apache.org/downloads.html
三、工具准备
3.1 Xshell
3.2 Xftp
四、部署图
master:192.168.136.128
slave:192.168.136.129
slave:192.168.136.130
五、Spark安装
以下操作,均使用root用户
5.1 通过Xftp将下载下来的Spark安装文件上传到Master及两个Slave的/usr目录下
5.2 通过Xshell连接到虚拟机,在Master及两个Slave上,执行如下命令,解压文件:
# tar zxvf spark-2.1.0-bin-hadoop2.7.tgz
5.3 在Master上,使用Vi编辑器,设置环境变量
# vi /etc/profile
在文件最后,添加如下内容:
#Spark Env

export SPARK_HOME=/usr/spark-2.1.0

export PATH=PATH:PATH:SPARK_HOME/bin:$SPARK_HOME/sbin
5.4 退出vi编辑器,使环境变量设置立即生效
# source /etc/profile
通过scp命令,将/etc/profile拷贝到两个Slave节点:
#scp /etc/profile root@DEV-SH-MAP-02:/etc
#scp /etc/profile root@DEV-SH-MAP-03:/etc
分别在两个Salve节点上执行# source /etc/profile使其立即生效
六、Spark配置
以下操作均在Master节点,配置完后,使用scp命令,将配置文件拷贝到两个Worker节点即可。
切换到/usr/spark-2.1.0/conf/目录下,修改如下文件:
6.1 spark-env.sh
将spark-env.sh.template重命名为spark-env.sh
#mv spark-env.sh.template spark-env.sh
使用vi编辑器,打开spark-env.sh,在文件最后,添加如下内容:
export JAVA_HOME=/usr/jdk1.8.0_121

export SCALA_HOME=/usr/scala-2.12.1

export SPARK_MASTER_IP=10.10.0.1

export SPARK_WORKER_MEMORY=1g

export HADOOP_CONF_DIR=/usr/hadoop-2.7.3/etc/hadoop
6.2 slaves
将slaves.template重命名为slaves
#mv slaves.template slaves
使用vi编辑器,打开slaves,在文件最后,添加如下内容:
DEV-SH-MAP-01

DEV-SH-MAP-02

DEV-SH-MAP-03
6.3 拷贝配置文件到两个Worker节点
在Master节点,执行如下命令:
# scp -r /usr/spark-2.1.0/conf/ root@DEV-SH-MAP-02:/usr/spark-2.1.0/
# scp -r /usr/spark-2.1.0/conf/ root@DEV-SH-MAP-03:/usr/spark-2.1.0/
七、Spark使用
7.1 启动Hadoop集群
参见博文:http://www.cnblogs.com/liugh/p/6624872.html
7.2 启动Master节点
Master节点上,执行如下命令:
#start-master.sh
使用jps命令,查看Java进程:
34225 SecondaryNameNode

33922 NameNode49702 Jps

34632 NodeManager

34523 ResourceManager

34028 DataNode

36415 Master
7.3 启动Worker节点
Master节点上,执行如下命令:
#start-slaves.sh
使用jps命令,查看Java进程:

34225 SecondaryNameNode

33922 NameNode

36562 Worker

49702 Jps

34632 NodeManager

34523 ResourceManager

34028 DataNode

36415 Master
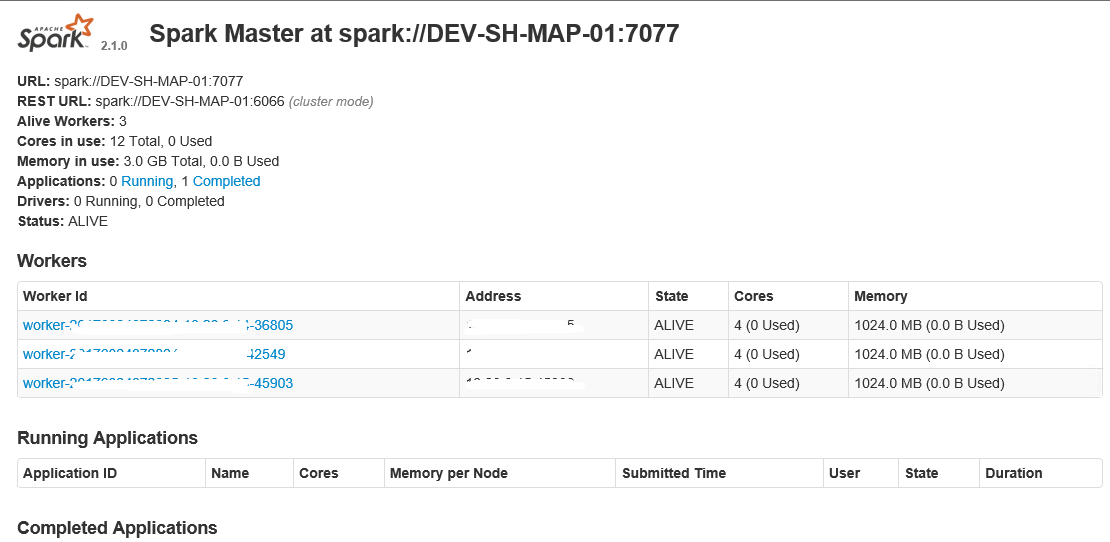
7.4 通过浏览器查看Spark信息
浏览器中,输入http://10.10.0.1:8080
7.5 停止Master及Workder节点
#stop-master.sh
#stop-slaves.sh
hadoop2.7.3+spark2.1.0+scala2.12.1环境搭建(4)SPARK 安装的更多相关文章
- hadoop2.7.3+spark2.1.0+scala2.12.1环境搭建(3)http://www.cnblogs.com/liugh/p/6624491.html
一.文件准备 scala-2.12.1.tgz 下载地址: http://www.scala-lang.org/download/2.12.1.html 二.工具准备 2.1 Xshell 2.2 X ...
- hadoop2.7.3+spark2.1.0+scala2.12.1环境搭建(2)安装hadoop
一.依赖安装 安装JDK 二.文件准备 hadoop-2.7.3.tar.gz 2.2 下载地址 http://hadoop.apache.org/releases.html 三.工具准备 3.1 X ...
- hadoop2.7.3+spark2.1.0+scala2.12.1环境搭建(1)安装jdk
一.文件准备 下载jdk-8u131-linux-x64.tar.gz 二.工具准备 2.1 Xshell 2.2 Xftp 三.操作步骤 3.1 解压文件: $ tar zxvf jdk-8u131 ...
- Hadoop2.7.3+Spark2.1.0完全分布式集群搭建过程
1.选取三台服务器(CentOS系统64位) 114.55.246.88 主节点 114.55.246.77 从节点 114.55.246.93 从节点 之后的操作如果是用普通用户操作的话也必须知道r ...
- Hadoop2.7.3+Spark2.1.0 完全分布式环境 搭建全过程
一.修改hosts文件 在主节点,就是第一台主机的命令行下; vim /etc/hosts 我的是三台云主机: 在原文件的基础上加上; ip1 master worker0 namenode ip2 ...
- Apache Spark1.1.0部署与开发环境搭建
Spark是Apache公司推出的一种基于Hadoop Distributed File System(HDFS)的并行计算架构.与MapReduce不同,Spark并不局限于编写map和reduce ...
- Windows Server 2003 IIS6.0+PHP5(FastCGI)+MySQL5环境搭建教程
准备篇 一.环境说明: 操作系统:Windows Server 2003 SP2 32位 PHP版本:php 5.3.14(我用的php 5.3.10安装版) MySQL版本:MySQL5.5.25 ...
- Cocos2dx-3.0版本 从开发环境搭建(Win32)到项目移植Android平台过程详解
作为重量级的跨平台开发的游戏引擎,Cocos2d-x在现今的手游开发领域占有重要地位.那么问题来了,作为Cocos2dx的学习者,它的可移植特性我们就需要掌握,要不然总觉得少一门技能.然而这个时候各种 ...
- SDL2.0的VS开发环境搭建
SDL2.0的VS开发环境搭建 [前言] 我是用的是VS2012,VS的版本应该大致一样. [开发环境搭建] >>>SDL2.0开发环境配置:1.从www.libsdl.org 下载 ...
随机推荐
- leetcode【14题】Longest Common Prefix
题目:Longest Common Prefix 内容: Write a function to find the longest common prefix string amongst an ar ...
- Google Chrome Plus——绿色便携多功能谷歌浏览器
我更新浏览器的时候一般没有时间更新这个帖子,所以具体请看我网盘下载链接里面的更新日志,请自行查看最新版本下载,谢谢. 近期更新日期:2016.8.15(此时间可能不是最新,请看我网盘里面的更新日志) ...
- HDFS基本原理总结
HDFS由三个基本组件组成:NameNode,SecondaryName,DataNode,其思想类似于Linux的文件系统,可以进行类比. 1.NameNode介绍: 1.管理整个文件系统的命名空间 ...
- Angular.js学习范例及笔记
一.AngularJs 1.row in order.rows <ng-bind="row.name"> 2.ng-form <form action=" ...
- express+mysqle
var mysql=require('mysql'); var connection=mysql.createConnection({ host:'',//地址 port:'',//端口号 user: ...
- 开源一套基于vue全家桶的webapp
一.设计初衷 原本今年就是有一个打算要做一套商业的作品,恰巧目前离职,在找工作的过程中,所以有时间闲下来沉淀对原本的知识进行梳理. 说一个题外话,就是由于博主之前是很早一批使用vue的用户,也就是距今 ...
- JAVA NIO之文件通道
1.简介 通道是 Java NIO 的核心内容之一,在使用上,通道需和缓存类(ByteBuffer)配合完成读写等操作.与传统的流式 IO 中数据单向流动不同,通道中的数据可以双向流动.通道既可以读, ...
- 关于css选择器中有小数点的标签获取
需求说明 因为项目中章节配置的时候有小数点,1,1.1,1.2,1.11的标题,这个时候每一行标题的id,class设置成标题号是独一无二的标记.但是,直接用js获取是获取不到的,例如$('#3.22 ...
- 避免uncaughtException错误引起node.js进程崩溃
uncaughtException 未捕获的异常, 当node.js 遇到这个错误,整个进程直接崩溃. 或许这俩个人上辈子一定是一对冤家. 或许这俩个人经历了前世500次的回眸才换来了今生的相遇,只可 ...
- Jenkins集成Docker镜像实现自动发布
1. 思路&流程 Jenkins集成Docker镜像实现自动发布与Jenkins发布mavne项目思路一样总体流程 为:Jenkins 拉去远端源码 -- gitl实现应用打包 -- jenk ...