
Spark性能优化总结
1. 避免重复加载RDD
比如一份从HDFS中加载的数据 val rdd1 = sc.textFile("hdfs://url:port/test.txt"),这个test.txt只应该在你的程序中被加载一次,避免多次加载造成的性能开销。
2. 重复使用的RDD需要被缓存
Spark有数据持久化的几种策略,可以将RDD中的数据保存到内存或者磁盘中,后续对这个RDD的操作不会根据RDD lineage重新计算,而是直接从缓存中提取。
如果要对一个RDD进行持久化,只需要对这个RDD调用cache()和persist(),cache()方法表示:使用非序列化的方式将RDD中的数据全部尝试持久化到内存中,
但是生产环境中处理的数据量往往很难全部存储在内存中,需注意虚拟机OOM;persist()方法表示需要手动选择StorageLevel(持久化级别),并使用指定的方式
进行持久化,如序列化到磁盘等(注意,有时候数据全部序列化到磁盘比重新计算一次更慢!)
3. 警惕shuffle操作性能问题
类似MapReduce中的shuffle过程(MapReduce浅析),同一个父RDD的分区传入到不同的子RDD分区中,shuffle过程往往会造成跨节点数据传输(即官网所说的宽依赖问题):
各个节点上的相同key首先写入本地磁盘文件中,然后其他节点需要通过网络根据路由函数传输拉取各个节点上的磁盘文件中的相同key。而且相同key都拉取到同一个节点进行聚合
操作时,还有可能会因为一个节点上处理的key过多,导致内存不够存放,溢写到磁盘文件中。。
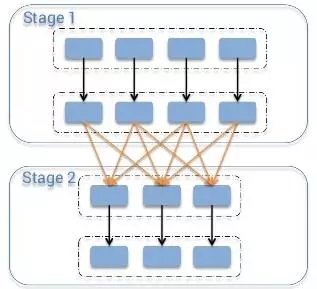
图1.Spark的shuffle过程
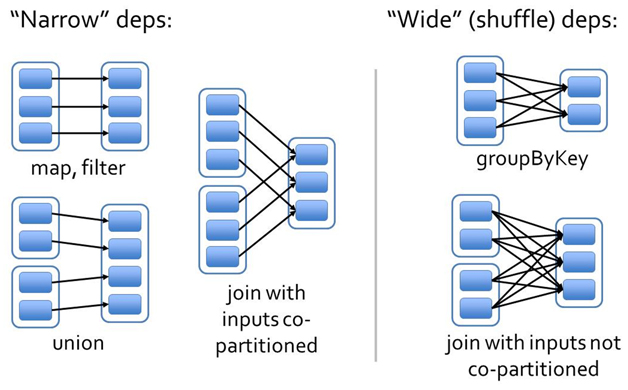
图2. 宽依赖和窄依赖
解决方式有以下两种:
1. 如果可以,先使用filter对RDD先做一定程度的 ‘缩小’
2. 在Map端预先对数据进行聚合,类似传统MapReduce中的Combiner,在Spark中使用reduceByKey或者aggregateByKey会对数据在Map端聚合,
反之,groupByKey会导致全部数据在集群中跨节点传输,性能较差。
4. 广播变量
类似于MapReduce中的DistributeCache。默认情况下Spark会将程序中依赖的变量复制多个副本,分发到各个task中,每个task都有一个副本。如果
变量本身比较大的话,那么大量的变量副本在网络中传输的性能开销,以及在各个节点的Executor中占用过多内存导致的频繁GC,都会极大地影响性能。
而Spark中的广播变量作用是一个Executor中的所有task共享一个副本。
5. 序列化
Spark可以使用Kryo优化序列化过程。
Spark性能优化总结的更多相关文章
- 【转载】Spark性能优化指南——高级篇
前言 数据倾斜调优 调优概述 数据倾斜发生时的现象 数据倾斜发生的原理 如何定位导致数据倾斜的代码 查看导致数据倾斜的key的数据分布情况 数据倾斜的解决方案 解决方案一:使用Hive ETL预处理数 ...
- 【转载】 Spark性能优化指南——基础篇
转自:http://tech.meituan.com/spark-tuning-basic.html?from=timeline 前言 开发调优 调优概述 原则一:避免创建重复的RDD 原则二:尽可能 ...
- 【转】【技术博客】Spark性能优化指南——高级篇
http://mp.weixin.qq.com/s?__biz=MjM5NjQ5MTI5OA==&mid=2651745207&idx=1&sn=3d70d59cede236e ...
- 【转】Spark性能优化指南——基础篇
http://mp.weixin.qq.com/s?__biz=MjM5NDMwNjMzNA==&mid=2651805828&idx=1&sn=2f413828d1fdc6a ...
- Spark性能优化指南——高级篇(转载)
前言 继基础篇讲解了每个Spark开发人员都必须熟知的开发调优与资源调优之后,本文作为<Spark性能优化指南>的高级篇,将深入分析数据倾斜调优与shuffle调优,以解决更加棘手的性能问 ...
- Spark性能优化指南——基础篇(转载)
前言 在大数据计算领域,Spark已经成为了越来越流行.越来越受欢迎的计算平台之一.Spark的功能涵盖了大数据领域的离线批处理.SQL类处理.流式/实时计算.机器学习.图计算等各种不同类型的计算操作 ...
- Spark性能优化指南-高级篇
转自https://tech.meituan.com/spark-tuning-pro.html,感谢原作者的贡献 前言 继基础篇讲解了每个Spark开发人员都必须熟知的开发调优与资源调优之后,本文作 ...
- Spark性能优化指南——基础篇
本文转自:http://tech.meituan.com/spark-tuning-basic.html 感谢原作者 前言 在大数据计算领域,Spark已经成为了越来越流行.越来越受欢迎的计算平台之一 ...
- Spark性能优化指南——高级篇
本文转载自:https://tech.meituan.com/spark-tuning-pro.html 美团技术点评团队) Spark性能优化指南——高级篇 李雪蕤 ·2016-05-12 14:4 ...
- Spark记录-Spark性能优化解决方案
Spark性能优化的10大问题及其解决方案 问题1:reduce task数目不合适解决方式:需根据实际情况调节默认配置,调整方式是修改参数spark.default.parallelism.通常,r ...
随机推荐
- [BZOJ4825][HNOI2017]单旋spaly
BZOJ Luogu 题目太长了,就不放了. 题解 首先声明一点,无论是splay还是spaly,插入一个新的元素,都要rotate到根!所以说题目也算是给了一个错误示范吧. 我们发现把最值旋转到根并 ...
- 【learning】二分图最大匹配的König定理
[吐槽] 嗯好吧这个东西吧..其实是一开始做一道最小点覆盖的题的时候学到的奇妙深刻的东西 然后发现写了很长 然后就觉得不拎出来对不起自己呀哈哈哈哈 咳咳好的进入正题 [正题] 在这里码一下最小点覆盖的 ...
- Linux初学者的总结
总算在年前把Linux的一些基本命令学完了,总结一下学到的(比较实用的)东西 我这里用的是Red Hat Enterprise Linux7的社区版本centos7 首先最重要的文件查看命令:ls.d ...
- Java集合中的LinkedHashMap类
jdk1.8.0_144 本文阅读最好先了解HashMap底层,可前往<Java集合中的HashMap类>. LinkedHashMap由于它的插入有序特性,也是一种比较常用的Map集合. ...
- SpringMVC【校验器、统一处理异常、RESTful、拦截器】
前言 本博文主要讲解的知识点如下: 校验器 统一处理异常 RESTful 拦截器 Validation 在我们的Struts2中,我们是继承ActionSupport来实现校验的...它有两种方式来实 ...
- 数据库连接问题之:Caused by: java.sql.SQLException: Connections could not be acquired from the underlying database!
要么是驱动问题(没加载到工程中去或者其他问题)要么是账号密码或者url或者driver写错 driver:com.mysql.jdbc.Driver url:jdbc:mysql://localhos ...
- centos7上关闭防火墙
centos7上默认开启的是+firewalld,关闭了iptables 停止防护墙: systemctl stop firewalld.service 开机不启动: systemctl disabl ...
- shell中的数字
shell中的数字 author :headsen chen date :2017-10-18 15:01:42 个人原创,转载请注明作者,出处,否则依法追究法律责任 1,生成随机数(范围:0-32 ...
- Tomcat使用基础
1.解压Tomcat压缩文件后需要在环境变量里配置 :TOMCAT_HOME:D:\apache-tomcat-8.0.35. 2.将打好的项目war包放到tomcat安装目录的webapps文件夹下 ...
- 【源码分析】你必须知道的string.IsNullOrEmpty && string.IsNullOrWhiteSpace
写在前面 之前自信撸码时踩了一次小坑,代码如下: private static void AppServer_NewMessageReceived(WebSocketSession session, ...