
论文笔记:A Structured Self-Attentive Sentence Embedding
A Structured Self-Attentive Sentence Embedding
ICLR 2017
2018-08-19 14:07:29
Paper:https://arxiv.org/pdf/1703.03130.pdf
Code(PyTorch): https://github.com/kaushalshetty/Structured-Self-Attention
Video Tutorial (Youtube): Ivan Bilan: Understanding and Applying Self-Attention for NLP | PyData Berlin 2018
Blog:
1. 机器之心
2. https://www.paperweekly.site/papers/notes/148
Related Papers: Self-Attention Generative Adversarial Networks
Background and Motivation:
现有的处理文本的常规流程第一步就是:Word embedding。也有一些 embedding 的方法是考虑了 phrase 和 sentences 的。这些方法大致可以分为两种: universal sentence(general 的句子)和 certain task(特定的任务);常规的做法:利用 RNN 最后一个隐层的状态,或者 RNN hidden states 的 max or average pooling 或者 convolved n-grams. 也有一些工作考虑到 解析和依赖树(parse and dependence trees);
对于一些工作,人们开始考虑通过引入额外的信息,用 attention 的思路,以辅助 sentence embedding。但是对于某些任务,如:情感分类,并不能直接使用这种方法,因为并没有此类额外的信息:the model is only given one single sentence as input. 此时,最常用的做法就是 max pooling or averaging 所有的 RNN 时间步骤的隐层状态,或者只提取最后一个时刻的状态作为最终的 embedding。
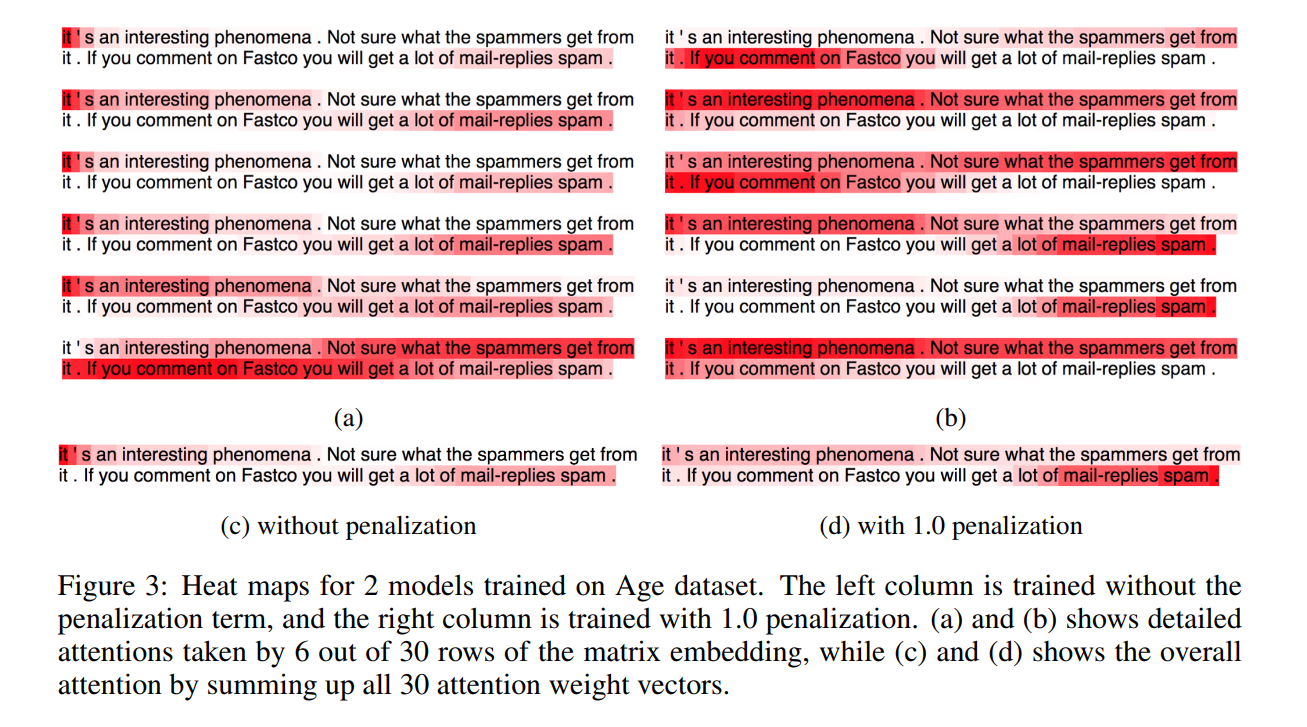
而本文提出一种 self-attention 的机制来替换掉通常使用的 max pooling or averaging step. 因为作者认为:carrying the semantics along all time steps of a recurrent model is relatively hard and not necessary. 不同于前人的方法,本文所提出的 self-attention mechanism 允许提取句子的不同方便的信息,来构成多个向量的表示(allows extracting different aspects of the sentence into multiple vector representation)。在我们的句子映射模型中,是在 LSTM 的顶端执行的。这确保了 attention 模型可以应用于没有额外信息输入的任务当中,并且减少了 lstm 的一些长期记忆负担。另外一个好处是,可视化提取的 embedding 变的非常简单和直观。

Approach Details:
1. Model
所提出的 sentence embedding model 包含两个部分:(1)双向 lstm;(2)the self-attention mechanism;
给定一个句子,我们首先将其进行 Word embedding,得到:S = (w1, w2, ... , wn),然后讲这些 vector 拼成一个 2-D 的矩阵,维度为:n*d;
然后为了 model 不同单词之间的关系,我们利用双向 lstm 来建模,得到其两个方向的隐层状态,然后,此时我们可以得到维度为:n*2u 的矩阵,记为:H。
为了将变长的句子,编码为固定长度的 embedding。我们想通过选择 n 个 LSTM hidden states 的线性组合,来达到这一目标。计算这样的线性组合,需要利用 self-attention 机制,该机制将 lstm 的所有隐层状态 H 作为输入,并且输出为一个向量权重 a:

其中,$W_{s1}$ 是大小为 $d_a * 2u$ 的权重矩阵,$w_{s2}$ 是大小为 $d_a$ 的向量参数,这里的 $d_a$ 是我们可以自己设定的。由于 H 的大小为:n * 2u, annotation vector a 大小为 n,the softmax()函数确保了计算的权重加和为1. 然后我们将 lstm 的隐层状态 H 和 attention weight a 进行加权,即可得到 attend 之后的向量 m。
向量的表示通常聚焦于句子的特定成分,像一个特定的相关单词或者词汇的集合。所以,我们需要反映出不同的语义的成分和放慢。但是,一个句子中可能有多个不同的成分,特别是长句子。所以,为了表示句子的总体的语义,我们需要多个 m's 来聚焦于不同的部分。所以,我们需要用到:multiple hops of attention. 即:我们想从句子中提取出 r 个不同的部分,我们将 $w_s2$ 拓展为:$r * d_a$ 的 matrix,记为:$W_{s2}$,然后 the resulting annotation vector a 变为了 annotation matrix A. 正式的来说:

此处,softmax()是沿着输入的 第二个维度执行的。我们可以将公式(6)看做是一个 2-layer MLP without bias。
映射向量 m 然后就变成了:$r * 2u$ 的 embedding matrix M。我们通过将 annotation A 和 lstm 的隐层状态 H 进行相乘,得到 the r weighted sums,结果矩阵就是句子的映射:
M = AH
2. Penalization Term
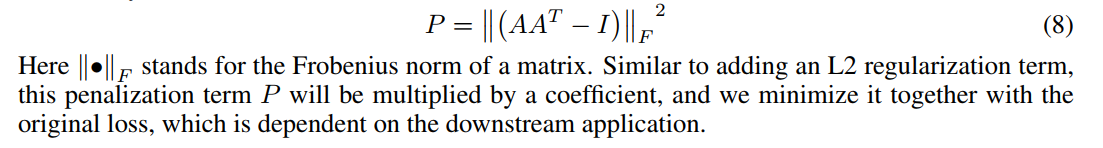
当 attention 机制总是提供类似的 summation weights for all the r hops,映射矩阵 M 可能会受到冗余问题的影响。然后,我们需要一个惩罚项,来估计 summation weight vectors 变的 diverse。
最好的衡量的两个 summation weight vectors 之间的度量方式就是:KL Divergence(Kullback Leibler Divergence),然而,作者发现在这个问题中,并不适合。作者猜想这是由于:we are maximizing a set of KL divergence, we are optimizing the annotation matrix A to have a lot of sufficiently small or even zero values at different softmax output units, and these vast amount of zeros is making the training unstable. 另一个 KL 不具有的特征,但是我们缺需要的是:we want to each individual row to focus on a single aspect of semantics, so we want the probabilty mass in the annotation softmax output to be more focused.
我们将 A 乘以其转置,然后减去单位矩阵,作为其冗余度的度量:

Experiments:
==
论文笔记:A Structured Self-Attentive Sentence Embedding的更多相关文章
- 《A Structured Self-Attentive Sentence Embedding》(注意力机制)
Background and Motivation: 现有的处理文本的常规流程第一步就是:Word embedding.也有一些 embedding 的方法是考虑了 phrase 和 sentence ...
- 将句子表示为向量(下):基于监督学习的句子表示学习(sentence embedding)
1. 引言 上一篇介绍了如何用无监督方法来训练sentence embedding,本文将介绍如何利用监督学习训练句子编码器从而获取sentence embedding,包括利用释义数据库PPDB.自 ...
- 将句子表示为向量(上):无监督句子表示学习(sentence embedding)
1. 引言 word embedding技术如word2vec,glove等已经广泛应用于NLP,极大地推动了NLP的发展.既然词可以embedding,句子也应该可以(其实,万物皆可embeddin ...
- Deep Learning论文笔记之(八)Deep Learning最新综述
Deep Learning论文笔记之(八)Deep Learning最新综述 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文,但老感觉看完 ...
- 论文笔记之:Natural Language Object Retrieval
论文笔记之:Natural Language Object Retrieval 2017-07-10 16:50:43 本文旨在通过给定的文本描述,在图像中去实现物体的定位和识别.大致流程图如下 ...
- 【论文笔记】Learning Fashion Compatibility with Bidirectional LSTMs
论文:<Learning Fashion Compatibility with Bidirectional LSTMs> 论文地址:https://arxiv.org/abs/1707.0 ...
- Deep Learning论文笔记之(四)CNN卷积神经网络推导和实现(转)
Deep Learning论文笔记之(四)CNN卷积神经网络推导和实现 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文, ...
- 论文笔记之:Visual Tracking with Fully Convolutional Networks
论文笔记之:Visual Tracking with Fully Convolutional Networks ICCV 2015 CUHK 本文利用 FCN 来做跟踪问题,但开篇就提到并非将其看做 ...
- Twitter 新一代流处理利器——Heron 论文笔记之Heron架构
Twitter 新一代流处理利器--Heron 论文笔记之Heron架构 标签(空格分隔): Streaming-process realtime-process Heron Architecture ...
随机推荐
- react 使用 react-loadable分包
文档 yarn add react-loadable 使用 import Loadable from "@/components/loadable"; const Home = L ...
- 写jquery插件(转载)
如今做web开发,jquery 几乎是必不可少的,就连vs神器在2010版本开始将Jquery 及ui 内置web项目里了.至于使用jquery好处这里就不再赘述了,用过的都知道.今天我们来讨论下jq ...
- 七牛免费SSL证书申请全流程
购买证书 在七牛ssl 首页点击购买 购买限免证书 补全订单信息 免费证书,随意填写,问题不大 购买成功,查看订单详情,获取 TXT 值信息 添加 DNS TXT 验证 根据上一步,查看证书订单详情, ...
- ruby 基础知识 - Class 与 Module
原文 1. 因為 Ruby 並沒有「屬性」(property/attribute)這樣的設計,要取用實體變數,需要另外定義的方法才行: class Cat def initialize(name, g ...
- 3.nodejs(三) 常用API
1.querystring querystring: --- > qs npm i qs ==> qs:parse/stringify第三方插件,只有一个参数 JSON.parse 字符 ...
- Tesseract
定义 Tesseract是一个将图像翻译成文字的OCR库(光学文字识别,Optical Character Recognition) 安装 sudo apt-get install tesseract ...
- java学习之路--简单基础的面试题
1.面向对象的特征有哪些方面? 答:面向对象的特征主要有以下几个方面: 1)抽象:抽象是将一类对象的共同特征总结出来构造类的过程,包括数据抽象和行为抽象两方面.抽象只关注对象有哪些属性和行为,并不关注 ...
- MySQL数据库(增删查改)
创建一个表:create table user( uid varchar(10) , pwd int(10) ); 学生表: create table student( sno varchar(20) ...
- 程序员调 Bug 的样子,非常真实
程序员调 Bug 的样子,非常真实
- AngularJS实现可伸缩的页面切换
AngularJS实现可伸缩的页面切换 AngularJS 1.2 通过引入基于纯CSS class的切换和动画,在一个单页面应用创建页面到页面的切换变得更加的容易.只需要使用一个ng-view,让我 ...