
Scrapy学习篇(九)之文件与图片下载
Media Pipeline
Scrapy为下载item中包含的文件(比如在爬取到产品时,同时也想保存对应的图片)提供了一个可重用的 item pipelines . 这些pipeline有些共同的方法和结构(称之为media pipeline)。我们可以使用FilesPipeline和Images Pipeline来保存文件和图片,他们有以下的一些特点:
- Files Pipeline
- 避免重新下载最近已经下载过的数据
- 指定存储路径
FilesPipeline的典型工作流程如下:
- 在一个爬虫里,你抓取一个项目,把其中图片的URL放入 file_urls 组内。
- 项目从爬虫内返回,进入项目管道。
- 当项目进入 FilesPipeline,file_urls 组内的URLs将被Scrapy的调度器和下载器(这意味着调度器和下载器的中间件可以复用)安排下载,当优先级更高,会在其他页面被抓取前处理。项目会在这个特定的管道阶段保持“locker”的状态,直到完成文件的下载(或者由于某些原因未完成下载)。
- 当文件下载完后,另一个字段(files)将被更新到结构中。这个组将包含一个字典列表,其中包括下载文件的信息,比如下载路径、源抓取地址(从 file_urls 组获得)和图片的校验码(checksum)。 files 列表中的文件顺序将和源 file_urls 组保持一致。如果某个图片下载失败,将会记录下错误信息,图片也不会出现在 files 组中。
- Images Pipeline
- 避免重新下载最近已经下载过的数据
- 指定存储路径
- 将所有下载的图片转换成通用的格式(JPG)和模式(RGB)
- 缩略图生成
- 检测图像的宽/高,确保它们满足最小限制
和FilesPipeline类似,除了默认的字段名不同,image_urls保存图片URL地址,images保存下载后的图片信息。当然,它还提供了一些拓展功能,比如图片的缩略图,过滤图片的尺寸。
注意:你需要安装Pillow 库来实现以上的拓展功能。
启用Media Pipeline
要想使用media pipeline,你需要在设置添加一些必要的信息。
# 同时启用图片和文件管道

ITEM_PIPELINES = {

                  'scrapy.pipelines.images.ImagesPipeline': 1,

                  'scrapy.pipelines.files.FilesPipeline': 2,

                 }

FILES_STORE = 'D:'  # 文件存储路径

IMAGES_STORE = 'D' # 图片存储路径

# 避免下载最近90天已经下载过的文件内容

FILES_EXPIRES = 90

# 避免下载最近30天已经下载过的图像内容

IMAGES_EXPIRES = 30

# 设置图片缩略图

IMAGES_THUMBS = {

    'small': (50, 50),

    'big': (250, 250),

}

# 图片过滤器,最小高度和宽度,低于此尺寸不下载

IMAGES_MIN_HEIGHT = 110

IMAGES_MIN_WIDTH = 110
你可能会好奇文件的命名,在当你启用media pipeline以后,
它的默认命名方式是这样的,文件以它们URL的 SHA1 hash 作为文件名。
例如,
对下面的图片URL:http://www.example.com/image.jpg,
其SHA1 hash 值为:3afec3b4765f8f0a07b78f98c07b83f013567a0a
将被下载并存为下面的文件:<IMAGES_STORE>/full/3afec3b4765f8f0a07b78f98c07b83f013567a0a.jpg
扩展Media Pipeline
下面我们以ImagesPipeline为例来自定义ImagesPipeline,需要重写以下两个方法:
get_media_requests(item, info)
在工作流程中可以看到,管道会得到图片的URL并从项目中下载。为了这么做,你需要重写 get_media_requests() 方法,并对各个图片URL返回一个Request:def get_media_requests(self, item, info):
for image_url in item['image_urls']:
yield scrapy.Request(image_url)这些请求将被管道处理,当它们完成下载后,结果将以2元素的元组列表形式传送到 item_completed() 方法: 每个元组包含 (success, file_info_or_error):
- success 是一个布尔值,当图片成功下载时为 True ,因为某个原因下载失败为False
file_info_or_error 是一个包含下列关键字的字典(如果成功为 True )或者出问题时为 Twisted Failure 。
url - 文件下载的url。这是从 get_media_requests() 方法返回请求的url。
path - 图片存储的路径(类似 IMAGES_STORE)
checksum - 图片内容的 MD5 hash
item_completed() 接收的元组列表需要保证与 get_media_requests() 方法返回请求的顺序相一致。下面是 results 参数的一个典型值:[(True,
{'checksum': '2b00042f7481c7b056c4b410d28f33cf',
'path': 'full/0a79c461a4062ac383dc4fade7bc09f1384a3910.jpg',
'url': 'http://www.example.com/files/product1.jpg'}),
(False,
Failure(...))]该方法 必须返回每一个图片的URL。
item_completed(results, items, info)
当一个单独项目中的所有图片请求完成时,例如,item里面一共有10个URL,那么当这10个URL全部下载完成以后,ImagesPipeline.item_completed() 方法将被调用。默认情况下, item_completed() 方法返回item。
使用ImagesPipeline下载图片
下面我们用上面学习到的知识来下载一些图片。
我们以http://jandan.net/ooxx为例,把页面上的图片下载下来,并产生缩略图
我们新建一个项目,名为jiandan,各个文件内容如下。
item.py
import scrapy

class JiandanItem(scrapy.Item):

    image_urls = scrapy.Field()#图片的链接

    images = scrapy.Field()
jiandan_spider.py
import scrapy

from jiandan.items import JiandanItem

class jiandanSpider(scrapy.Spider):

    name = 'jiandan'

    start_urls = ["http://jandan.net/ooxx"]

    def parse(self, response):

        item = JiandanItem()

        item['image_urls'] = response.xpath('//img//@src').extract() #提取图片链接

        yield item
settings.py
BOT_NAME = 'jiandan'

SPIDER_MODULES = ['jiandan.spiders']

NEWSPIDER_MODULE = 'jiandan.spiders'

DEFAULT_REQUEST_HEADERS = {

    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

    'Accept-Language': 'en',

    'User-Agent':"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36",

}

ITEM_PIPELINES = {

   'jiandan.pipelines.JiandanPipeline':1,

}

IMAGES_STORE='H:\\jiandan'

IMAGES_THUMBS = {

    'small': (50, 50),

    'big': (200, 200),

}
pipelinse.py
import scrapy

from scrapy.exceptions import DropItem

from scrapy.pipelines.images import ImagesPipeline   #内置的图片管道

class JiandanPipeline(ImagesPipeline):#继承ImagesPipeline这个类

    def get_media_requests(self, item, info):

        for image_url in item['image_urls']:

            image_url = "http://" + image_url

            yield scrapy.Request(image_url)

    def item_completed(self, results, item, info):

        image_paths = [x['path'] for ok, x in results if ok]

        if not image_paths:

            raise DropItem("Item contains no images")

        return item
运行这个spider,你会发现,图片已经下载好了,如下图所示。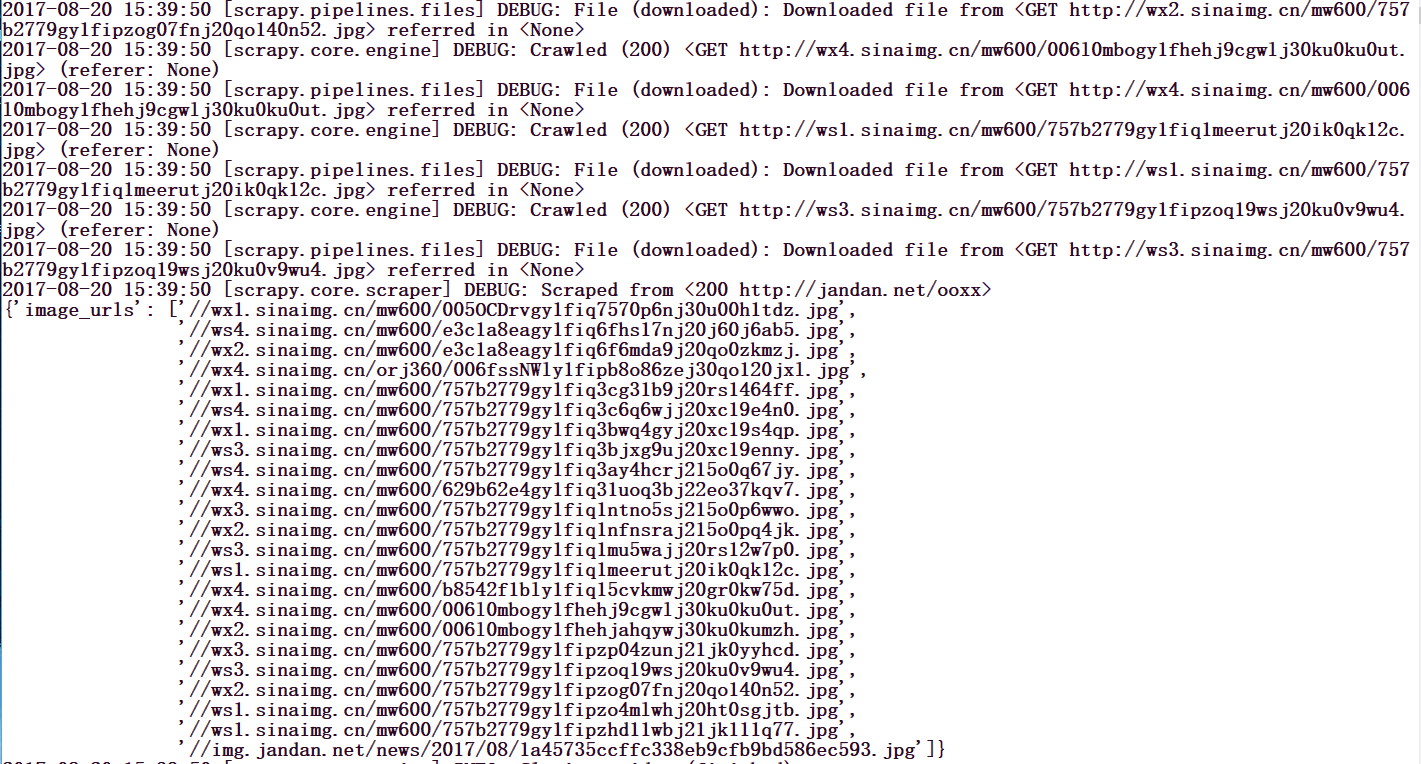
图片内容你可以自己慢慢看。
Scrapy学习篇(九)之文件与图片下载的更多相关文章
- Scrapy学习篇(七)之Item Pipeline
在之前的Scrapy学习篇(四)之数据的存储的章节中,我们其实已经使用了Item Pipeline,那一章节主要的目的是形成一个笼统的认识,知道scrapy能干些什么,但是,为了形成一个更加全面的体系 ...
- Scrapy学习篇(十)之下载器中间件(Downloader Middleware)
下载器中间件是介于Scrapy的request/response处理的钩子框架,是用于全局修改Scrapy request和response的一个轻量.底层的系统. 激活Downloader Midd ...
- Scrapy学习篇(四)之数据存储
上一篇中,我们简单的实现了toscrapy网页信息的爬取,并存储到mongo,本篇文章信息看看数据的存储.这一篇主要是实现信息的存储,我们以将信息保存到文件和mongo数据库为例,学习数据的存储,依然 ...
- Scrapy学习篇(十二)之设置随机IP代理(IPProxy)
当我们需要大量的爬取网站信息时,除了切换User-Agent之外,另外一个重要的方式就是设置IP代理,以防止我们的爬虫被拒绝,下面我们就来演示scrapy如何设置随机IPProxy. 设置随机IPPr ...
- Scrapy学习篇(十一)之设置随机User-Agent
大多数情况下,网站都会根据我们的请求头信息来区分你是不是一个爬虫程序,如果一旦识别出这是一个爬虫程序,很容易就会拒绝我们的请求,因此我们需要给我们的爬虫手动添加请求头信息,来模拟浏览器的行为,但是当我 ...
- Scrapy学习篇(六)之Selector选择器
当我们取得了网页的response之后,最关键的就是如何从繁杂的网页中把我们需要的数据提取出来,python从网页中提取数据的包很多,常用的有下面的几个: BeautifulSoup它基于HTML代码 ...
- Scrapy学习篇(五)之Spiders
Spiders Spider类定义了如何爬取某个网站.包括了爬取的动作(例如:是否跟进链接)以及如何从网页的内容中提取结构化数据(爬取item).简而言之,Spider就是你定义爬取的动作及分析某个网 ...
- Scrapy学习篇(十三)之scrapy-splash
之前我们学习的内容都是抓取静态页面,每次请求,它的网页全部信息将会一次呈现出来. 但是,像比如一些购物网站,他们的商品信息都是js加载出来的,并且会有ajax异步加载.像这样的情况,直接使用scrap ...
- Scrapy学习篇(八)之settings
Scrapy设定(settings)提供了定制Scrapy组件的方法.你可以控制包括核心(core),插件(extension),pipeline及spider组件.设定为代码提供了提取以key-va ...
随机推荐
- windows服务项目的 安装 卸载 查看
安装服务:installutil.exe C:\a.exe卸载服务Installutil.exe /u C:\a.exe 查看服务状态 services.msc
- Container&injection
容器(Container)就是组件和底层服务细节之间的接口.在web组件.企业级Bean等能够执行之前,它必须被装配为一个JavaEE模块,并部署在容器上. 在JavaEE5时代通过注解的方式注入(i ...
- 转载 [c#] 虚函数(Virtual),抽象函数(abstract)和接口的区别
1.virtual:允许被重写,但不强制要求.声明时提供其自身实现: 2.abstract:强制要求其继承者重写.声明时不提供其自身的实现,抽象类不能被实例化: 3.interface:接口就是协议, ...
- .net 表达式返回值和等号赋值的区别
.net 7.0的新特性中,有一个使用表达式体返回值的操作.请看如下代码: private string _userName=""; public string UserName{ ...
- mariadb安装和一些sql基础
MariaDB安装 yum -y install mariadb mariadb-server 启动 systemctl start mariadb systemctl enabl ...
- React项目新手指南
对于程序员而言:驼峰和下划线之间是一场宗派战争:大括号是否换行会成为一种党派:逗号写在行尾还是行首的人来自不同星球…… 然而,无规矩不成方圆,任何一个团队,要想有高质量的产出,第一步必须要对一些基本的 ...
- UI自动化selenium
1.什么是UI自动化?模拟人用代码的方式去操作页面2.为什么要做UI自动化?后期迭代的时候,老功能比较多,人工维护成本较大,重复性工作较多,这个时候就考虑因为UI自动化3.什么时候做UI自动化?项目稳 ...
- 第十二次作业 - Beta答辩总结
目录 前言 项目的链接与宣传 项目总结 原计划 达成情况 原因分析 [ Beta 冲刺博客链接汇总] [燃尽图] Beta版本展示 使用说明 视频展示 图片展示 答辩总结 [团队中个人的贡献比例] [ ...
- 高级数据类型---元祖[tuple]
一.Tuple(元组)与列表类似,不同之处在于元组的 元素不能修改,让列表不可以被修改,以保护数据安全 元组 表示多个元素组成的序列 元组 在 Python 开发中,有特定的应用场景 用于存储 一串 ...
- setfacl语法2
setfacl命令可以用来细分linux下的文件权限. chmod命令可以把文件权限分为u,g,o三个组,而setfacl可以对每一个文件或目录设置更精确的文件权限. 换句话说,setfacl可以更精 ...