
Lucence
Lucene是apache软件基金会4 jakarta项目组的一个子项目,是一个开放源代码的全文检索引擎工具包,但它不是一个完整的全文检索引擎,而是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎,部分文本分析引擎。Lucene的目的是为软件开发人员提供一个简单易用的工具包.
粘贴这句话的意思就是想说明 Lucene仅仅是一个工具包,搜索引擎的工具包.
有人会问?Lucene和solr的区别,solr是一个搜索系统,打个比方,就如servlet和struts2的区别 Lucene就是servlet,solr就好比solr,solr封装了Lucene.
下面说说Lucene的原理:
我们使用Lucene,其实使用的是他的倒排查询
什么是倒排查询?举个例子
新华字典,我们都用过吧,新华字典分为两部分,第一部门就是目录的边旁部首,第二部分就是正文,一个一个字的解释,
我们在用新华字典的时候,一般我们都是通过边旁部首找字,没有人一页一页的翻字典找字吧.
Lucene的倒排就是如此,他会检索文本,数据库,web网页,在把内容分词,就像边旁部首

再次强调

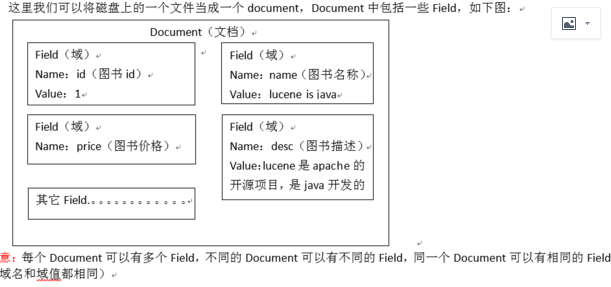

这一条数据就是一个document文档
每一个字段就是一个Field域

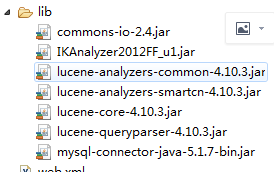
这就是要用到的包;
 ik下载后把这3个文件也要导入项目中,ext.dic是加词的,stop是停词的.
前面的都是Lucece的理论,只有理论搞懂了,下面的代码实现过程也就轻松了
 package com.itheima.lucene;

 import java.io.File;

 import java.util.ArrayList;

 import java.util.List;

 import org.apache.lucene.analysis.Analyzer;

 import org.apache.lucene.analysis.standard.StandardAnalyzer;

 import org.apache.lucene.document.Document;

 import org.apache.lucene.document.Field.Store;

 import org.apache.lucene.document.TextField;

 import org.apache.lucene.index.DirectoryReader;

 import org.apache.lucene.index.IndexReader;

 import org.apache.lucene.index.IndexWriter;

 import org.apache.lucene.index.IndexWriterConfig;

 import org.apache.lucene.queryparser.classic.QueryParser;

 import org.apache.lucene.search.IndexSearcher;

 import org.apache.lucene.search.Query;

 import org.apache.lucene.search.ScoreDoc;

 import org.apache.lucene.search.TopDocs;

 import org.apache.lucene.store.Directory;

 import org.apache.lucene.store.FSDirectory;

 import org.apache.lucene.util.Version;

 import org.junit.Test;

 import org.wltea.analyzer.lucene.IKAnalyzer;

 import com.itheima.dao.BookDao;

 import com.itheima.dao.impl.BookDaoImpl;

 import com.itheima.pojo.Book;

 public class CreateIndexTest {

     //分词

     @Test

     public void testCreateIndex() throws Exception{

     //    1. 采集数据

         BookDao bookDao = new BookDaoImpl();

         List<Book> listBook = bookDao.queryBookList();

     //    2. 创建Document文档对象

         List<Document> documents = new ArrayList<>();

         for (Book bk : listBook) {

             Document doc = new Document();

             doc.add(new TextField("id", String.valueOf(bk.getId()), Store.YES));// Store.YES:表示存储到文档域中

             doc.add(new TextField("name", bk.getName(), Store.YES));

             doc.add(new TextField("price", String.valueOf(bk.getPrice()), Store.YES));

             doc.add(new TextField("pic", bk.getPic(), Store.YES));

             doc.add(new TextField("desc", bk.getDesc(), Store.YES));

             // 把Document放到list中

             documents.add(doc);

         }

     //    3. 创建分析器(分词器)

         //Analyzer analyzer = new StandardAnalyzer();

         //中文  IK

         Analyzer analyzer = new IKAnalyzer();

     //    4. 创建IndexWriterConfig配置信息类

         IndexWriterConfig config = new IndexWriterConfig(Version.LUCENE_4_10_3, analyzer);

     //    5. 创建Directory对象,声明索引库存储位置

         Directory directory = FSDirectory.open(new File("H:\\temp"));

     //    6. 创建IndexWriter写入对象

         IndexWriter writer = new IndexWriter(directory, config);

     //    7. 把Document写入到索引库中

         for (Document doc : documents) {

             writer.addDocument(doc);

         }

     //    8. 释放资源

         writer.close();

     }

         //查

     @Test

     public void serachIndex() throws Exception{

         //创建分词器   必须和检索时的分析器一致

         Analyzer analyzer = new StandardAnalyzer();

         // 创建搜索解析器,第一个参数:默认Field域,第二个参数:分词器

         QueryParser queryParser = new QueryParser("desc", analyzer);

         // 1. 创建Query搜索对象

         Query query = queryParser.parse("desc:java AND lucene");

         // 2. 创建Directory流对象,声明索引库位置

         Directory directory = FSDirectory.open(new File("H:\\temp"));

         // 3. 创建索引读取对象IndexReader

         IndexReader indexReader = DirectoryReader.open(directory);

         // 4. 创建索引搜索对象IndexSearcher

         IndexSearcher indexSearcher = new IndexSearcher(indexReader);

         // 5. 使用索引搜索对象,执行搜索,返回结果集TopDocs

         // 第一个参数:搜索对象,第二个参数:返回的数据条数,指定查询结果最顶部的n条数据返回

         TopDocs topDocs  = indexSearcher.search(query, 10);

         System.out.println("查询到的数据总条数是:" + topDocs.totalHits);

         //获得结果集

         ScoreDoc[] docs = topDocs.scoreDocs;

         // 6. 解析结果集

         for (ScoreDoc scoreDoc : docs) {

             //获得文档

             int docID = scoreDoc.doc;

             Document doc = indexSearcher.doc(docID);

             System.out.println("docID:"+docID);

             System.out.println("bookid:"+doc.get("id"));

             System.out.println("pic:"+doc.get("pic"));

             System.out.println("name:"+doc.get("name"));

             System.out.println("desc:"+doc.get("desc"));

             System.out.println("price:"+doc.get("price"));

         }

         // 7. 释放资源

         indexReader.close();

     }

 }
Lucence的更多相关文章
- lucence.net+盘古分词
第一步: 添加盘古和lucence的dll引用 第二步: 拷贝Dict文件夹到项目 demo里面是Dictionaries 不过官方建议改成Dict 然后把所有项右击属性 改为“如果较新则复制” 第 ...
- Lucence工作原理
lucence 是一个高性能的java全文检索工具包,他使用倒排序文件索引结构,改结构和相应的生成算法如下: 一.设有两篇文章1和2 文章1的内容为:Tom lives in guangzh ...
- lucence学习系列之一 基本概念
1. Lucence基本概念 Lucence是一个java编写的全文检索类库,使用它可以为一个应用或者站点增加检索功能. 它通过增加内容到一个全文索引来完成检索功能.然后允许你基于这个索引去查询,返回 ...
- Lucence使用入门
参考: https://blog.csdn.net/u014209975/article/details/50525624 https://www.cnblogs.com/hanyinglong/p/ ...
- apache开源项目--lucence
Lucene 是apache软件基金会一个开放源代码的全文检索引擎工具包,是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎,部分文本分析引擎.Lucene的目的是为软件开发人员提供一个简单易用 ...
- Lucence.net索引技术 二
一. Lucene索引创建和优化 [版本2.9.0以上] Lucene索引的创建首先需要取得几个必须的对象: 1.分词器//可以采用其他的中文分词器 StandardAnalyzer analyzer ...
- Lucence.net索引技术 一
1.建立索引 为了对文档进行索引,Lucene 提供了五个基础的类,他们分别是 Document, Field, IndexWriter, Analyzer, Directory.下面我们分别介绍一下 ...
- Lucence.Net+添加关键词+分页+排序
1.使用queryparser完成解析搜索请求 2.基本格式如: QueryParser parser=new QueryParser("字段名称","分析器实例&quo ...
- Lucence.Net学习+盘古分词
创建索引库 //读取文件,存储到索引库 public string CreateDatebase() { //获取索引库的路径 ...
随机推荐
- 取消input默认样式
有时候input在页面中被聚焦后会出现默认的边框样式,可以通过以下方法取消去除 .input:focus{ outline: none;}
- 《Thinking in Java》 And 《Effective Java》啃起来
前言 今天从京东入手了两本书,<Thinking in Java>(第四版) 和 <Effective Java>(第二版).都可以称得上是硬书,需要慢慢啃的,预定计划是在今年 ...
- [转]ObjectARX二次开发vs编译器版本ARX版本对应说明
- Linux 零拷贝技术
简介 零拷贝(zero-copy)技术可以减少数据拷贝和共享总线操作的次数,消除通信数据在存储器之间不必要的中间拷贝过程,有效地提高通信效率,是设计高速接口通道.实现高速服务器和路由器的关键技术之一. ...
- java集合系列—ArrayList
ArrayList是工作以来使用频率最高的集合类.以前上课老师说不知道用什么集合类就用ArrayList,好吧,后面就这样了. public class ArrayList<E> exte ...
- poj1797 Heavy Transportation Dijkstra算法的简单应用
题目链接:http://poj.org/problem?id=1797 题目就是求所有可达路径的其中的最小值边权的最大值 即对于每一条能够到达的路径,其必然有其最小的承载(其实也就是他们自身的最大的承 ...
- hdu4681 String DP(2013多校第8场)
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=4681 思路: 我是胡搞过的 就是先预处理出(i,j)的正向的最大连续子串和逆向最大连续子串 然后对于A ...
- 【less和sass的区别,你了解多少?】
在介绍less和sass的区别之前,我们先来了解一下他们的定义: 一.Less.Sass/Scss是什么? 1.Less: 是一种动态样式语言. 对CSS赋予了动态语言的特性,如变量.继承.运算.函数 ...
- md5加密解析
MD5加密算法解析 知识库连接: http://baike.baidu.com/view/7636.htm http://baike.baidu.com/subview/350813/7544439. ...
- Introducing: Machine Learning in R(转)
Machine learning is a branch in computer science that studies the design of algorithms that can lear ...