
SqlServer Partition 分区表
分区表
测试版本:
Microsoft SQL Server 2014 - 12.0.2000.8 (X64)
Feb 20 2014 20:04:26
Copyright (c) Microsoft Corporation
Enterprise Edition (64-bit) on Windows NT 6.1 <X64> (Build 7601: Service Pack 1)
------新加文件组------
ALTER DATABASE [PARTITION] ADD FILEGROUP LogFG1
GO
ALTER DATABASE [PARTITION] ADD FILEGROUP LogFG2
GO
ALTER DATABASE [PARTITION] ADD FILEGROUP LogFG3
GO
ALTER DATABASE [PARTITION] ADD FILEGROUP LogFG4
GO
---添加文件组文件-------
---初始大小和增长速度和PRIMARY文件组保持一致------------
ALTER DATABASE [PARTITION] ADD FILE
(
NAME=N'LogFile1',
FILENAME=N'F:\Partition\LogData1.ndf',
SIZE = 5120KB,
MAXSIZE = UNLIMITED,
FILEGROWTH = 10240KB
)TO FILEGROUP LogFG1
GO
ALTER DATABASE [PARTITION] ADD FILE
(
NAME=N'LogFile2',
FILENAME=N'F:\Partition\LogData2.ndf',
SIZE = 5120KB,
MAXSIZE = UNLIMITED,
FILEGROWTH = 10240KB
)TO FILEGROUP LogFG2
GO
ALTER DATABASE [PARTITION] ADD FILE
(
NAME=N'LogFile3',
FILENAME=N'F:\Partition\LogData3.ndf',
SIZE = 5120KB,
MAXSIZE = UNLIMITED,
FILEGROWTH = 10240KB
)TO FILEGROUP LogFG3
GO
ALTER DATABASE [PARTITION] ADD FILE
(
NAME=N'LogFile4',
FILENAME=N'F:\Partition\LogData4.ndf',
SIZE = 5120KB,
MAXSIZE = UNLIMITED,
FILEGROWTH = 10240KB
)TO FILEGROUP LogFG4
GO
SELECT * FROM SYS.FILEGROUPS---文件组
----创建分区函数------
CREATE PARTITION FUNCTION PF_LOG (DATETIME)
AS RANGE LEFT FOR VALUES
(
'2016-01-31 23:59:59.997',
'2016-02-29 23:59:59.997',
'2016-03-31 23:59:59.997'
)
GO
当月的最大时间和最小时间
---最小时间--
SELECT CONVERT(datetime,CONVERT(char(8),getdate(),120)+'1')
------当月最大时间------------------
SELECT DATEADD(Day,-1,CONVERT(char(8),DATEADD(Month,1,getdate()),120)+'1')+' 23:59:59.998'
------创建分区方案----
CREATE PARTITION SCHEME PS_LOG AS PARTITION PF_LOG
TO
(
LogFG1,
LogFG2,
LogFG3,
LogFG4
)
GO
----创建分区表-----
CREATE TABLE Switch_Log
(
ID INT IDENTITY(1,1),
NAME1 CHAR(5),
NAME2 CHAR(5),
DATE1 DATETIME NOT NULL,
)
ON PS_LOG(DATE1)
GO
-------创建分区索引以及主键-----------
(创建唯一性索引,索引要包含分区列)
CREATE CLUSTERED INDEX IX_DATE1 ON Switch_Log(DATE1)
ALTER TABLE Switch_Log ADD CONSTRAINT PK_Log PRIMARY KEY NONCLUSTERED (ID,DATE1)
CREATE INDEX IX_NAME1 ON Switch_Log(NAME1)
------插入测试数据-----
INSERT INTO Switch_Log (NAME1,NAME2,DATE1)
VALUES ('AAAAA','BBBBB','2016-01-01 00:00:00.000')
GO 100000
INSERT INTO Switch_Log (NAME1,NAME2,DATE1)
VALUES ('CCCCC','DDDDD','2016-02-01 00:00:00.000')
GO 100000
INSERT INTO Switch_Log (NAME1,NAME2,DATE1)
VALUES ('EEEEE','FFFFF','2016-03-01 00:00:00.000')
GO 100000
-------------测试1-----------------
SELECT $PARTITION.PF_LOG('2016-01-02 00:00:00.000')
查找某个日期所在的分区
-------测试SWITCH-------------------
CREATE TABLE Switch_Log1
(
ID INT NOT NULL,
NAME1 CHAR(5),
NAME2 CHAR(5),
DATE1 DATETIME NOT NULL,
) ON PS_LOG(DATE1)
GO
---Switch目标表时,目标表要和分区表聚集索引要保持一致,数据是按聚集排列的,switch秒级别需要两个表聚集一致
--- 如果目标表swtich 分区表 则所有索引都要保持一致
CREATE CLUSTERED INDEX IX_DATE1 ON Switch_Log1(DATE1)
ALTER TABLE Switch_Log1 ADD CONSTRAINT PK_Log1 PRIMARY KEY NONCLUSTERED (ID,DATE1)
CREATE INDEX IX_NAME1 ON Switch_Log1(NAME1)
----SWITCH--------------
ALTER TABLE [dbo].[Switch_Log] SWITCH PARTITION 1 TO [dbo].[Switch_Log1] PARTITION 1
ALTER TABLE [dbo].[Switch_Log1] SWITCH PARTITION 1 TO [dbo].[Switch_Log] PARTITION 1
------MERGE--------
ALTER PARTITION FUNCTION [PF_LOG]() MERGE RANGE ('2016-01-31 23:59:59.997')
合并分区 根据 开始分区函数定义LEFT/RIGHT 定义来 删除分区范围
比如: 测试案例,我们用了left ,则第一分区的数据会合并到第二分区;RIGHT反之亦然。
-----------------SPLIT------------------
ALTER PARTITION SCHEME [PS_LOG] NEXT USED LogFG1
ALTER PARTITION FUNCTION [PF_LOG]() SPLIT RANGE ('2016-01-31 23:59:59.997')
先指定分区方案,再新加分区函数范围。
新的分区建成;
查询所有分区,所在的区、页数、行数、分区范围;
SELECT OBJECT_NAME(INS.OBJECT_ID)as '表名',
PS.partition_number AS '分区',
FG.NAME as '文件组',
AU.TOTAL_PAGES AS '页数',
CASE boundary_value_on_right WHEN 1 THEN 'RIGHT'
ELSE 'LEFT' END as 'L/R',
VALUE AS '分区界限',
PS.ROWS AS '行数',
CASE when ps.data_compression=0 then '未压缩'
ELSE '压缩'
END AS '是/否压缩'
FROM SYS.PARTITIONS PS
INNER JOIN SYS.INDEXES INS
ON PS.OBJECT_ID=INS.OBJECT_ID
AND PS.INDEX_ID=INS.INDEX_ID
JOIN SYS.partition_schemes PSS
ON PSS.data_space_id=INS.data_space_id
JOIN SYS.partition_functions PF
ON PF.function_id=PSS.function_id
LEFT JOIN SYS.partition_range_values PRV
ON PRV.function_id=PF.function_id
AND PS.partition_number=PRV.boundary_id
JOIN SYS.destination_data_spaces DS
ON DS.partition_scheme_id=PSS.data_space_id
AND DS.destination_id=PS.partition_number
JOIN SYS.FILEGROUPS FG
ON DS.destination_id=FG.data_space_id
JOIN (SELECT CONTAINER_ID,SUM(TOTAL_PAGES)AS TOTAL_PAGES
FROM SYS.allocation_units GROUP BY CONTAINER_ID) AS AU
ON AU.container_id=PS.partition_id
WHERE INS.INDEX_ID IN (0,1)
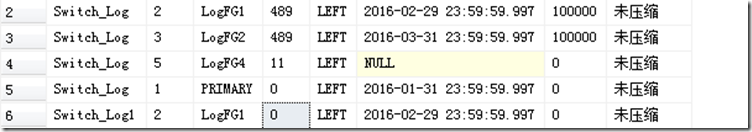
-----删除分区函数----刚好和我们创建顺序相反------
删除架构下面的表对象---架构-----函数----组文件------组---
ALTER DATABASE [PARTITION] REMOVE FILE LogFile1
ALTER DATABASE [PARTITION] REMOVE FILE LogFile2
ALTER DATABASE [PARTITION] REMOVE FILE LogFile3
ALTER DATABASE [PARTITION] REMOVE FILE LogFile4
ALTER DATABASE [PARTITION] REMOVE FILEGROUP LogFG1
ALTER DATABASE [PARTITION] REMOVE FILEGROUP LogFG2
ALTER DATABASE [PARTITION] REMOVE FILEGROUP LogFG3
ALTER DATABASE [PARTITION] REMOVE FILEGROUP LogFG4
SqlServer Partition 分区表的更多相关文章
- 详解Oracle partition分区表
随着表中行数的增多,管理和性能性能影响也将随之增加.备份将要花费更多时间,恢复也将 要花费更说的时间,对整个数据表的查询也将花费更多时间.通过把一个表中的行分为几个部分,可以减少大型表的管理和性能问题 ...
- PostgreSQL PARTITION 分区表
PostgreSQL 分区表,操作性相当便捷. 但只能在创建时决定是否为分区表,并决定分区条件字段,普通表创建后,不能在修改为分区表. Note:通过其他方法也可转化为分区表. 和其他数据库一样,分区 ...
- SQLServer查看分区表详细信息
SQL查看分区内记录个数,常规方法需要知道分区函数然后再显示,网上看到一个一句话显示的方法 ), ps.name ) as partition_scheme, p.partition_number, ...
- sqlserver 创建分区表
我们知道很多事情都存在一个分治的思想,同样的道理我们也可以用到数据表上,当一个表很大很大的时候,我们就会想到将表拆 分成很多小表,查询的时候就到各个小表去查,最后进行汇总返回给调用方来加速我们的查询速 ...
- sqlserver分区表实践:对时间分区表自动进行管理
项目问题:有一张日志表,插入和查询为主,每天记录数据为200多万,大小为2G-4G之间.一开始开发人员使用delete语句手动删除,保留7天数据,经常造成阻塞和性能瓶颈.但是如果不删除数据随着表越来越 ...
- sqlserver partitition and partition table --- partition show
I can not believe that I had done this about two years Now we know there is totally different betwee ...
- hive内部表、外部表、分区表、视图
1.Table 内部表 1).与数据库中的Table在概念上是类似的 2).每一个Table在Hive中都有一个相应的目录存储数据 3).所有的Table数据(不包括 External Table) ...
- MSSQL sqlserver系统函数教程分享
摘要: 下文收集了sqlserver函数教程,为每一个函数都进行了相关举例说明, 如下所示: sqlserver聚合函数教程: mssql sqlserver avg聚合函数使用简介 mssql sq ...
- MySQL 分区表原理及数据备份转移实战
MySQL 分区表原理及数据备份转移实战 1.分区表含义 分区表定义指根据可以设置为任意大小的规则,跨文件系统分配单个表的多个部分.实际上,表的不同部分在不同的位置被存储为单独的表.用户所选择的.实现 ...
随机推荐
- 【luogu P1186】玛丽卡
https://www.luogu.org/problem/show?pid=1186 考虑暴力,枚举图上每一条边删去后跑Dijkstra,取M次的最大值. 仔细想想就会发现删除最短路以外的边对最短路 ...
- 大数加法之C语言函数法(只有正数版)
由于某些原因,我于今天2017-4-19将我的博文搬到博客园了,以后我就在这里扎根了. 之前想过在博客写文章方便日后复习,但一直未能实现,所以,现在这篇是我个人人生中第一篇博 ...
- lua游戏开发实践指南学习笔记1
本文是依据lua游戏开发实践指南做的一些学习笔记,仅用于继续自己学习的一些知识. Lua基础 1. 语言定义: 在lua语言中,标识符有非常大的灵活性(变量和函数名),只是用户不呢个以数字作为起始符 ...
- 【Cocos游戏实战】功夫小子第七课之游戏主功能场景逻辑功能和暂停功能场景的分析和实现
CSDN的markdown编辑器是吃屎了么! !.什么玩意.!写了一半写不了东西还全没了,搞个毛线! 本节课的视频教程地址是:第七课在此 假设本教程有帮助到您,希望您能点击进去观看一下,并且如今注冊成 ...
- ML学习分享系列(2)_计算广告小窥[中]
原作:面包包包包包包 改动:寒小阳 && 龙心尘 时间:2016年2月 出处:http://blog.csdn.net/Breada/article/details/50697030 ...
- [ACM] POJ 2635 The Embarrassed Cryptographer (同余定理,素数打表)
The Embarrassed Cryptographer Time Limit: 2000MS Memory Limit: 65536K Total Submissions: 11978 A ...
- 前端优化之动画为什么要尽量用css3代替js
导致JavaScript效率低的两大原因:操作DOM和使用页面动画.通常我们会通过频繁的操作 DOM的CSS来实现视觉上的动画效果,导致js效率低的两个因素都包括在内了在频繁的操作DOM和CSS时,浏 ...
- python+appium+unittest自动化测试框架环境搭建
一.基础软件准备 1.python 版本最新版本,python的IDE使用pycharm.具体的下载链接: python https://www.python.org/ pycharm:https:/ ...
- oracle如何连接别人的数据库,需要在本地添加一些配置
2.oracle如何连接别人的数据库,需要在本地添加一些配置 1.找到 listener.ora 文件,打开(一般在 C 文件夹) ORCL = (DESCRIPTION = (ADDRESS = ( ...
- InfluxDb中写入重复数据问题解决方案
1.InfluxDb版本 0.10.3 2.Measurement TodayChargeTimeReport 只有time和Field列,没有Tag列 3.现象:通过定时任务向上面的表中写入数据: ...