
在Scrapy项目【内外】使用scrapy shell命令抓取 某网站首页的初步情况
Windows 10家庭中文版,Python 3.6.3,Scrapy 1.5.0,
时隔一月,再次玩Scrapy项目,希望这次可以玩的更进一步。
本文展示使用在 Scrapy项目内、项目外scrapy shell命令抓取知乎首页的初步情况,重要的一点是,在项目内抓取时,没有response可用。
在项目【外】执行抓取命令
scrapy shell https://www.zhihu.com
得到结果(部分):因为知乎的反爬虫功能,得到了400错误,访问失败。
INFO: Overridden settings: {'DUPEFILTER_CLASS': 'scrapy.dupefilters.BaseDupeFilter', 'LOGSTATS_INTERVAL': 0}
[]
2018-08-20 09:11:54 [scrapy.extensions.telnet] DEBUG: Telnet console listening on 127.0.0.1:6023
2018-08-20 09:11:54 [scrapy.core.engine] INFO: Spider opened
2018-08-20 09:11:59 [scrapy.core.engine] DEBUG: Crawled (400) <GET https://www.zhihu.com> (referer: None)
可用对象如下图:存在response!

在项目【内】执行抓取命令
scrapy shell https://www.zhihu.com
注意,项目使用scrapy startproject命令创建,已经在其settings.py中添加了USER_AGENT配置项。
得到结果(部分):多了很多内容,还包括USER_AGENT设置。最后服务器返回200,表示页面访问成功。
INFO: Overridden settings: {'BOT_NAME': 'newssci', 'DUPEFILTER_CLASS': 'scrapy.dupefilters.BaseDupeFilter', 'LOGSTATS_INTERVAL': 0, 'NEWSPIDER_MODULE': 'newssci.spiders', 'ROBOTSTXT_OBEY': True, 'SPIDER_MODULES': ['newssci.spiders'], 'USER_AGENT': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36-480'}
[]
2018-08-20 09:12:23 [scrapy.extensions.telnet] DEBUG: Telnet console listening on 127.0.0.1:6023
2018-08-20 09:12:23 [scrapy.core.engine] INFO: Spider opened
2018-08-20 09:12:24 [scrapy.core.engine] DEBUG: Crawled (200) <GET https://www.zhihu.com/robots.txt> (referer: None)
2018-08-20 09:12:24 [scrapy.downloadermiddlewares.robotstxt] DEBUG: Forbidden by robots.txt: <GET https://www.zhihu.com>
可用对象如下图:没有response对象!还少了spider对象!
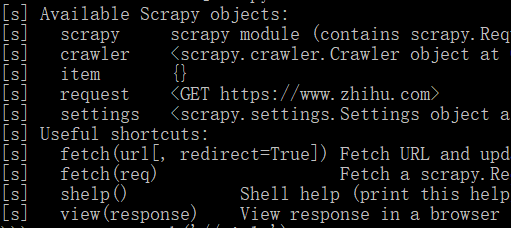
没有response对象,感觉什么也做不了了,网页也无法分析了。
总结
看来,还是需要到 项目外 使用scrapy shell命令来对网页做分析才是。不过,对于这种反爬虫的网站,在命令中添加上USER_AGENT配置项,然后就可以用response来做分析了。
项目外添加USER_AGENT配置项的命令如下:-s
scrapy shell -s USER_AGENT="Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36-480" https://www.zhihu.com
结果如下:发生了一次重定向,所以有302。
INFO: Overridden settings: {'DUPEFILTER_CLASS': 'scrapy.dupefilters.BaseDupeFilter', 'LOGSTATS_INTERVAL': 0, 'USER_AGENT': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36-480'}
[scrapy.downloadermiddlewares.redirect] DEBUG: Redirecting (302) to <GET https://www.zhihu.com/signup?next=%2F> from <GET https://www.zhihu.com>
[scrapy.core.engine] DEBUG: Crawled (200) <GET https://www.zhihu.com/signup?next=%2F> (referer: None)
发现了response对象可用:指明是针对其后的那个200网址的
[s] response <200 https://www.zhihu.com/signup?next=%2F>
使用response对象:获取页面title成功!
>>> response.xpath('//title/text()')
[<Selector xpath='//title/text()' data='知乎 - 发现更大的世界'>]
在Scrapy项目【内外】使用scrapy shell命令抓取 某网站首页的初步情况的更多相关文章
- Shell 命令行统计 apache 网站日志访问IP以及IP归属地
Shell 命令行统计 apache 网站日志访问IP以及IP归属地 我的一个站点用 apache 服务跑着,积攒了很多的日志.我想用 shell 看看有哪些人访问过我的站点,并且他来自哪里. 因为日 ...
- Scrapy爬虫框架教程(四)-- 抓取AJAX异步加载网页
欢迎关注博主主页,学习python视频资源,还有大量免费python经典文章 sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction ...
- android adb命令 抓取系统各种 log
getLog.bat: adb root adb remount adb wait-for-device adb logcat -v time > C:\log.txt 在Android中不同的 ...
- Shell脚本 | 抓取log文件
在安卓应用的测试过程中,遇到 Crash 或者 ANR 后,想必大家都会通过 adb logcat 命令来抓取日志定位问题.如果直接使用 logcat 命令的话,默认抓取出的 log 文件包含安卓运行 ...
- 重构后的程序:通过rsync命令抓取日志文件
push.sh #!/bin/bash function push() { local ip=$ local user=$ local password=$ local path=$ local lo ...
- 重构前的程序:通过rsync命令抓取日志文件
基本概况: 我有一台服务器每天每个小时都会生成一个日志文件,这些日志文件会被保留2天,超过2天会被一个程序压缩放到备份目录,日志文件的文件名是有命名要求的,例如:project_log.2013010 ...
- shell爬虫--抓取某在线文档所有页面
在线教程一般像流水线一样,页面有上一页下一页的按钮,因此,可以利用shell写一个爬虫读取下一页链接地址,配合wget将教程所有内容抓取. 以postgresql中文网为例.下面是实例代码 #!/bi ...
- shell脚本抓取网页信息
利用shell脚本分析网站数据 # define url time=$(date +%F) mtime=$(date +%T) file=/abc/shell/abc/abc_$time.log ht ...
- git 常用命令--抓取分支-为自己记录(二)
二:抓取分支: 多人协作时,大家都会往master分支上推送各自的修改.现在我们可以模拟另外一个同事,可以在另一台电脑上(注意要把SSH key添加到github上)或者同一台电脑上另外一个目录克隆, ...
随机推荐
- CopyOnWriteArrayList、CopyOnWriteArraySet、ConcurrentHashMap的实现原理和适用场景
ConcurrentHashMap代替同步的Map(Collections.synchronized(new HashMap())),众所周知,HashMap是根据散列值分段存储的,同步Map在同步的 ...
- EntityFramework异常The specified cast from a materialized 'System.Double' type to the 'System.Single' type is not valid.
实体类: public class ReportEntity { public string FactorName { get; set; } public double MaxVal { get; ...
- quartz.net 3.x版本如何通过xml文件进行Job配置
在2.x版本中,我们可以简单的在quartz.config文件中通过以下Xml配置方式来注册相应的Job以及触发器 quartz.plugin.xml.type = Quartz.Plugin.Xml ...
- CUDA ---- 线程配置
前言 线程的组织形式对程序的性能影响是至关重要的,本篇博文主要以下面一种情况来介绍线程组织形式: 2D grid 2D block 线程索引 矩阵在memory中是row-major线性存储的: 在k ...
- MVC 锚点
MVC 锚点 linkText:生成的链接所显示的文字 actionName:对应控制器的方法 routeValues:向对应的action传递的参数 controlName:指定控制器的名称 htm ...
- oracle 获取当前用户下的所有表名与字段信息
select *from user_col_commentswhere substr(table_name,1,3)<>'BIN'
- 解题:AT2064 Many Easy Problems&EXNR #1 T3 两开花
题面 两道题比较像,放在一起写了,后者可以看成前者的加强版 (sto ztb orz) 先看AT那道题 考虑计算每个点的贡献,用容斥计算:每个点没有贡献当且仅当选的所有点都在以他为根时的一个子节点的子 ...
- ubuntu 指定用户执行脚本
方法 创建可执行脚本 以下以脚本名称为superset.sh为例,具体的脚本内容大家可以自己发挥. cd ~ vi superset.sh # 脚本内容自己写好后保存 修改脚本权限 sudo chmo ...
- saltstack主机管理项目【day23】:主机管理项目需求分析-设计
本节内容 一. 主机管理项目需求分析 二 .主机管理项目架构设计 三.主机管理项目初始构建 四. 主机管理项目编主机分发器 一. 主机管理项目需求分析 场景:我现在又一台裸机要实现一下人物 配置管理: ...
- WebService和Http的POST和GET请求区别和示例
web service(SOAP) Webservice的一个最基本的目的就是提供在各个不同平台的不同应用系统的协同工作能力.Web service 就是一个应用程序,它向外界暴露出一个能够通过Web ...