
Mapperreduce的wordCount原理
wordcount原理:
1.mapper(Object key,Object value ,Context contex)阶段
2.从数据源读取一行数据传递给mapper函数的value
3.处理数据并将处理结果输出到reduce中去
String line = value.toString();
String[] words = line.split(" ");
context.write(word,1)
4.reduce(Object key ,List<value> values ,Context context)阶段
遍历values累加技术结果,并将数据输出
context.write(word,1)
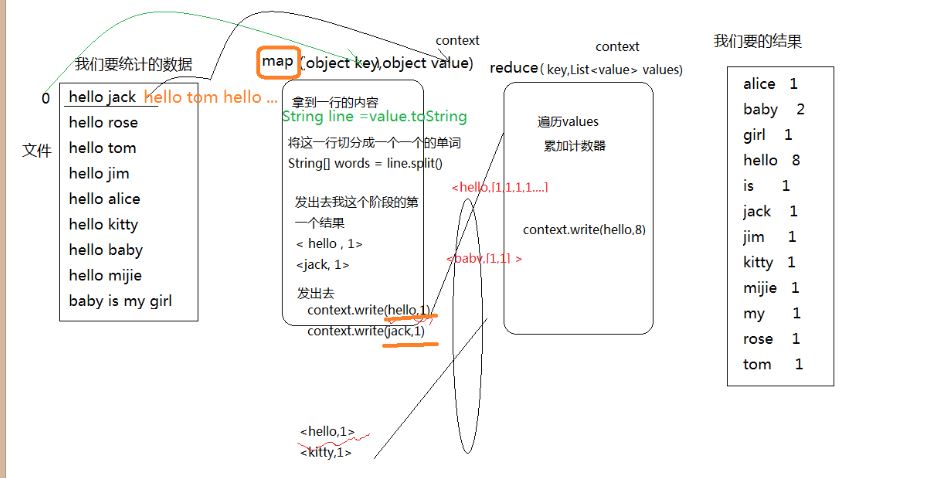
代码示例:
Mapper类:
package com.hadoop.mr;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

/**

 * Mapper <Long, String, String, Long>

 * Mapper<LongWritable, Text, Text, LongWritable>//hadoop对上边的数据类型进行了封装

 *  LongWritable(Long):偏移量

 *  Text(String):输入数据的数据类型

 *  Text(String):输出数据的key的数据类型

 *  LongWritable(Long):输出数据的key的数据类型

 * @author shiwen

 */

public class WordCountMapper extends Mapper<LongWritable, Text, Text, LongWritable>{

    @Override

    protected void map(LongWritable key, Text value,

            Mapper<LongWritable, Text, Text, LongWritable>.Context context)

            throws IOException, InterruptedException {

        //1.读取一行

        String line = value.toString();

        //2.分割单词

        String[] words = line.split(" ");

        //3.统计单词

        for(String word : words){

            //4.输出统计

            context.write(new Text(word), new LongWritable(1));

        }

    }

}
reduce类
package com.hadoop.mr;

import java.io.IOException;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

public class WordCountReduce extends Reducer<Text, LongWritable, Text, LongWritable>{

    @Override

    protected void reduce(Text key, Iterable<LongWritable> values,

            Reducer<Text, LongWritable, Text, LongWritable>.Context context)

            throws IOException, InterruptedException {

        long count = 0;

        //1.遍历vlues统计数据

        for(LongWritable value : values){

            count += value.get();

        }

        //输出统计

        context.write(key, new LongWritable(count));

    }

}
运行类:
package com.hadoop.mr;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import com.sun.jersey.core.impl.provider.entity.XMLJAXBElementProvider.Text;

public class WordCountRunner {

    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {

        //1.创建配置对象

        Configuration config = new Configuration();

        //2.Job对象

        Job job = new Job(config);

        //3.设置mapperreduce所在的jar包

        job.setJarByClass(WordCountRunner.class);

        //4.设置mapper的类

        job.setMapOutputKeyClass(WordCountMapper.class);

        //5.设置reduce的类

        job.setReducerClass(WordCountReduce.class);

        //6.设置reduce输入的key的数据类型

        job.setOutputKeyClass(Text.class);

        //7.设置reduce输出的value的数据类型

        job.setOutputValueClass(LongWritable.class);

        //8.设置输入的文件位置

        FileInputFormat.setInputPaths(job, new Path("hdfs://192.168.1.10:9000/input"));

        //9.设置输出的文件位置

        FileOutputFormat.setOutputPath(job, new Path("hdfs://192.168.1.10:9000/input"));

        //10.将任务提交给集群

        job.waitForCompletion(true);

    }

}
Mapperreduce的wordCount原理的更多相关文章
- Hive实现WordCount详解
一.WordCount原理 初学MapReduce编程,WordCount作为入门经典,类似于初学编程时的Hello World.WordCount的逻辑就是给定一个/多个文本,统计出文本中每次单词/ ...
- 4、wordcount程序原理剖析及Spark架构原理
一.wordcount程序原理深度剖析 二.Spark架构原理 1.
- MapReduce本地运行模式wordcount实例(附:MapReduce原理简析)
1. 环境配置 a) 配置系统环境变量HADOOP_HOME b) 把hadoop.dll文件放到c:/windows/System32目录下 c) ...
- Hadoop WordCount单词计数原理
计算文件中出现每个单词的频数 输入结果按照字母顺序进行排序 编写WordCount.java 包含Mapper类和Reducer类 编译WordCount.java javac -classpath ...
- Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark Streaming简介 1.1 概述 Spark Streaming 是Spa ...
- hadoop运行原理之Job运行(二) Job提交及初始化
本篇主要介绍Job从客户端提交到JobTracker及其被初始化的过程. 以WordCount为例,以前的程序都是通过JobClient.runJob()方法来提交Job,但是现在大多用Job.wai ...
- MapReduce编程job概念原理
在Hadoop中,每个MapReduce任务都被初始化为一个job,每个job又可分为两个阶段:map阶段和reduce阶段.这两个阶段分别用两个函数来表示.Map函数接收一个<key,valu ...
- JStorm第一个程序WordCount详解
一.Strom基本知识(回顾) 1,首先明确Storm各个组件的作用,包括Nimbus,Supervisor,Spout,Bolt,Task,Worker,Tuple nimbus是整个storm任务 ...
- 开源分布式实时计算引擎 Iveely Computing 之 WordCount 详解(3)
WordCount是很多分布式计算中,最常用的例子,例如Hadoop.Storm,Iveely Computing也不例外.明白了WordCount在Iveely Computing上的运行原理,就很 ...
随机推荐
- 数据仓库3NF基础理论和实例
一.引言 最近在梳理大数据模式下的数据仓库数据模型,花了点时间,系统的回顾一下传统数据仓库数据模型设计的理论,作为笔记分享给大家,很多资料来自互联网和读过的数据仓库理论和实践相关的熟悉,无剽窃之心,共 ...
- itertools库 combinations() 和 permutations() 组合 和 排列选项的方法
combinations方法重点在组合,permutations方法重在排列. combinations和permutations返回的是对象地址,原因是在python3里面,返回值已经不再是list ...
- Web jsp开发学习——Session使用
先展示效果: 导包: 在servlet的doget里创建session 在head里显示session 接下来进行注销的命令 点击注销链接到这个 ...
- STM32 f407 温湿度采集报警
软件 keil5 实现 1.使用stm32f407中的DS18B20传感器采集空气温度 2.使用stm32f407中的DHT11传感器采集空气的温度和湿度 3.显示到stm32f407的LCD液晶显示 ...
- Jmeter(二)Jmeter目录介绍
看过许多有关Jmeter的博客,算得上的收获颇丰:不过最牛逼的博客还是“官方文档”,官方文档是ApacheJmeter自己对自己产品的说明,论起对自己产品的理解程度,那肯定是自己嘛...因此推荐大家从 ...
- 三种方式控制GPIO
BBB为REV C,emmc4G版本,系统为Debian 7.9 wheezy (2015.11.12),内核为Linux 3.8.13.使用命令cat /etc/dogtag查看 查看系统信息的四种 ...
- (转)Linux netstat命令详解
简介 Netstat 命令用于显示各种网络相关信息,如网络连接,路由表,接口状态 (Interface Statistics),masquerade 连接,多播成员 (Multicast Member ...
- SSL&HTTPS简单介绍
这篇是最近看SSL和HTTPS的一个简单性总结,其中内容大部分都是参考网络上的内容,自己归纳整理了下. SSL介绍 HTTPS介绍 HTTP请求数据工作流程: l 用户在浏览器中输入网址,并告诉浏览 ...
- async方法:async+await
using System; using System.Collections.Generic; using System.Linq; using System.Text; using System.T ...
- CPU Rings, Privilege, and Protection.CPU的运行环, 特权级与保护
原文标题:CPU Rings, Privilege, and Protection 原文地址:http://duartes.org/gustavo/blog/ [注:本人水平有限,只好挑一些国外高手的 ...