
大数据入门第二十二天——spark(二)RDD算子(2)与spark其它特性
一、JdbcRDD与关系型数据库交互
虽然略显鸡肋,但这里还是记录一下(点开JdbcRDD可以看到限制比较死,基本是鸡肋。但好在我们可以通过自定义的JdbcRDD来帮助我们完成与关系型数据库的交互。这点和Hadoop需要借助sqoop等工具进行是有优势的!)
给出一个demo的参考链接:https://www.2cto.com/database/201705/635388.html
二、RDD依赖关系
1.窄依赖
窄依赖指的是每一个父RDD的Partition最多被子RDD的一个Partition使用
总结:窄依赖我们形象的比喻为独生子女
2.宽依赖
宽依赖指的是多个子RDD的Partition会依赖同一个父RDD的Partition
总结:宽依赖我们形象的比喻为超生(有shuffer的阶段)
shuffle 是划分 DAG 中 stage 的标识,同时影响 Spark 执行速度的关键步骤.
造成了数据在内存中的重新分布,即 shuffle 操作.shuffle 操作是 spark 中最耗时的操作,应尽量避免不必要的 shuffle.
3.lineage血统
RDD只支持粗粒度转换,即在大量记录上执行的单个操作。将创建RDD的一系列Lineage(即血统)记录下来,以便恢复丢失的分区。
RDD的Lineage会记录RDD的元数据信息和转换行为,当该RDD的部分分区数据丢失时,它可以根据这些信息来重新运算和恢复丢失的数据分区。
三、RDD缓存
Spark速度非常快的原因之一,就是在不同操作中可以在内存中持久化或缓存个数据集。当持久化某个RDD后,每一个节点都将把计算的分片结果保存在内存中,并在对此RDD或衍生出的RDD进行的其他动作中重用。这使得后续的动作变得更加迅速。RDD相关的持久化和缓存,是Spark最重要的特征之一。可以说,缓存是Spark构建迭代式算法和快速交互式查询的关键。
RDD缓存方式:
RDD通过persist方法或cache方法可以将前面的计算结果缓存,但是并不是这两个方法被调用时立即缓存,而是触发后面的action时,该RDD将会被缓存在计算节点的内存中,并供后面重用。
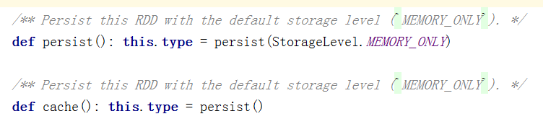
// 通过查看源码发现cache最终也是调用了persist方法,默认的存储级别都是仅在内存存储一份,Spark的存储级别还有好多种,存储级别在object StorageLevel中定义的。
缓存有可能丢失,或者存储存储于内存的数据由于内存不足而被删除,RDD的缓存容错机制保证了即使缓存丢失也能保证计算的正确执行。通过基于RDD的一系列转换,丢失的数据会被重算,由于RDD的各个Partition是相对独立的,因此只需要计算丢失的部分即可,并不需要重算全部Partition。
使用方式:
在spark-shell中可以通过cache来测试缓存是否真的可用:
val rdd1 = sc.textFile("hdfs://mini1:9000/input").cache()

// 上面是一个转换算子,将会在行动算子执行时开始缓存

rdd1.count

// 再次执行将会有缓存!(也可以通过UI界面进行查看!)

rdd1.count
在代码中同理,具体缓存策略也可以在代码中查看!
释放缓存:
rdd.unpersisit(true)
四、RDD的checkpoint
checkpoint有点儿类似系统里边的还原点,这样可以方便的回到某个曾经定义的还原点。
相比利用血统Lineage来重新计算,显然checkpoint会高效很多。保存一些重要的中间结果,非常必要!
使用示例:需要先设置checkpoint的目录,然后再使用,记住checkpoint也是一个Transformation
:https://www.iteblog.com/archives/1278.html
使用注意点:最好先进行内存的持久化(例如cache()方法,但是注意cache也是一个Transformation,需要先执行Action才能实际缓存)
https://blog.csdn.net/xiao_jun_0820/article/details/50475351
五、Spark执行流程
参考:https://www.cnblogs.com/1130136248wlxk/articles/6289717.html
由RDD Object->DAG Scheduler->TaskScheduler->Worker
大数据入门第二十二天——spark(二)RDD算子(2)与spark其它特性的更多相关文章
- 大数据入门第二十二天——spark(二)RDD算子(1)
一.RDD概述 1.什么是RDD RDD(Resilient Distributed Dataset)叫做分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变.可分区.里面的元素可并行计算的 ...
- 大数据入门第二十二天——spark(一)入门与安装
一.概述 1.什么是spark 从官网http://spark.apache.org/可以得知: Apache Spark™ is a fast and general engine for larg ...
- 大数据入门第二十二天——spark(三)自定义分区、排序与查找
一.自定义分区 1.概述 默认的是Hash的分区策略,这点和Hadoop是类似的,具体的分区介绍,参见:https://blog.csdn.net/high2011/article/details/6 ...
- 大数据入门第二十四天——SparkStreaming(二)与flume、kafka整合
前一篇中数据源采用的是从一个socket中拿数据,有点属于“旁门左道”,正经的是从kafka等消息队列中拿数据! 主要支持的source,由官网得知如下: 获取数据的形式包括推送push和拉取pull ...
- 大数据入门第二十五天——elasticsearch入门
一.概述 推荐路神的ES权威指南翻译:https://es.xiaoleilu.com/010_Intro/00_README.html 官网:https://www.elastic.co/cn/pr ...
- 大数据入门第二十三天——SparkSQL(一)入门与使用
一.概述 1.什么是sparkSQL 根据官网的解释: Spark SQL is a Spark module for structured data processing. 也就是说,sparkSQ ...
- 大数据入门第二十三天——SparkSQL(二)结合hive
一.SparkSQL结合hive 1.首先通过官网查看与hive匹配的版本 这里可以看到是1.2.1 2.与hive结合 spark可以通过读取hive的元数据来兼容hive,读取hive的表数据,然 ...
- 大数据入门第二十四天——SparkStreaming(一)入门与示例
一.概述 1.什么是spark streaming Spark Streaming is an extension of the core Spark API that enables scalabl ...
- 大数据入门到精通5--spark 的 RDD 的 reduce方法使用
培训系列5--spark 的 RDD 的 reduce方法使用 1.spark-shell环境下准备数据 val collegesRdd= sc.textFile("/user/hdfs/C ...
随机推荐
- Java内部类的介绍
在Java的面向对象编程中,由于Java并没有类似C++的多重继承,所以采用了内部类这样的方式,现在介绍几种内部类的常见情况. 公开内部类 即由public关键词修饰的内部类,内部类作为外部类的一个成 ...
- 搭建ReactNative时的最普遍的错误—— ":CFBundleIdentifier", Does Not Exist
报错 ":CFBundleIdentifier", Does Not Exist 今天搭建Reactnative 报错 注意当你第一次搭建RN时,包体下载的都是最新的版本,由于现在 ...
- IT的2017,面临数字生态系统新挑战,该怎么办?
所谓数字生态系统,就是包含一系列基于标准,规模可变的硬件.软件.数字设备和服务,可系统地实现企业信息数字化,数据流通,以帮助企业提高运营效率. 随着越来越多的中国企业加入数字生态系统,中国CIO在技术 ...
- Java Web工程搭建方法
搭建一个简单的Web工程主要是以下几步: 一.下载所需工具 ①java ②eclipse ③tomcat 注意:java与eclipse版本不匹配(32位或者64位),会导致eclipse启动时 ...
- Git仓库初始化与推送到远端仓库
以下命令为Git仓库初始化,添加远端代码托管仓库,以及推送到远端仓库的命令. 以 "github.com"为远端仓库做示例 # Git 库初始化 git init # 将文件添加到 ...
- Android aapt 工具介绍(转)
目录 AAPT 工具介绍 AAPT 的帮助信息 查看AAPT的版本 使用AAPT列出资源包apk文件列表 使用AAPT打包资源文件 使用AAPT解压资源包apk 来自:http://mmmyddd ...
- c#中(&&,||)与(&,|)的区别和应用
对于(&&,||),运算的对象是逻辑值,也就是True/False &&相当与中文的并且,||相当于中文的或者 .(叫做逻辑运算符又叫短路运算符) 运算结果只有下列四种 ...
- Python3部分Print输出格式
print("Hello World!") #直接打印字符串 print('Hello World!') #对于python,单引号也可以表示字符串 name = 'Tom' #自 ...
- [Redis_1] Redis 介绍 && 安装
0. 说明 Redis 介绍 && 安装 1. Redis 介绍 2. Redis 安装(Windows 10) [2.1 解压 redis-2.2.2-win32-win64.rar ...
- 【redis】redis的雪崩和穿透
1.什么是缓存穿透 一般的缓存系统,都是按照key值去缓存查询,如果不存在对应的value,就应该去DB中查找 .这个时候,如果请求的并发量很大,就会对后端的DB系统造成很大的压力.这就叫做缓存穿透. ...