
未来云原生世界的“领头羊”:容器批量计算项目Volcano 1.0版本发布
在刚刚结束的CLOUD NATIVE+ OPEN SOURCE Virtual Summit China 2020上,由华为云云原生团队主导的容器批量计算项目Volcano正式发布1.0版本,标志着Volcano项目已经开始走向成熟与稳定。
Volcano项目介绍
Volcano是基于Kubernetes的云原生批量计算引擎,基于华为云在AI、大数据领域的深厚业务积累,补齐了Kubernetes在面向AI、大数据、高性能计算等批量计算任务调度、编排等场景下的短板,向下支持鲲鹏、昇腾、X86等多元算力,向上使能TensorFlow、Spark、华为MindSpore等主流行业计算框架,让数据科学家和算法工程师充分享受到云原生技术所带来的高效计算与极致体验。
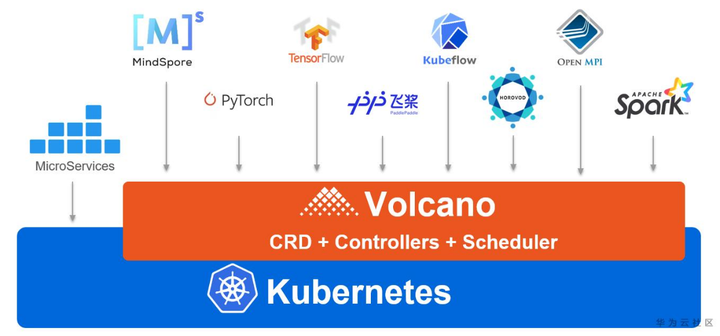
Volcano架构示意图
随着Kubernetes作为AI、大数据和高性能批量计算的下一代基础设施的趋势逐渐清晰,越来越多的企业对Kubernetes在深度学习、科学计算、高性能渲染等方面提出了更高的要求。
然而Kubernetes作为普适的容器化解决方案,仍与业务诉求存在一定差距,主要体现在:
- K8s的原生调度功能无法满足计算要求
- K8s作业管理能力无法满足AI训练的复杂诉求
- 数据管理方面,缺少计算侧数据缓存能力,数据位置感知等功能
- 资源管理方面缺少分时共享,利用率低
- 硬件异构能力弱
Volcano的诞生正是基于这些痛点,在调度、作业管理、数据管理、资源管理四个方面进行了重点优化。
- 增强了任务调度能力,如公平的调度(fair-share)、组调度(gang-scheduling)
- 进一步优化了作业管理能力,如multiple pod template能力、更灵活的error handling机制
- 增加计算侧数据缓存,提升数据的传输与读取效率
- 引入多维度的综合评分机制,实现资源更高效的管理和分配
- 多元算力支持:支持x86、鲲鹏和昇腾等算力
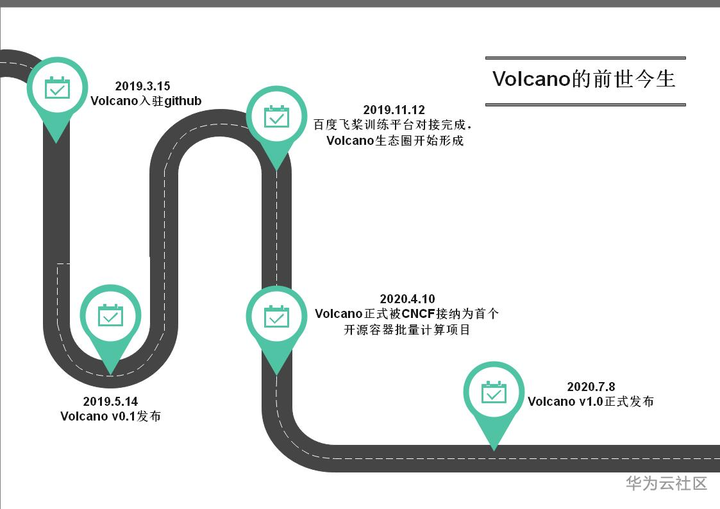
Volcano v1.0新特性介绍
Volcano v1.0的核心概念和关键特性,主要包含以下要点:
- Queue、PodGroup、Volcano Job等核心概念均已实现
- 支持Binpack、Conformance、DRF、Gang、Preempt、Reclaim、Priority、Proportion等多种调度策略
- 支持Rest API、CLI等多种交互方式
- 完成与Spark、Argo、MPI、Flink、Mxnet、Paddlepaddle、Tensorflow、MindSpore等主流高性能计算框架的无缝对接
- 支持Job的全生命周期管理和动态扩缩容
- 支持GPU异构与共享
- 完备的golangCI-lint check、e2e以建立增强代码质量和稳定性
除以上特性外,Volcano始终保持与Kubernetes社区、Golang最新版本保持一致。
Volcano社区和生态建设进展
经过一年多的发展,Volcano的社区和生态建设已经步入快车道。截至目前,社区和生态建设取得了以下成绩:
- 社区贡献者80+
- 社区贡献参与组织15+,包括华为、百度、腾讯、AWS、IBM、 Oracle等
- 获得Star 1100+,Fork 220+
- 代码库7个,Release 6个
- Issue 320+,PR 590+
- 已完成对Spark、Argo、MPI、Flink、Mxnet、Paddlepaddle、Tensorflow、MindSpore、Cromwell等10+主流计算框架的支持
- 华为云CCE(云容器引擎)、CCI(云容器实例)、ModelArts等多个云服务已将Volcano集成为基础设施底座并商用,服务领域已涵盖AI、大数据应用、基因计算、批处理等场景,并实现与华为鲲鹏、昇腾处理器深度融合,最快每秒1000个容器的调度发放,成为高性能、极致性价比的批量计算解决方案。
深入了解Volcano
如果想更加深入了解Volcano,可以参考以下资源:
Volcano官网:
https://volcano.sh/
Github:
https://github.com/volcano-sh
Volcano简介:
https://github.com/volcano-sh/volcano
Volcano设计:
https://github.com/volcano-sh/volcano/tree/master/docs/design
Volcano路线图:
https://github.com/volcano-sh/volcano/blob/master/docs/community/roadmap.md
Volcano社区交流微信群:
Volcano CN
未来可期
随着Volcano v1.0的发布,Volcano社区建设与上下游生态的融合必将更加紧密,基于Volcano的商业应用也将极大地促进AI、大数据、科学计算、渲染等领域充分享受到云计算带来的极大便利和极致体验,助力企业数字化转型进入新的高度。
展望未来,华为云也将在云原生领域持续耕耘,持续引领创新、繁荣生态,助力各行业走向快速智能发展之路。
未来云原生世界的“领头羊”:容器批量计算项目Volcano 1.0版本发布的更多相关文章
- 重磅!业界首个云原生批量计算项目Volcano正式晋级为CNCF孵化项目
摘要:4月7日,云原生计算基金会(CNCF)宣布,由华为云捐献的业界首个云原生批量计算项目Volcano正式晋级为CNCF孵化项目. 4月7日,云原生计算基金会(CNCF)宣布,由华为云捐献的业界首个 ...
- 谈到云原生, 绕不开"容器化"
传送门 什么是云原生? 云原生设计理念 .NET微服务 Containers 现在谈到云原生, 绕不开"容器". 在<Cloud Native Patterns>一书中 ...
- 支持边云协同终身学习特性,KubeEdge子项目Sedna 0.3.0版本发布!
摘要:随着边缘设备数量指数级增长以及设备性能的提升,边云协同机器学习应运而生,以期打通机器学习的最后一公里. 本文分享自华为云社区<支持边云协同终身学习特性,KubeEdge子项目Sedna 0 ...
- 云原生交付加速!容器镜像服务企业版支持 Helm Chart
2018 年 6 月,Helm 正式加入了 CNCF 孵化项目:2018 年 8 月,据 CNCF 的调研表明,有百分之六十八的开发者选择了 Helm 作为其应用包装方案:2019 年 6 月,阿里云 ...
- 未来云原生 | CIF 论坛精彩看点
当下云原生技术正在飞速发展,那么如何准确理解「云原生」?在发展不够成熟,行业认知差异大的情况下,不论是云原生计算基金会(CNCF),还是行业的任何大咖,都不能给出精确的.便于理解的定义.我们要理解的逻 ...
- 云原生时代之Kubernetes容器编排初步探索及部署、使用实战-v1.22
概述 **本人博客网站 **IT小神 www.itxiaoshen.com Kubernetes官网地址 https://kubernetes.io Kubernetes GitHub源码地址 htt ...
- 初探云原生应用管理之:聊聊 Tekton 项目
[编者的话]“人间四月芳菲尽,山寺桃花始盛开.” 越来越多专门给 Kubernetes 做应用发布的工具开始缤纷呈现,帮助大家管理和发布不断增多的 Kubernetes 应用.在做技术选型的时候,我们 ...
- Volcano火山:容器与批量计算的碰撞
[摘要] Volcano是基于Kubernetes构建的一个通用批量计算系统,它弥补了Kubernetes在“高性能应用”方面的不足,支持TensorFlow.Spark.MindSpore等多个领域 ...
- 从Vessel到二代裸金属容器,云原生的新一波技术浪潮涌向何处?
摘要:云原生大势,深度解读华为云四大容器解决方案如何加速技术产业融合. 云原生,可能是这两年云服务领域最火的词. 相较于传统的应用架构,云原生构建应用简便快捷,部署应用轻松自如.运行应用按需伸缩,是企 ...
随机推荐
- 数据可视化之 图表篇(三)体验Power BI最新发布的AI图表:分解树
在刚刚发布的11月更新中,PowerBI界面全新改版,采用和Office套件相似的Ribbon风格,除了这个重大变化,还发布了一个AI黑科技图表:分解树(Decomposition Tree). 无论 ...
- Reface.AppStarter 基本示例
Reface.AppStarter 向应用层提供以下几项 核心 功能 以模块化组织你的应用程序 自动注册组件至 IOC 容器 自动映射配置文件至配置类 在模块定义类中额外追加组件至 IOC 容器 在模 ...
- P1039 侦探推理(洛谷)
昨天做了一个非常神奇的题,告诉我们做题之前一定要好好检测评测姬! 明明同学最近迷上了侦探漫画<柯南>并沉醉于推理游戏之中,于是他召集了一群同学玩推理游戏.游戏的内容是这样的,明明的同学们先 ...
- Spring-Boot 多数据源配置+动态数据源切换+多数据源事物配置实现主从数据库存储分离
一.基础介绍 多数据源字面意思,比如说二个数据库,甚至不同类型的数据库.在用SpringBoot开发项目时,随着业务量的扩大,我们通常会进行数据库拆分或是引入其他数据库,从而我们需要配置多个数据源. ...
- 扩展BSGS
\(BSGS\) 求解\(a^x\equiv b\pmod p\),且\(a\)与\(p\)互质 由\(a^{φ(p)}\equiv1 \pmod p\)和\(a^0\equiv 1\pmod p\) ...
- Echarts柱状图顶部加数量显示
//加在series中itemStyle: { normal: { label: { show: true, position: 'top', textStyle: { color: '#615a5a ...
- django-celery 版本 常用命令
http://celery.github.io/django-celery/introduction.html #先启动服务器 python manage.py runserver #再启动worke ...
- 关于Type-C扩展坞干扰路由器交换机的解决方案
近期看到网友反馈Type-C扩展坞干扰交换机的问题,具体表现为USB Type-C扩展坞在同时插上网线和PD充电的情况下,引起路由器或交换机死机,导致局域网断开的情况.经实测分析,原因为部分电脑默认设 ...
- 线上CUP负载过高排查方法
1.top命令查看线程占据的CPU 注意:上面行的cpu是多个内核的平均CPU,不可能超过100% 下面的cpu是每个进程实际占用的cpu,可能超过100% 备注:查看多个内核cpu,只需要在输入 ...
- seaborn分类数据可视化:散点图|箱型图|小提琴图|lv图|柱状图|折线图
一.散点图stripplot( ) 与swarmplot() 1.分类散点图stripplot( ) 用法stripplot(x=None, y=None, hue=None, data=None, ...