
Ⅲ Dynamic Programming
Dictum:
A man who is willing to be a slave, who does not know the power of freedom. -- Beck
动态规划(Dynamic Programming, DP)是基于模型的方法,即在给定一个利用MDP描述的完备的环境模型下可以计算出最优策略的优化算法。
DP的两种性质:1.最优子结构:问题的最优解法可以被分为若干个子问题;2.重叠子问题:子问题之间存在递归关系,解法是可以被重复利用的。在强化学习中,MDP满足两个性质,DP的关键思想就是利用价值函数组织并结构化对好的策略的搜索。
策略评估
策略评估(Policy Evaluation)也被称为“预测问题”,就是计算任意一个随机策略\(\pi\)的状态价值函数\(v_\pi\)的问题。
在MDP中,由公式\((2.11)\)最终得到了状态价值函数的贝尔曼方程:\(v_ \pi(s)=\displaystyle \sum_a\pi(a|s) \sum_{s^\prime.r} p(s^\prime,r|s,a) [r+\gamma v_\pi(s^\prime)]\),该方程可以通过迭代法求解,方法如下:
- 将状态价值函数序列记为\(\left\{ v_0,v_1,...,v_k\right\}\)
- \(v_0\)作为初始状态价值函数,任意取值(在终止状态时,取值必须为0)
- 通过下面的公式进行迭代$$v_{k+1}=\displaystyle \sum_a\pi(a|s) \sum_{s^\prime.r} p(s^\prime,r|s,a) [r+\gamma v_k(s^\prime)] \tag{3.1}$$
序列\(\left\{v_k\right\}\)在\(k \rightarrow \infty\)时将收敛于\(v_\pi\)。该方法需要两个数组:一个用于存储旧的\(v_k(s)\),另一个用于存储新的\(v_{k+1}(s)\)。也可以每次直接用新状态价值函数替换旧状态价值函数,这就是"in-place"更新。
价值迭代
上述的策略评估方法是一个多次遍历状态集合的迭代过程,因此,可以通过价值迭代(Value Iteration)来缩短策略评估的步骤,公式如下:
v_{k+1}(s)
& \doteq \max_a \mathbb{E}[R_{t+1}+ \gamma v_k(S_{t+1}|S_t=s,A_t=a)] \\
&=\max_a \displaystyle \sum_{s^\prime,r}p(s^\prime,r|s,a)[r+\gamma v_k(s^\prime)]
\end{aligned} \tag{3.2}
\]
通过公式\((3.2)\)可以在一次遍历后立即停止策略评估,只需要对每个状态更新一次,从而提升计算效率。
策略改进
通过策略评估得出策略的状态价值函数,可以根据策略改进定理(policy improvement theorem)选择出贪心策略:
对于任意两个确定策略\(\pi\)和\(\pi^\prime\),\(\forall s \in \mathcal{S},q_\pi(s,\pi^\prime(s)) \geq v_\pi(s)\),则策略\(\pi^\prime\)不劣于\(\pi\)。
在这种情况下,\(v_{\pi^\prime}(s) \geq v_\pi(s)\)。证明过程如下
v_{\pi}(s)
& \leq q_{\pi}\left(s, \pi^{\prime}(s)\right) \\
&=\mathbb{E}\left[R_{t+1}+\gamma v_{\pi}\left(S_{t+1}\right) | S_{t}=s, A_{t}=\pi^{\prime}(a)\right] \\
&=\mathbb{E}_{\pi^{\prime}}\left[R_{t+1}+\gamma v_{\pi}\left(S_{t+1}\right) | S_{t}=s\right] \\
& \leq \mathbb{E}_{\pi^{\prime}}\left[R_{t+1}+\gamma q_{\pi}\left(S_{t+1}, \pi^{\prime}\left(S_{t+1}\right)\right) | S_{t}=s\right] \\
&=\mathbb{E}_{\pi^{\prime}}\left[R_{t+1}+\gamma \mathbb{E}_{\pi^{\prime}}\left[R_{t+2}+\gamma v_{\pi}\left(S_{t+2}\right)\right] | S_{t}=s\right] \\
&=\mathbb{E}_{\pi^{\prime}}\left[R_{t+1}+\gamma R_{t+2}+\gamma^{2} v_{\pi}\left(S_{t+2}\right) | S_{t}=s\right] \\
& \leq \mathbb{E}_{\pi^{\prime}}\left[R_{t+1}+\gamma R_{t+2}+\gamma^{2} R_{t+3}+\gamma^{3} v_{\pi}\left(S_{t+3}\right) | S_{t}=s\right] \\
& \qquad \vdots \\
& \leq \mathbb{E}_{\pi^{\prime}}\left[R_{t+1}+\gamma R_{t+2}+\gamma^{2} R_{t+3}+\gamma^{3} R_{t+4}+\cdots | S_{t}=s\right] \\
&=v_{\pi^{\prime}}(s)
\end{aligned} \tag{3.3}
\]
由此,可以推出贪心策略\(\pi^\prime\),满足
\pi^{\prime}(s)
& \doteq \underset{a}{\arg \max } q_{\pi}(s, a) \\
&=\underset{a}{\operatorname{argmax}} \mathbb{E}\left[R_{t+1}+\gamma v_{\pi}\left(S_{t+1}\right) | S_{t}=s, A_{t}=a\right] \\
&=\underset{a}{\operatorname{argmax}} \sum_{s^{\prime}, r} p\left(s^{\prime}, r | s, a\right)\left[r+\gamma v_{\pi}\left(s^{\prime}\right)\right]
\end{aligned} \tag{3.4}
\]
同时,可以写出它的状态价值函数:
v_{\pi^{\prime}}(s)
&=\max _{a} \mathbb{E}\left[R_{t+1}+\gamma v_{\pi^{\prime}}\left(S_{t+1}\right) | S_{t}=s, A_{t}=a\right] \\
&=\max _{a} \sum_{s^{\prime}, r} p\left(s^{\prime}, r | s, a\right)\left[r+\gamma v_{\pi^{\prime}}\left(s^{\prime}\right)\right] \\
&=v_*(s)
\end{aligned} \tag{3.5}
\]
策略迭代
通过下面的链式方法,可以得到一个不断改进的策略和状态价值函数的序列:
\]
\(\stackrel{E}{\longrightarrow}\)表示策略评估,\(\stackrel{I}{\longrightarrow}\)表示策略改进,每一次的策略评估都是一个迭代计算的过程,需要基于前一个策略的状态价值函数开始计算。
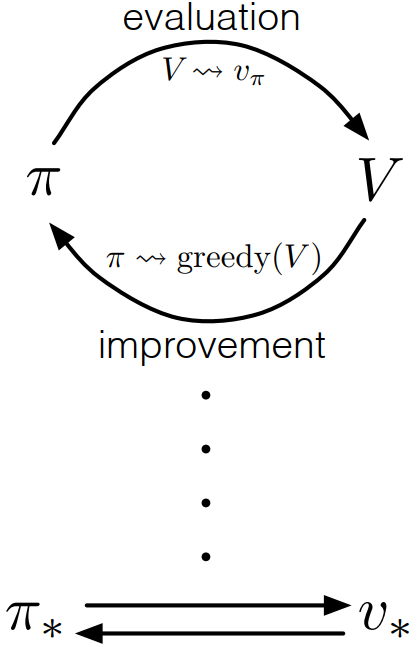

由上图可知,策略迭代(Policy Iteration)是通过策略评估和策略改进不断交互,使策略和状态价值函数最终收敛为最优。
异步动态规划
上述的都是同步动态规划(Synchronous Dynamic Programming),它们的缺点是需要对MDP的整个状态集进行遍历。异步动态规划(Asynchronous Dynamic Programming)使使用任意可用的状态值,以任意规则进行更新,为了确保能够正确收敛,异步动态规划必须不断更新所有状态的值。
References
Richard S. Sutton and Andrew G. Barto. Reinforcement Learning: An Introduction (Second Edition). 2018.
Csaba Szepesvári. Algorithms for Reinforcement Learning. 2009.
Course: UCL Reinforcement Learning Course (by David Silver)
Ⅲ Dynamic Programming的更多相关文章
- 动态规划 Dynamic Programming
March 26, 2013 作者:Hawstein 出处:http://hawstein.com/posts/dp-novice-to-advanced.html 声明:本文采用以下协议进行授权: ...
- Dynamic Programming
We began our study of algorithmic techniques with greedy algorithms, which in some sense form the mo ...
- HDU 4223 Dynamic Programming?(最小连续子序列和的绝对值O(NlogN))
传送门 Description Dynamic Programming, short for DP, is the favorite of iSea. It is a method for solvi ...
- hdu 4223 Dynamic Programming?
Dynamic Programming? Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/65536 K (Java/Oth ...
- 算法导论学习-Dynamic Programming
转载自:http://blog.csdn.net/speedme/article/details/24231197 1. 什么是动态规划 ------------------------------- ...
- Dynamic Programming: From novice to advanced
作者:Dumitru 出处:http://community.topcoder.com/tc?module=Static&d1=tutorials&d2=dynProg An impo ...
- HDU-4972 A simple dynamic programming problem
http://acm.hdu.edu.cn/showproblem.php?pid=4972 ++和+1还是有区别的,不可大意. A simple dynamic programming proble ...
- [算法]动态规划(Dynamic programming)
转载请注明原创:http://www.cnblogs.com/StartoverX/p/4603173.html Dynamic Programming的Programming指的不是程序而是一种表格 ...
- hdu 4972 A simple dynamic programming problem(高效)
pid=4972" target="_blank" style="">题目链接:hdu 4972 A simple dynamic progra ...
- Julia is a high-level, high-performance dynamic programming language for technical computing, with syntax that is familiar to users of other technical
http://julialang.org/ julia | source | downloads | docs | blog | community | teaching | publications ...
随机推荐
- 关于java for循环常见练习题
使用for循环方式计算2+4+6+…+100的值 package day02; /** * 使用for循环方式计算2+4+6+…+100的值 * @author mu * */ public clas ...
- 软件工程与UML作业3(互评作业)
博客班级 https://edu.cnblogs.com/campus/fzzcxy/2018SE1/ 作业要求 https://edu.cnblogs.com/campus/fzzcxy/2018S ...
- vue2.5开发去哪儿了流程
初始化项目 在 src/assets 中添加样式初始化文件 reset.css ; border.css 本地引入取消延迟300毫秒的控件 cnpm i fastclick -S 在mian.js中引 ...
- git线上操作
选择线上仓库 """ 1.注册码云账号并登录:https://gitee.com/ 2.创建仓库(课堂截图) 3.本地与服务器仓库建立连接 ""&qu ...
- golang slice学习
关于获取slice相关内存地址操作 s := make([]int, 1) t.Log(unsafe.Pointer(&s))// 获取当前slice 结构体实例的内存地址 t.Log(uns ...
- OSI和TCP/IP参考模型
分层思想: 分层模型是一种开发网络协议的设计方法. 把节点之间的通讯这个复杂的问题,分成了若干个简单的小问题逐一解决. 把网络相邻节点之间通过接口进行通信,下层为上层提供服务.当网络发生故障,很容易确 ...
- Git源代码管理笔记
很早之前也学过git但是没有详细的记录,这次是做个复习,巩固 若有不对的地方请您指出 目录 Git和SVN有什么区别? 什么是Git? github仓库 Star和Fork Pull request ...
- 使用redis来调用iptables,封禁恶意IP
话不多说,通常大多数站点都会有被薅羊毛的情况,防护无非也就是业务层做处理,短时内不再响应恶意请求啦.虽然不响应了,可还是会消耗资源的,比如我要从数据库(当然也可能是内存数据库)去查询下,你是不是恶意的 ...
- Windows10下JDK8的下载安装与环境变量的配置
Windows10下JDK8的下载安装与环境变量的配置 下载JDK8(64位) 链接:https://pan.baidu.com/s/10ZMK7NB68kPORZsPOhivog 提取码:agsa ...
- Spring Boot第五弹,WEB开发初了解~
持续原创输出,点击上方蓝字关注我吧 目录 前言 Spring Boot 版本 前提条件(必须注意) 添加依赖 第一个接口开发 如何自定义tomcat的端口? 如何自定义项目路径? JSON格式化 日期 ...