
使用RSEM进行转录组测序的差异表达分析
仍然是两年前的笔记
1. prepare-reference
如果用RSEM对比对后的bam进行转录本定量,则在比对过程中要确保比对用到的索引是由rsem-prepare-reference产生的。
~/software/rsem/rsem-prepare-reference \

--transcript-to-gene-map ~/project/RNA-seq/ref_cds/gene_transcript.txt \ #作用是在后面的定量结果文件中,添加gene名称, 转录本名称两列,该文件每一行都是gene_id\ttranscript_id的形式,eg: cluster_11236   cluster_11236.1

--bowtie2 \ #RSEM可调用bowtie, bowtie2, STAR三种比对工具;这里选用bowtie2

~/project/RNA-seq/ref_cds/HC_cds_and_8sample_clustercds.fa \

~/project/RNA-seq/ref_cds/cds.byrsem

可以看到,单纯用bowtie2建的索引和rsem调用bowtie2建的索引是不一样的。
2. calculate-expression
用法分为两类,分别是从fa/fq得到表达矩阵,和从sam/bam得到表达矩阵(仍然要求是比对到rsem-prepare-reference生成的索引)。以单端的fq数据为例。
rsem-calculate-expression [options] upstream_read_file(s) reference_name sample_name

rsem-calculate-expression [options] --paired-end upstream_read_file(s) downstream_read_file(s) reference_name sample_name

rsem-calculate-expression [options] --sam/--bam [--paired-end] input reference_name sample_name
cat ~/project/RNA-seq/dir.txt | while read id

do

~/software/rsem/rsem-calculate-expression -p 8 --bowtie2 \

~/project/data/RNA-seq/${id}.fastq.gz \

~/project/RNA-seq/ref_cds/cds.byrsem \

 --samtools-sort-mem 2G --fragment-length-mean 50 \ # 单端数据建议使用--fragment-length-mean和--fragment-length-sd

~/project/RNA-seq/map/${id}.rsem

done
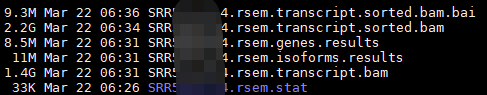
完成之后得到这些文件,其中,rsem.genes.results和rsem.isoforms.results分别表示gene水平和转录本水平的定量结果。每一列含义:
less rsem.genes.results|head -n 1

gene_id transcript_id(s)        length  effective_length        expected_count  TPM     FPKM

less rsem.isoforms.results|head -n 1

transcript_id   gene_id length  effective_length        expected_count  TPM     FPKM    IsoPct
后面用EBseq检验差异基因/转录本时,会使用到这两个文件。
3. Differential Expression Analysis using EBSeq
下面以gene水平差异分析为例。
3.1 generate-data-matrix
这一步提取上一步得到的每个样本定量结果文件中的expected_count列,组成数据矩阵。
~/software/rsem/rsem-generate-data-matrix \

SRR1.rsem.genes.results SRR2.rsem.genes.results \

SRR3.rsem.genes.results SRR4.rsem.genes.results \

SRR5.rsem.genes.results SRR6.rsem.genes.results \

SRR7.rsem.genes.results SRR8.rsem.genes.results \

> ~/project/RNA-seq/count/GeneMat.txt
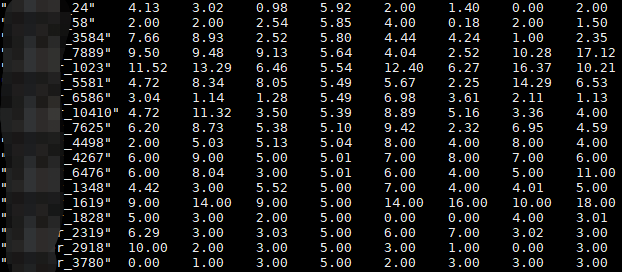
3.2 run-ebseq
调用EBseq进行检验
~/software/rsem/rsem-run-ebseq \

GeneMat.txt 2,2,2,2 GeneMat.results #2,2,2,2表示4个condition, 每个condition有两个重复;顺序要和3.1中输入文件表示的condition的顺序一致

#会得到三个文件

GeneMat.results.condmeans  GeneMat.results  GeneMat.results.pattern

#GeneMat.results.pattern

"C1"    "C2"    "C3"    "C4"

"Pattern1"      1       1       1       1

"Pattern2"      1       1       1       2

"Pattern3"      1       1       2       1

"Pattern4"      1       1       2       2

"Pattern5"      1       2       1       1

"Pattern6"      1       2       1       2

"Pattern7"      1       2       2       1

"Pattern8"      1       2       2       2

"Pattern9"      1       1       2       3

"Pattern10"     1       2       1       3

"Pattern11"     1       2       2       3

"Pattern12"     1       2       3       1

"Pattern13"     1       2       3       2

"Pattern14"     1       2       3       3

"Pattern15"     1       2       3       4

#以Pattern14为例,1 2 3 3表示某基因表达:C1与C2不同,C3与C4相同

#四种condition如果有基因表达存在差异,就这些情况了

#GeneMat.results

#第一列是各个基因名称,接着15列是该基因符合该种Parttern的概率

#"MAP"为该基因最可能的模式;"PPDE":posterior probability of being differentially expressed,越大越好

"Pattern1"      "Pattern2"      "Pattern3"      "Pattern4"      "Pattern5"      "Pattern6"      "Pattern7"      "Pattern8"      "Pattern9"      "Pattern10"     "Pattern11"  "Pattern12"     "Pattern13"     "Pattern14"     "Pattern15"     "MAP"   "PPDE"

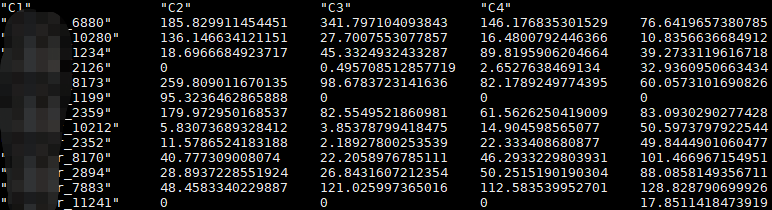
#GeneMat.results.condmeans

#为每个样本合并重复之后的定量结果,如下图,这个结果可以用来控制fold change
3.3 control_fdr
控制FDR(错误发现率)来挑选差异基因
~/software/rsem/rsem-control-fdr \

GeneMat.results 0.05 GeneMat.de.txt
将GeneMat.results文件中,PPDE大于0.95的记录提取出来
因水平有限,有错误的地方,欢迎批评指正!
使用RSEM进行转录组测序的差异表达分析的更多相关文章
- 转录组差异表达分析工具Ballgown
Ballgown是分析转录组差异表达的R包. 软件安装: 运行R, source(“http://bioconductor.org/biocLite.R”) biocLite(“ballgown”) ...
- 单细胞转录组测序数据的可变剪接(alternative splicing)分析方法总结
可变剪接(alternative splicing),在真核生物中是一种非常基本的生物学事件.即基因转录后,先产生初始RNA或称作RNA前体,然后再通过可变剪接方式,选择性的把不同的外显子进行重连,从 ...
- 差异表达分析之FDR
差异表达分析之FDR 随着测序成本的不断降低,转录组测序分析已逐渐成为一种很常用的分析手段.但对于转录组分析当中的一些概念,很多人还不是很清楚.今天,小编就来谈谈在转录组分析中,经常会遇到的一个概念F ...
- Differential expression analysis for paired RNA-seq data 成对RNA-seq数据的差异表达分析
Differential expression analysis for paired RNA-seq data 抽象背景:RNA-Seq技术通过产生序列读数并在不同生物条件下计数其频率来测量转录本丰 ...
- RNA-Seq differential expression analysis: An extended review and a software tool RNA-Seq差异表达分析: 扩展评论和软件工具
RNA-Seq differential expression analysis: An extended review and a software tool RNA-Seq差异表达分析: 扩展 ...
- 表达谱(DGE)测序与转录组测序的差别
DGE-seq和普通的transcriptomic profiling相比较有什么不同,有什么特点? DGE就是用酶将mRNA切断,只使用靠近poly A的一小段RNA去测序. #1 由于不是测定mR ...
- 单细胞转录组测序技术(scRNA-seq)及细胞分离技术分类汇总
单细胞测序流程(http://learn.gencore.bio.nyu.edu) 在过去的十多年里,高通量测序技术被广泛应用于生物和医学的各种领域,极大促进了相关的研究和应用.其中转录组测序(RNA ...
- 转录组测序(RNA-seq)技术
转录组是某个物种或者特定细胞类型产生的所有转录本的集合.转录组研究能够从整体水 平研究基因功能以及基因结构,揭示特定生物学过程以及疾病发生过程中的分子机理,已广泛应 用于基础研究.临床诊断和药 ...
- 转录组分析综述A survey of best practices for RNA-seq data analysis
转录组分析综述 转录组 文献解读 Trinity cufflinks 转录组研究综述文章解读 今天介绍下小编最近阅读的关于RNA-seq分析的文章,文章发在Genome Biology 上的A sur ...
随机推荐
- Java方式导出EXCEL表格
最近几天做公司项目,应客户需求需要将表单的数据下载本地存成.xls文件.之前做毕设的时候,就有类似这方面的功能需 求,但是当时也没有做就搁浅了下来,这次补上. 一.业务开发描述 二.前台jsp页面及j ...
- svn安装步骤
我使用的是myeclipse 8.5 svn是site-1.8.22.zip 步骤 1.在myeclipse安装路径下dropins文件夹中创建svn文件夹 2.解压site-1.8.22.zip复 ...
- Jenkins(3)拉取git仓库代码,执行python自动化脚本
前言 python自动化的脚本开发完成后需提交到git代码仓库,接下来就是用Jenkins拉取代码去构建自动化代码了 新建项目 打开Jenkins新建一个自由风格的项目 源码管理 Repository ...
- python实现经典排序算法
以下排序算法最终结果都默认为升序排列,实现简单,没有考虑特殊情况,实现仅表达了算法的基本思想. 冒泡排序 内层循环中相邻的元素被依次比较,内层循环第一次结束后会将最大的元素移到序列最右边,第二次结束后 ...
- 2014-2015 ACM-ICPC, NEERC, Southern Subregional Contest 题解(PART)(9/13)
$$2014-2015\ ACM-ICPC,\ NEERC,\ Southern\ Subregional\ Contest$$ A Nasta Rabbara B Colored Blankets ...
- 【洛谷 p3372】模板-线段树 1(数据结构--线段树)
题目:已知一个数列,你需要进行下面两种操作:1.将某区间每一个数加上x:2.求出某区间每一个数的和. 解法:如题,模版题.需要加上 lazy 标记,也就是我的 upd.lazy 标记的思路就是对一个结 ...
- Codeforces Round#630 div2 A~C题解
...
- Codeforces 1144F Graph Without Long Directed Paths DFS染色
题意: 输入一张有向图,无自回路和重边,判断能否将它变为有向图,使得图中任意一条路径长度都小于2. 如果可以,按照输入的边的顺序输出构造的每条边的方向,构造的边与输入的方向一致就输出1,否则输出0. ...
- JavaScript——DOMM
文本节点 != 文本内容
- PAT L2-004. 这是二叉搜索树吗?【前序遍历转化为后序遍历】
一棵二叉搜索树可被递归地定义为具有下列性质的二叉树:对于任一结点, 其左子树中所有结点的键值小于该结点的键值: 其右子树中所有结点的键值大于等于该结点的键值: 其左右子树都是二叉搜索树. 所谓二叉搜索 ...