
爬取知乎热榜标题和连接 (python,requests,xpath)
用python爬取知乎的热榜,获取标题和链接。
环境和方法:ubantu16.04、python3、requests、xpath
1.用浏览器打开知乎,并登录
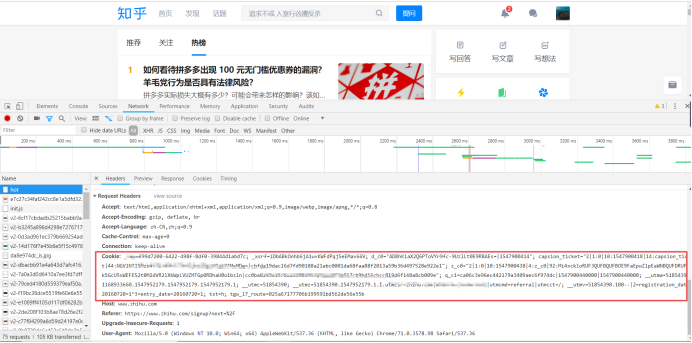
2.获取cookie和User—Agent
3.上代码
 import requests

 from lxml import etree

 def get_html(url):

     headers={

             'Cookie':'你的Cookie',

             #'Host':'www.zhihu.com',

             'User-Agent':'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36'

             }

     r=requests.get(url,headers=headers)

     if r.status_code==200:

         deal_content(r.text)

 def deal_content(r):

     html = etree.HTML(r)

     title_list = html.xpath('//*[@id="TopstoryContent"]/div/section/div[2]/a/h2')

     link_list = html.xpath('//*[@id="TopstoryContent"]/div/section/div[2]/a/@href')

     for i in range(0,len(title_list)):

         print(title_list[i].text)

         print(link_list[i])

         with open("zhihu.txt",'a') as f:

             f.write(title_list[i].text+'\n')

             f.write('\t链接为:'+link_list[i]+'\n')

             f.write('*'*50+'\n')

 def main():

     url='https://www.zhihu.com/hot'

     get_html(url)

 main()
4.爬取结果

爬取知乎热榜标题和连接 (python,requests,xpath)的更多相关文章
- python抓取知乎热榜
知乎热榜讨论话题,https://www.zhihu.com/hot,本文用python抓取下来分析 #!/usr/bin/python # -*- coding: UTF-8 -*- from ur ...
- python实战项目 — 使用bs4 爬取猫眼电影热榜(存入本地txt、以及存储数据库列表)
案例一: 重点: 1. 使用bs4 爬取 2. 数据写入本地 txt from bs4 import BeautifulSoup import requests url = "http:// ...
- 16、爬取知乎大v张佳玮的文章“标题”、“摘要”、“链接”,并存储到本地文件
爬取知乎大v张佳玮的文章“标题”.“摘要”.“链接”,并存储到本地文件 # 爬取知乎大v张佳玮的文章“标题”.“摘要”.“链接”,并存储到本地文件 # URL https://www.zhihu.co ...
- 使用python scrapy爬取知乎提问信息
前文介绍了python的scrapy爬虫框架和登录知乎的方法. 这里介绍如何爬取知乎的问题信息,并保存到mysql数据库中. 首先,看一下我要爬取哪些内容: 如下图所示,我要爬取一个问题的6个信息: ...
- scrapy 爬取知乎问题、答案 ,并异步写入数据库(mysql)
python版本 python2.7 爬取知乎流程: 一 .分析 在访问知乎首页的时候(https://www.zhihu.com),在没有登录的情况下,会进行重定向到(https://www. ...
- 40行代码爬取猫眼电影TOP100榜所有信息
主要内容: 一.基础爬虫框架的三大模块 二.完整代码解析及效果展示 1️⃣ 基础爬虫框架的三大模块 1.HTML下载器:利用requests模块下载HTML网页. 2.HTML解析器:利用re正则表 ...
- 通过scrapy,从模拟登录开始爬取知乎的问答数据
这篇文章将讲解如何爬取知乎上面的问答数据. 首先,我们需要知道,想要爬取知乎上面的数据,第一步肯定是登录,所以我们先介绍一下模拟登录: 先说一下我的思路: 1.首先我们需要控制登录的入口,重写star ...
- 一个简单的python爬虫,爬取知乎
一个简单的python爬虫,爬取知乎 主要实现 爬取一个收藏夹 里 所有问题答案下的 图片 文字信息暂未收录,可自行实现,比图片更简单 具体代码里有详细注释,请自行阅读 项目源码: # -*- cod ...
- python定时器爬取豆瓣音乐Top榜歌名
python定时器爬取豆瓣音乐Top榜歌名 作者:vpoet mail:vpoet_sir@163.com 注:这些小demo都是前段时间为了学python写的,现在贴出来纯粹是为了和大家分享一下 # ...
随机推荐
- 【转】网络管理员必知之:IP地址划分
1.IP地址分类 IP地址有四个段,包括网络标识和主机标识两部分:netid+hostid. IP地址应用分为A.B.C三类,D.E类是保留和专用的. ...
- 【转】】Vue项目部署tomcat,刷新报错404解决办法
转自[https://blog.csdn.net/g631521612/article/details/82835518] 解决方式: - 在tocmat的webapps下的项目中创建WEB-INF文 ...
- Python初学者第十三天 三级菜单程序小作业
13day 作业题目: 三级菜单 作业需求: 数据结构: menu = { '北京':{ '海淀':{ '五道口':{ 'soho':{}, '网易':{}, 'google':{} }, '中关村' ...
- 删除 maven仓库,更新失败的jar包命令
set REPOSITORY_PATH=D:\maven_cpbsrem صشعثرث÷...for /f "delims=" %%i in ('dir /b /s " ...
- Pip批量安装/卸载包
pip批量安装package 将需要安装的包保存在requirements.txt中 cd到aa.txt所在目录,运行: pip install -r requirements.txt pip批量卸载 ...
- 20、资源与本地化 System.Resources
可以将字符串.图像或对象数据等资源包含在资源文件中,方便应用程序使用. .NET Framework 提供了五种创建资源文件的方法: •创建一个包含字符串资源的文本文件.或创建一个包含字符串.图像或对 ...
- project euler 169
project euler 169 题目链接:https://projecteuler.net/problem=169 参考题解:http://tieba.baidu.com/p/2738022069 ...
- 阿里八八——预则立&&他山之石
团队计划--α版本Issues 概况 采访团队:"一起买"开发团队 采访形式:团队--团队 团队采访 内容提炼 项目选题 团队选题本身并没有大的亮点,但是可以从功能下手,多想想项目 ...
- 创建工程支持scala代码开发
第一步:idea当中创建创建普通maven工程 File ==> New ==> Project 第二步:修改pom.xml添加scala的版本以及打包插件 <dependencie ...
- 英语的各种 n. adj. vt. vi. 等词性解释
n. 名词 v. 动词(既可作及物动词,也可作不及物动词的就用这个表示) pron. 代词 adj. 形容词(后接名词) adv. 副词(修饰动词.形容词或其他副词) abbr. (这是一个缩写符号) ...