
(2.8)Mysql之SQL基础——索引的分类与使用
(2.8)Mysql之SQL基础——索引的分类与使用
关键字:mysql索引,mysql增加索引,mysql修改索引,mysql删除索引
按逻辑分类:
1、主键索引(聚集索引)(也是唯一索引,不允许有空值)
2、普通索引或单列索引(包含前缀索引,即只把该列值的前N个字符变成索引)
3、多列索引(复合索引)
4、唯一索引或非唯一索引(非唯一索引其实就是普通/多列索引)
5、空间索引
6、创建索引的基本形式
7、索引的操作
0.建表时创建索引
1.查看索引
2.创建单列索引(包含前缀索引)
3.复合索引
4.唯一索引(允许多个空值,每列唯一)
5.主键索引(不允许空值,唯一)
6.索引的删除
7.删除自增auto_increment
8.全文索引
9.show index释义
6.创建索引的基本形式
create [unique|fulltext|spatial] index index_name

[index_type]

  on table_name(index_col_name,...)

[index_option]

[alogorithm_option | lock_option]...

index_colname:

  col_name[(length)][asc | desc]

1.[unique|fulltext|spatial]  可选参数,分别是唯一索引、全文索引、空间索引
2.index 创建索引的关键字,或者也可以用(key)
3.index_col_name 表中要创建索引的列对象
4.index_name 创建的索引名字
5.length 可选参数,索引的长度,只能用于字符串
6.[asc | desc] 索引值得存储方式

最简单最常用的方式:
  create index 索引名 on 表名(列名);
  create index ix_test101_id on test101(id);
  create index ix_test101_name on test101(name(10)); #截取该字段前10个字符作为索引
  alter table test101 add index 索引名(列名);
7、索引的操作
0.建表时创建索引


create table test102(
id int primary key auto_increment,
name varchar(12),
description varchar(200),
index ix_test102_description(description)
);

1.查看索引

  show index from table_name;  # 后面接参数 optimize table table_name; 分析表

2.单列索引

  create index 索引名 on 表名(列名);

  create index ix_test101_id on test101(id);

  create index ix_test101_name on test101(name(10)); #前缀索引,截取该字段前10个字符作为索引

  alter table test101 add index 索引名(列名);

3.复合索引

  create index 索引名 on 表名(列名1,列名2);

  alter table test101 add index 索引名(列名1,列名2);

4.唯一索引(允许多个空值,每列唯一)
  create unique index 索引名 on 表名(列名);
  alter table test101 add unique index 索引名(列名);
5.主键索引(不允许空值,唯一)
  alter table test101 add primary key (列名)


6.索引的删除

  1).单列/多列/唯一索引删除:drop index 索引名 on 表名;  or   alter table test101 drop 索引名
  2).主键索引删除: alter table test101 drop primary key;(如果有自增字段,需要先删除自增)

7.删除自增auto_increment
  alter table test101 change id int;

8.全文索引(详细参考:https://www.cnblogs.com/tommy-huang/p/4483684.html)
  1)全文索引的重要参数
    show variables like '%word%';
    参数 : ft_min_word_len | 4   默认为4:意思是最小分词大小为4个字节(如果太短可能没有什么效果,也没有什么意义)
    show variables like 'ngram%';自然语言分词工具
    参数: ngram_token_size | 2  默认为2:意思是分词分2个字,可以设置为1-10个;

  2)创建全文索引
    alter table 表名 add fulltext index 索引名(列名1...) with parser ngram;

  3)显示指定全文检索的表源来自哪里
    show variables like '%ft_aux%';
     set global innodb_ft_aux_table='db/tabe';

  4)查询系统表,查看分词表
    select * from information_schema.INNODB_FI_INDEX_TABLE;
使用全文索引的格式: MATCH (columnName) AGAINST ('string')
eg:
SELECT * FROM `student` WHERE MATCH(`name`) AGAINST('聪')
当查询多列数据时:
建议在此多列数据上创建一个联合的全文索引,否则使用不了索引的。
SELECT * FROM `student` WHERE MATCH(`name`,`address`) AGAINST('聪 广东')
案例代码
  create table test103(title varchar(20),content varchar(200));
  insert into test103 value('学习mysql的方法','学习mysql真好玩');
  insert into test103 value('学习mysql的全文索引','mysql的全文索引功能好强大啊!');
  insert into test103 value('mysql与oracle的区别','mysql与oracle的区别太大了。')
  alter table test103 add fulltext index fullix_test103_titleContent(title,content) with parser ngram;
  show index from test103\G   #查看建立的索引是不是我与我们插入的行数一样,都是3行
  set global innodb_ft_aux_table='test/test103';  #显示指定全文检索的数据源来自test库test103表
  show tables from information_schema;  #显示schema信息所有表
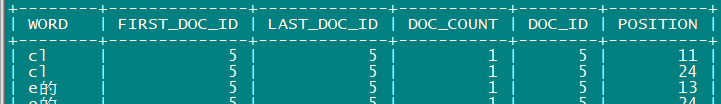
  select * from information_schema.INNODB_FT_INDEX_TABLE;  #查看分词信息表
  #如图,Word全是2个词,因为ngram_token_size 参数值是2,代表每个分词词组是2个字符;
全文索引的使用:
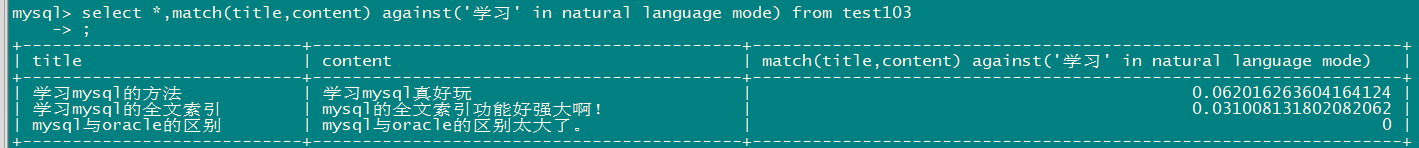
1)自然语言模式下的检查
#自然语言模式中,能匹配到 '学习' 2个字的行有几行,结果如下,是2行,查看一下我们上面的插入数据,的确只有2行
mysql> select count(*) from test103 where match(title,content) against('学习' in natural language mode);

mysql> select *,match(title,content) against('学习' in natural language mode) from test103;
#查看是那些行匹配到学习2个字,匹配度是多少
2)布尔模式下的检查(相对复杂)
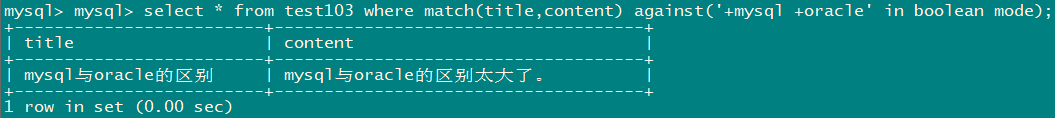
  #匹配出现有 'mysql' 和 'oracle' 的数据记录
   mysql> select * from test103 where match(title,content) against('+mysql +oracle' in boolean mode);
#匹配有mysql但是没有Oracle的数据记录
mysql> select * from test103 where match(title,content) against('+mysql -oracle' in boolean mode);

3)扩展模式
(很少用)#根据词语的相关度来匹配,提高mysql的相关度, -- 如果有相关的比如 'db' 词汇,那么会出来,如果是 < 降低mysql的相关度, 'db'词汇所在数据可能就不会出来了
mysql> select * from test103 where match(title,content) against('>mysql -oracle' in boolean mode); #<为降低mysql的关联度 >为提高Mysql的关联度

#扩展查询:比如我以 'oracle' 为匹配词查询,那么相关的mysql/oracle/db/数据库等词都会被扩展查询出来
mysql> select * from test103 where match(title,content) against('oracle' with query expansion);

8.全文索引(详情参考:倒排索引)
概念:其实就是倒排索引,把文档分词,然后以词为索引搜索,每个词索引上都包含对应的 <词,文档编号,tf(即出现次数)> ,
倒排索引长成什么样子呢?就是图中标记的那样,每个词后面有一个拉链,拉链中存放包含该词的文档编号,利用这个数据结构能快速的找到包含某一个词的所有文档。

词频 (term frequency, TF) 指的是某一个给定的词语在该文件中出现的次数。这个数字通常会被归一化(一般是词频除以文章总词数), 以防止它偏向长的文件。(同一个词语在长文件里可能会比短文件有更高的词频,而不管该词语重要与否。)
但是, 需要注意, 一些通用的词语对于主题并没有太大的作用, 反倒是一些出现频率较少的词才能够表达文章的主题, 所以单纯使用是TF不合适的。权重的设计必须满足:一个词预测主题的能力越强,权重越大,反之,权重越小。所有统计的文章中,一些词只是在其中很少几篇文章中出现,那么这样的词对文章的主题的作用很大,这些词的权重应该设计的较大。IDF就是在完成这样的工作.
公式:

9.show index释义
mysql> show index from tblname;
mysql> show keys from tblname;
· Table
表的名称。
· Non_unique
如果索引不能包括重复词,则为0。如果可以,则为1。
· Key_name
索引的名称。
· Seq_in_index
索引中的列序列号,从1开始。
· Column_name
列名称。
· Collation
列以什么方式存储在索引中。在MySQL中,有值‘A’(升序)或NULL(无分类)。
· Cardinality
索引中唯一值的数目的估计值。通过运行ANALYZE TABLE或myisamchk -a可以更新。基数根据被存储为整数的统计数据来计数,所以即使对于小型表,该值也没有必要是精确的。基数越大,当进行联合时,MySQL使用该索引的机会就越大。
· Sub_part
如果列只是被部分地编入索引,则为被编入索引的字符的数目。如果整列被编入索引,则为NULL。
· Packed
指示关键字如何被压缩。如果没有被压缩,则为NULL。
· Null
如果列含有NULL,则含有YES。如果没有,则该列含有NO。
· Index_type
用过的索引方法(BTREE, FULLTEXT, HASH, RTREE)。
· Comment
(2.8)Mysql之SQL基础——索引的分类与使用的更多相关文章
- (2.9)Mysql之SQL基础——索引的查看与删除
(2.9)Mysql之SQL基础——索引的查看与删除 关键词:mysql索引查看,mysql索引删除 1.索引查询(以下包括主键,唯一,普通,复合,全文,但不包括外键) (1)按库查询 select ...
- (2.15)Mysql之SQL基础——开发设计最佳规范
(2.15)Mysql之SQL基础——开发设计最佳规范 关键字:mysql三大范式,mysql sql开发规范 分析: show profile.mysqllsla.mysqldrmpslow.exp ...
- (2.10)Mysql之SQL基础——约束及主键重复处理
(2.10)Mysql之SQL基础——约束及主键重复处理 关键词:mysql约束,批量插入数据主键冲突 [1]查看索引: show index from table_name; [2]查看有约束的列: ...
- (2.7)Mysql之SQL基础——表的操作与查看
(2.7)Mysql之SQL基础——表的操作与查看 搜索关键字:mysql表操作,comment注释操作,mysql临时表 0.临时表 create temporary table 1.创建表(在in ...
- (2.16)Mysql之SQL基础——函数
(2.16)Mysql之SQL基础——函数 关键词:mysql函数,mysql自定义函数,mysql聚合函数,mysql字符串函数,mysql数值函数 1.自定义函数 -- (1)一般形式 creat ...
- (2.14)Mysql之SQL基础——游标
(2.14)Mysql之SQL基础——游标 关键词:Mysql游标 -- (1)定义游标 declare cur_name cursor for select * from table_name wh ...
- (2.13)Mysql之SQL基础——触发器
(2.13)Mysql之SQL基础——触发器 关键词:Mysql触发器 1.一般形式 -- 0.查看触发器[1]SHOW TRIGGERS;[2]SELECT * FROM `information_ ...
- (2.11)Mysql之SQL基础——存储过程与变量
(2.11)Mysql之SQL基础——存储过程 关键字:mysql存储过程 查看存储过程: []SELECT * FROM information_schema.ROUTINES WHERE ROUT ...
- (2.6)Mysql之SQL基础——存储引擎的查看与修改
(2.6)Mysql之SQL基础——存储引擎的查看与修改 可以使用 show engines; 查看数据库支持的所有的存储引擎: 目录: 1.数据库级别存储引擎 1.1查看现在默认的存储引擎 1.2 ...
随机推荐
- keepalived双BACKUP加nopreempt失效、手动监控服务脚步。
keepalived双BACKUP加nopreempt不起作用,两个机器同时拥有vip, 排查几天发现是防火墙问题,啃爹. 打开 vi /etc/sysconfig/iptables 插入一条:-A ...
- asp.net基于windows服务实现定时发送邮件的方法
本文实例讲述了asp.net基于windows服务实现定时发送邮件的方法.分享给大家供大家参考,具体如下: //定义组件 private System.Timers.Timer time; publi ...
- Supervisor安装与配置(非守护进程管理工具)
http://blog.csdn.net/xyang81/article/details/51555473
- Java精选笔记_面向对象(多态、异常)
多态 概述 可以理解为事物存在的多种体现形态.同样的引用调用同样的方法却做了不同的事情 多态的本质是:一个程序中同名的不同方法. 多态的体现 父类的引用指向子类的对象,父类的引用接收子类的对象. 多态 ...
- 高级类特性----接口(intertface)
接 口 有时必须从几个类中派生出一个子类,继承它们所有的属性和方法.但是,Java不支持多重继承.有了接口,就可以得到多重继承的效果. 接口(interface)是抽象方法和常量值的定义的集合. 从本 ...
- ALM在win7/IE8下无法浏览
操作系统WIN7 64位. 安装完ALM后,用IE8打开查看,没有登录界面,提示需要安装东西. 按照提示安装,没有响应,然后到网上查了一下资料: ALM/QC11.0在win8/IE11下无法浏览 页 ...
- 《转》python学习(8)元组
转自 http://www.cnblogs.com/BeginMan/p/3156235.html 一.元组特性 1.类似列表,但不可变类型,正因如此,它可以做一个字典的key2.当处理一组对象时,这 ...
- LeetCode——Implement Stack using Queues
Description: Implement the following operations of a stack using queues. push(x) -- Push element x o ...
- Linux 2.6.16 TCP连接速度异常的问题分析
版权声明:本文由余子军原创文章,转载请注明出处: 文章原文链接:https://www.qcloud.com/community/article/104 来源:腾云阁 https://www.qclo ...
- 【黑金ZYNQ7000系列原创视频教程】07.自定义IP——定制RTC IP实验
黑金论坛地址: http://www.heijin.org/forum.php?mod=viewthread&tid=36641&extra=page%3D1 爱奇艺地址: http: ...