
python调用mediainfo工具批量提取视频信息
写了2个脚本,分别是v1版本和v2版本
都是python调用mediainfo工具提取视频元数据信息
v1版本是使用pycharm中测试运行的,指定了视频路径
v2版本是最终交付给运营运行的,会把v2版本打成exe运行
先看v1版本
import os,subprocess,json,re,locale,sys

import xlwt,time,shutil

#获取当前文件所在绝对目录路径

# this_path=os.path.abspath('.')

# print('当前路径为----',this_path)

# dir_path=this_path

#视频文件所在目录

dir_path='I:\\3分钟便当'

# print(os.listdir(this_path))

print('---------------------------------')

print('--------------程序马上开始----------------')

# dir_path=this_path

#定义个列表存放每个文件绝对路径,便于后期操作

init_list=[]

# dir_path='F:\\玩具屋总视频'

#创建个方法,统计每个文件路径,并追加列表中。这里注释掉了递归,不获取子目录了,只获取dir_path下面的视频

def get_all_file(dir_path,init_list):

    for file in os.listdir(dir_path):

        # print(file)

        filepath=os.path.join(dir_path,file)

        # print(filepath)

        if os.path.isdir(filepath):

            print('遇到子目录---%s---此版本暂不提取子目录视频信息--'%(filepath))

            time.sleep(2)

            # get_all_file(filepath)

        else:

            if not file.endswith('exe'):

                init_list.append(filepath)

    return init_list

#执行上面方法,把每个文件绝对路径追加到列表中

file_list=get_all_file(dir_path,init_list)

print("文件读取完毕-----3秒后开始获取视频详细信息------------")

time.sleep(3)

#定义个方法,获取单个media文件的元数据,返回为字典数据

#此程序核心是调用了mediainfo工具来提取视频信息的

def get_media_info(file):

    pname='D:\mediainfo_i386\MediaInfo.exe "%s" --Output=JSON'%(file)

    result=subprocess.Popen(pname,shell=False,stdout=subprocess.PIPE).stdout

    list_std=result.readlines()

    str_tmp=''

    for item in list_std:

        str_tmp+=bytes.decode(item.strip())

    json_data=json.loads(str_tmp)

    return json_data

#定义个方法传递字典数据,返回自己想要的字段数据,返回值列表

def get_dict_data(json_data):

    #获取文件大小

    filesize=json_data['media']['track'][0]['FileSize']

    #获取码率

    malv=json_data['media']['track'][0]['OverallBitRate'][0:4]

    #获取播放时长

    duration=json_data['media']['track'][0]['Duration'].split('.')[0]

    #获取文件类型

    file_format=json_data['media']['track'][0]['Format']

    #获取帧宽

    samp_width=json_data['media']['track'][1]['Sampled_Width']

    #获取帧高

    samp_height=json_data['media']['track'][1]['Sampled_Height']

    return [filesize,malv,duration,file_format,samp_width,samp_height]

#定义个方法,获取文件名,它是key,它的value就是目标列表,返回值是个字典,参数是文件列表

dict_all={}

#定义个日志存提取失败视频文件名

f_fail=open('提取失败日志.log','a',encoding='utf-8') # 追加模式

def get_all_dict(file_list,f_fail):

    for file in file_list:

        filename=os.path.split(file)[1]

        print(filename)

        time.sleep(0.1)

        try:

            info_list=get_dict_data(get_media_info(file))

            dict_all[filename]=info_list

        except Exception as e:

            print(filename,'------提取此文件信息失败---------')

            f_fail.write(filename+'\r\n')

    f_fail.close()

get_all_dict(file_list,f_fail)

# for item in dict_all:

#     print(item,dict_all[item])

#创建一个excel表存放文件路径信息,第一列是目录,第二列是文件名

wb = xlwt.Workbook()

sh = wb.add_sheet('元数据')

#写第一行

row_count=0

sh.write(row_count,0,"文件名")

sh.write(row_count,1,"文件大小")

sh.write(row_count,2,"码率")

sh.write(row_count,3,"总时长")

sh.write(row_count,4,"视频格式")

sh.write(row_count,5,"帧宽")

sh.write(row_count,6,"帧高")

#批量写入视频信息

row_count=1

for item in dict_all:

    sh.write(row_count,0,item)

    sh.write(row_count,1,dict_all[item][0])

    sh.write(row_count,2,dict_all[item][1])

    sh.write(row_count,3,dict_all[item][2])

    sh.write(row_count,4,dict_all[item][3])

    sh.write(row_count,5,dict_all[item][4])

    sh.write(row_count,6,dict_all[item][5])

    row_count+=1

#

wb.save("元数据统计.xls")

#
在看v2版本
v2版本是对当前目录下的视频进行提取
import os,subprocess,json,re,locale,sys

import xlwt,time,shutil

#获取当前文件所在绝对目录路径

this_path=os.path.abspath('.')

print('当前路径为----',this_path)

dir_path=this_path

# print(os.listdir(this_path))

print('---------------------------------')

print('--------------程序马上开始----------------')

# dir_path=this_path

#定义个列表存放每个文件路径,便于后期操作

init_list=[]

# dir_path='I:\\3分钟便当'

# dir_path='F:\\玩具屋总视频'

#创建个方法,统计每个文件路径,并追加列表中。用到了递归,这里不获取子目录了

def get_all_file(dir_path,init_list):

    for file in os.listdir(dir_path):

        # print(file)

        filepath=os.path.join(dir_path,file)

        # print(filepath)

        if os.path.isdir(filepath):

            print('遇到子目录---%s---此版本暂不提取子目录视频信息--'%(filepath))

            time.sleep(2)

            # get_all_file(filepath)

        else:

            if not file.endswith('exe'):

                init_list.append(filepath)

    return init_list

#执行上面方法,把每个文件绝对路径追加到列表中

file_list=get_all_file(dir_path,init_list)

print("文件读取完毕-----3秒后开始获取视频详细信息------------")

time.sleep(3)

#定义个方法,获取单个media文件的元数据,返回为字典数据

def get_media_info(file):

    pname='D:\mediainfo_i386\MediaInfo.exe "%s" --Output=JSON'%(file)

    result=subprocess.Popen(pname,shell=False,stdout=subprocess.PIPE).stdout

    list_std=result.readlines()

    str_tmp=''

    for item in list_std:

        str_tmp+=bytes.decode(item.strip())

    json_data=json.loads(str_tmp)

    return json_data

#定义个方法传递字典数据,返回自己想要的字段数据,返回值列表

def get_dict_data(json_data):

    #获取文件大小

    filesize=json_data['media']['track'][0]['FileSize']

    #获取码率

    malv=json_data['media']['track'][0]['OverallBitRate'][0:4]

    #获取播放时长

    duration=json_data['media']['track'][0]['Duration'].split('.')[0]

    #获取文件类型

    file_format=json_data['media']['track'][0]['Format']

    #获取帧宽

    samp_width=json_data['media']['track'][1]['Sampled_Width']

    #获取帧高

    samp_height=json_data['media']['track'][1]['Sampled_Height']

    return [filesize,malv,duration,file_format,samp_width,samp_height]

#定义个方法,获取文件名,它是key,它的value就是目标列表,返回值是个字典,参数是文件列表

dict_all={}

f_fail=open('提取失败日志.log','a',encoding='utf-8') # 追加模式

def get_all_dict(file_list,f_fail):

    for file in file_list:

        filename=os.path.split(file)[1]

        print(filename)

        time.sleep(0.1)

        try:

            info_list=get_dict_data(get_media_info(file))

            dict_all[filename]=info_list

        except Exception as e:

            print(filename,'------提取此文件信息失败---------')

            f_fail.write(filename+'\r\n')

    f_fail.close()

get_all_dict(file_list,f_fail)

# for item in dict_all:

#     print(item,dict_all[item])

#创建一个excel表存放文件路径信息,第一列是目录,第二列是文件名

wb = xlwt.Workbook()

sh = wb.add_sheet('元数据')

#写第一行

row_count=0

sh.write(row_count,0,"文件名")

sh.write(row_count,1,"文件大小")

sh.write(row_count,2,"码率")

sh.write(row_count,3,"总时长")

sh.write(row_count,4,"视频格式")

sh.write(row_count,5,"帧宽")

sh.write(row_count,6,"帧高")

row_count=1

for item in dict_all:

    sh.write(row_count,0,item)

    sh.write(row_count,1,dict_all[item][0])

    sh.write(row_count,2,dict_all[item][1])

    sh.write(row_count,3,dict_all[item][2])

    sh.write(row_count,4,dict_all[item][3])

    sh.write(row_count,5,dict_all[item][4])

    sh.write(row_count,6,dict_all[item][5])

    row_count+=1

#

wb.save("元数据统计.xls")
把v2版本打成exe文件
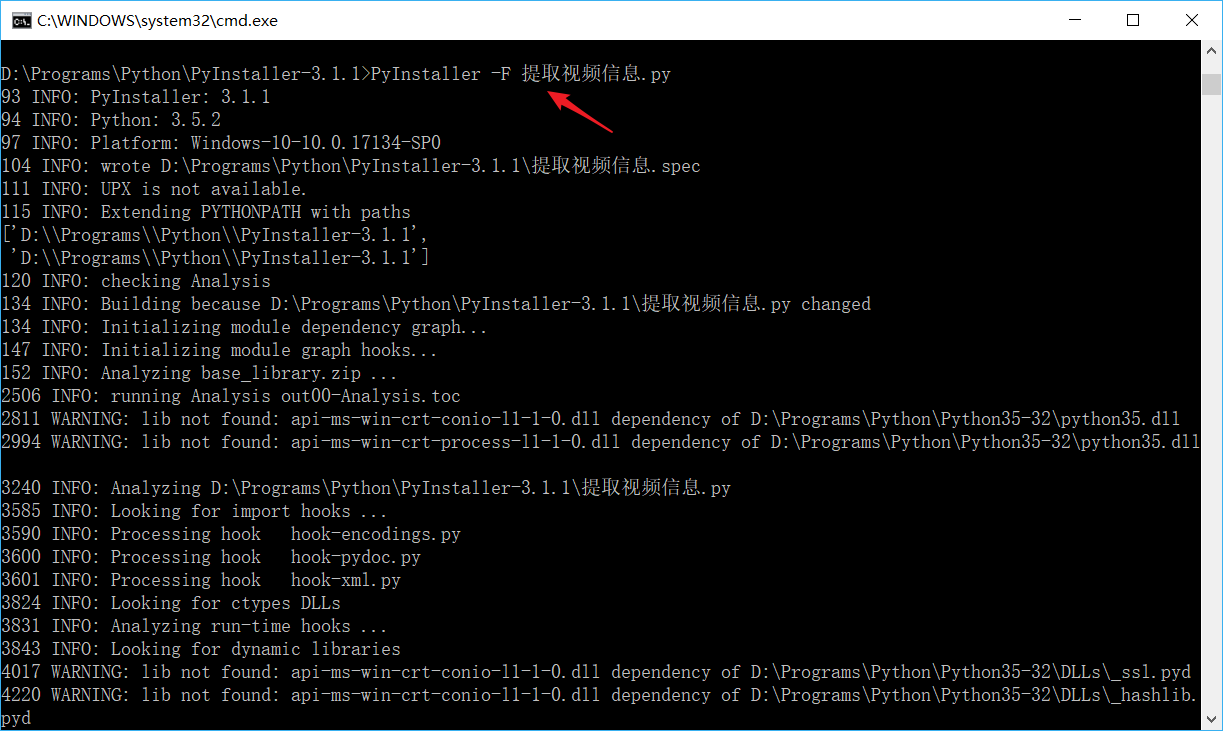
如下路径下拷贝此exe文件

这个程序交付给运营同事即可
测试和验证部分
使用方式,把程序放在视频同级目录下
按照代码缩写,如果视频运行成功:
1、此程序不会对haha目录进行处理
2、对于无法识别的文件比如abc.123(可能不是视频文件,或者已经损坏的视频文件),此程序会记录日志,同时程序正常运行不会中断
3、程序运行之后会有一个失败日志.log文件,记录了提取信息失败的视频名,同时把提取成功的视频文件放在“元数据统计.xls”中
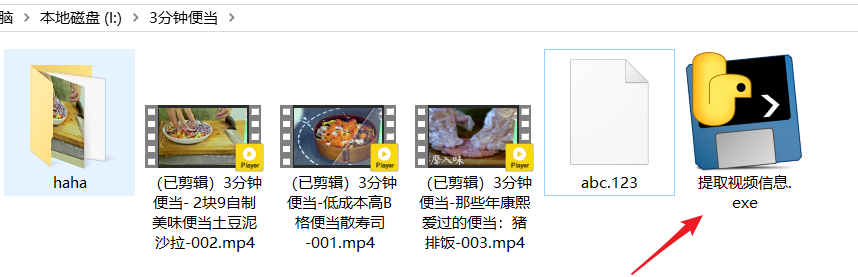
测试验证下
双击运行
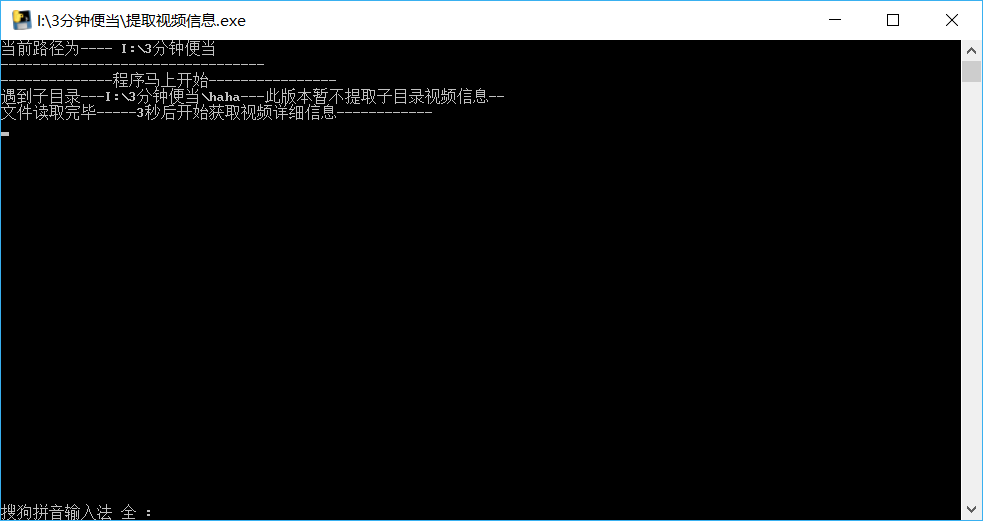
运行结束
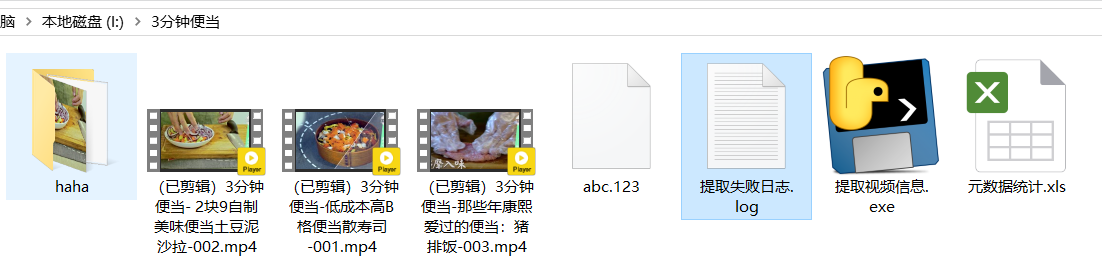

excel表信息
文件大小是字节,如果想显示为MB或者GB,使用excel表内置的公式即可处理
有很多字段,码率,时长等。这里因为运营只需要如下字段,就提取了这些
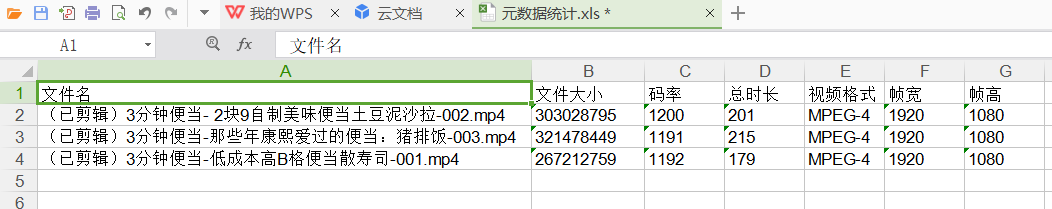
如果把此exe程序交付给运营同事使用,需要把D盘那个mediainfo_i386文件夹一起交给他们,此文件加必须放在D盘
python调用mediainfo工具批量提取视频信息的更多相关文章
- python调用HEG工具批量处理MODIS数据
下面的代码主要用于使用python语言调用NASA官方的MODIS处理工具HEG进行投影坐标转换与重采样批量处理 主要参考 HEG的用户手册:https://newsroom.gsfc.nasa.go ...
- Python调用ffpmeg和ffprobe处理视频文件
需求: 运营有若干批次的视频.有上千个,视频文件,有mp4格式的,有ts格式的 现在有需要去掉视频文件片头和片尾的批量操作需求. 比如 文件夹A下面的视频去掉片尾10秒 文件夹B下面的视频去掉片头6秒 ...
- 使用mediainfo工具统计每个视频文件(媒体文件)播放时长
需求 1.运营那边需要统计大量视频文件的播放时长,并汇总记录到excel表中,问我有什么方法搞定 这边搜索了很多统计媒体文件时长的,主要有以下几种 1.使用java获取 2.使用python获取 3. ...
- 『Python』Python 调用 ZoomEye API 批量获取目标网站IP
#### 20160712 更新 原API的访问方式是以 HTTP 的方式访问的,根据官网最新文档,现在已经修改成 HTTPS 方式,测试可以正常使用API了. 0x 00 前言 ZoomEye 的 ...
- python调用aapt工具直接获取包名和tagertSdkversion
背景: 每次海外游戏上架都需要符合google的上架规则,其中适配方面tagetSdkversion有硬性要求,比如需要适配安卓q就需要tagetSdkversion达到28,水平太渣的我每次调用aa ...
- python 调用zabbix api实现查询主机信息,输出所有主机ip
之前发现搜索出来的主机调用zabbix api信息都不是那么明确,后来通过zabbix官方文档,查到想要的api信息,随后写一篇自己这次项目中用到的api. #!/usr/bin/env python ...
- 制作大漠字库并用python调用大漠工具方法来识别文字
1.制作字库 1.截取需要的图片 2.这里截取了"火狐主页"四个字,接下来抓取文字的颜色 3.颜色由是由三个部分组成,即R G B其中的R是由00-FF(16进制) 即0-255个 ...
- bat文件调用cmd命令批量提取文件夹中的文件名(批量修改文件扩展名)
前言: 在平时的工作中,经常需要批量统计文件和数据,如果逐个统计的话太耗时,而且容易出错那么有没有什么快速的方法呢,这里给大家介绍一种简单高效的方法. 方法: 1.打开CMD命令: 按下 Ctrl+R ...
- Python调用zabbix API批量添加主机 (读取Excel)
本文转载自:http://blog.mreald.com/178 Zabbix可以通过自发现添加主机,不过有时候不准确,通过API添加会更加准确! 脚本使用的跟zabbix相关的内容.参考的是zabb ...
随机推荐
- Web版记账本开发记录(七)
经过不懈的努力,虽然开发出来的还有瑕疵,但今后我会继续努力的.
- Sign Up Account In CloudAMQP
CloudAMQP 有多种账号级别,请参考下面的链接的内容访问你可以注册的级别:https://www.cloudamqp.com/plans.html 作为测试来说,你可以注册免费的的消息. 你可以 ...
- php搜索附近人及显示男生女生分开
// 滚动切换标签样式 switchTab: function (e) { this.setData({ currentTab: e.detail.current }); this.checkCor( ...
- Police Stations CodeForces - 796D (bfs)
大意: 给定树, 有k个黑点, 初始满足条件:所有点到最近黑点距离不超过d, 求最多删除多少条边后, 使得原图仍满足条件. 所有黑点开始bfs, 贪心删边. #include <iostream ...
- 『TensorFlow』TFR数据预处理探究以及框架搭建
一.TFRecord文件书写效率对比(单线程和多线程对比) 1.准备工作 # Author : Hellcat # Time : 18-1-15 ''' import os os.environ[&q ...
- Java-Mail邮件开发
Email的历史比Web还要久远,直到现在,Email也是互联网上应用非常广泛的服务. 几乎所有的编程语言都支持发送和接收电子邮件,但是,先等等,在我们开始编写代码之前,有必要搞清楚电子邮件是如何在互 ...
- 使用js实现思维导图
使用js实现思维导图 demo:http://rockyren.github.io/mindmaptree/ 源码:http://github.com/RockyRen/mindmaptree/tre ...
- Sql server数据库连接Oracle库的步骤
本地使用环境 操作系统: win10 64 ,SQL Server 2012 ,Oracle Server 11g 第一步:安装好oracle客户端,并配置好TNS信息 ORCL = (DESCR ...
- day12_python_1124
00 如何学习python 如何学好英语? 母系英语. 听 说 读 写 练 input output 听 说 读 写(练) 听,读 说 纠正 01 昨日内容回顾 生成器:本质就是迭代器,自己用pyth ...
- Django的下载与项目的创建
一.Django的下载安装 Django官网下载页面 二.DOS窗口下的django项目从创建和启动 1. DOS窗口下载Django pip3 install django==1.11.9 2.DO ...