
kNN处理iris数据集-使用交叉验证方法确定最优 k 值
基本流程:
1、计算测试实例到所有训练集实例的距离;
2、对所有的距离进行排序,找到k个最近的邻居;
3、对k个近邻对应的结果进行合并,再排序,返回出现次数最多的那个结果。
交叉验证:
对每一个k,使用验证集计算,记录k对应的错误次数,取错误数最小的k
# -*- coding: utf-8 -*-

import os

import pandas as pd

import matplotlib.pyplot as plt

import math

import operator

#按照8:2的比例分割数据

#testSetIndex : 第几组为测试样本,取值范围0 - 4

def splitData(trainSet, testSet, testSetIndex):

    #data = pd.read_csv('iris.txt', skiprows=0, skipfooter=0, sep=r'\s+', encoding="utf-8", engine='python', header=None)

    data = pd.read_csv('iris.txt', encoding="utf-8", engine='python', header=None)

    for i in range(150):

        if testSetIndex == (i % 50) / 10:

            testSet.append(data.iloc[i])

        else:

            trainSet.append(data.iloc[i])

    return

#计算欧氏距离

#instance1 : 实例1

#instance2 : 实例2

#dimension :维度

def computeDistance(instance1, instance2, dimension):

    distance = 0

    for i in xrange(dimension):

        #print(instance1[i], instance2[i])

        distance += pow((instance1[i] - instance2[i]), 2)

    return math.sqrt(distance)

#trainSet : 训练样本集

#instance : 实例数据

#k : 1 - 120

def kNN(trainSet, instance, k):

    distances = []

    dimension = len(instance) - 1

    #计算测试实例到训练集实例的距离

    for i in xrange(len(trainSet)):

        dist = computeDistance(instance, trainSet[i], dimension)

        distances.append((trainSet[i], dist))

    #对所有的距离进行排序

    distances.sort(key=operator.itemgetter(1))

    neighbors = []

    #返回k个最近邻

    for i in range(k):

        neighbors.append(distances[i][0])

    #对k个近邻进行合并,返回最多的那个

    listClass = {}

    for i in xrange(len(neighbors)):

        response = neighbors[i][4]

        if response in listClass:

            listClass[response] += 1

        else:

            listClass[response] = 1

    #排序

    sortResult = sorted(listClass.iteritems(), key = operator.itemgetter(1), reverse=True)

    return sortResult[0][0]

def main():

    trainSet = []     #训练数据集

    testSet = []      #测试数据集

    #1. 数据分割8:2

    splitData(trainSet, testSet, 4)

    #2. 使用交叉验证方法确定最优 k 值,并给出在该情形下分类器的错误分类率

    errCountSet = [0] * 120

    #9总数据切割方式,对每一个k,记录k对应的总错误次数

    for j in xrange(0, 5):

        trainSet = []

        testSet = []

        splitData(trainSet, testSet, j)

        for k in xrange(0, 120):

            #对每一个k,使用验证集计算,记录k对应的错误次数

            for i in xrange(len(testSet)):

                trainResult = kNN(trainSet, testSet[i], k + 1)

                if trainResult != testSet[i][4]:

                    errCountSet[k] = errCountSet[k] + 1

    #取错误数最小的k 有多个

    min = 1

    for i in xrange(0, 120):

        errCountSet[i] = errCountSet[i] / (30 * 5.0)

        if min > errCountSet[i]:

            min = errCountSet[i]

            #k = i + 1

    #打印错误率最小的k值

    for i in xrange(0, 120):

        if min == errCountSet[i]:

            print i + 1, min

    fig = plt.figure(figsize=(20, 15))

    ax1 = fig.add_subplot(111)

    #ax2 = fig.add_subplot(122)

    ax1.plot(range(1, 121), errCountSet)

    ax1.set_xlabel('k')

    ax1.set_ylabel('Error Rate')

    plt.show()

    return

if __name__ == "__main__":

    main()
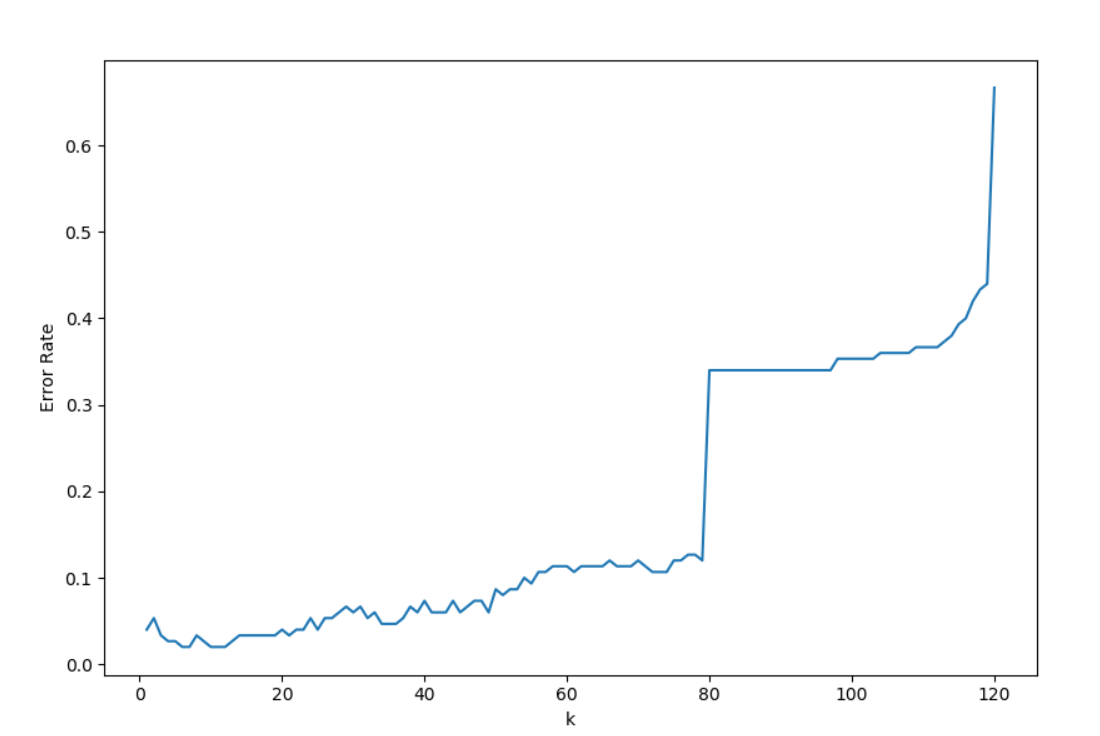
分别使用参数k=1~120进行实验,并进行交叉验证,错误分类率曲线如下:
kNN处理iris数据集-使用交叉验证方法确定最优 k 值的更多相关文章
- 使用KNN对iris数据集进行分类——python
filename='g:\data\iris.csv' lines=fr.readlines()Mat=zeros((len(lines),4))irisLabels=[]index=0for lin ...
- 十折交叉验证10-fold cross validation, 数据集划分 训练集 验证集 测试集
机器学习 数据挖掘 数据集划分 训练集 验证集 测试集 Q:如何将数据集划分为测试数据集和训练数据集? A:three ways: 1.像sklearn一样,提供一个将数据集切分成训练集和测试集的函数 ...
- 用交叉验证改善模型的预测表现-着重k重交叉验证
机器学习技术在应用之前使用“训练+检验”的模式(通常被称作”交叉验证“). 预测模型为何无法保持稳定? 让我们通过以下几幅图来理解这个问题: 此处我们试图找到尺寸(size)和价格(price)的关系 ...
- 机器学习——交叉验证,GridSearchCV,岭回归
0.交叉验证 交叉验证的基本思想是把在某种意义下将原始数据(dataset)进行分组,一部分做为训练集(train set),另一部分做为验证集(validation set or test set) ...
- 机器学习基础:(Python)训练集测试集分割与交叉验证
在上一篇关于Python中的线性回归的文章之后,我想再写一篇关于训练测试分割和交叉验证的文章.在数据科学和数据分析领域中,这两个概念经常被用作防止或最小化过度拟合的工具.我会解释当使用统计模型时,通常 ...
- S折交叉验证(S-fold cross validation)
S折交叉验证(S-fold cross validation) 觉得有用的话,欢迎一起讨论相互学习~Follow Me 仅为个人观点,欢迎讨论 参考文献 https://blog.csdn.net/a ...
- 总结:Bias(偏差),Error(误差),Variance(方差)及CV(交叉验证)
犀利的开头 在机器学习中,我们用训练数据集去训练(学习)一个model(模型),通常的做法是定义一个Loss function(误差函数),通过将这个Loss(或者叫error)的最小化过程,来提高模 ...
- 验证和交叉验证(Validation & Cross Validation)
之前在<训练集,验证集,测试集(以及为什么要使用验证集?)(Training Set, Validation Set, Test Set)>一文中已经提过对模型进行验证(评估)的几种方式. ...
- MATLAB曲面插值及交叉验证
在离散数据的基础上补插连续函数,使得这条连续曲线通过全部给定的离散数据点.插值是离散函数逼近的重要方法,利用它可通过函数在有限个点处的取值状况,估算出函数在其他点处的近似值.曲面插值是对三维数据进行离 ...
随机推荐
- 一个隐蔽的C语言问题反思
今天在编译一个C代码的时候,从别的编译ok的头文件中拷贝了一份在上面做修改,没想到修改好之后一直 无法调用这个头文件中的函数和变量.看了好久,才在预编译宏中找到了问题的根源.代码 如下所示: 头文件A ...
- Testing - 软件测试知识汇总
软件测试知识梳理 基础概念 : http://www.cnblogs.com/anliven/p/6070000.html 测试分类 : http://www.cnblogs.com/anliven/ ...
- 内链接、左右连接、union并集
第一个:内连接接 inner join select * from a inner join b on a.id=b.id where a.id =b.id (这种用法 ...
- python 使用PyInstaller将程序打包
PyInstaller可以用来打包python应用程序,打包完的程序就可以在没有安装Python解释器的机器上运行了.类似于C#窗体程序使用Setup Factory 9 Trial进行打包. 安装: ...
- IMEI
IMEI(International Mobile Equipment Identity)是国际移动设备身份码的缩写,国际移动装备辨识码,是由15位数字组成的"电子串号",它与每台 ...
- MySQL数据库设计规范
1. 规范背景与目的 MySQL数据库与 Oracle. SQL Server 等数据库相比,有其内核上的优势与劣势.我们在使用MySQL数据库的时候需要遵循一定规范,扬长避短.本规范旨在帮助或指导R ...
- SSE图像算法优化系列五:超高速指数模糊算法的实现和优化(10000*10000在100ms左右实现)。
今天我们来花点时间再次谈谈一个模糊算法,一个超级简单但是又超级牛逼的算法,无论在效果上还是速度上都可以和Boxblur, stackblur或者是Gaussblur想媲美,效果上,比Boxblur来的 ...
- Turbine——Hystrix集群监控
上一篇文章讲述了如何利用Hystrix Dashboard去监控断路器的Hystrix command.当我们有很多个服务的时候,这就需要聚合所有服务的Hystrix Dashboard的数据了.这就 ...
- Spring Boot初识(4)- Spring Boot整合JWT
一.本文介绍 上篇文章讲到Spring Boot整合Swagger的时候其实我就在思考关于接口安全的问题了,在这篇文章了我整合了JWT用来保证接口的安全性.我会先简单介绍一下JWT然后在上篇文章的基础 ...
- ProxySQL+MGR实现读写分离和主节点故障无感知切换 - 完整操作记录
前面的文章介绍了ProxySQL用法,这里说下ProxySQL中间件针对Mysql组复制模式实现读写分离以及主节点故障时能够自动切换到新的主节点,而应用对此过程无感知的功能.Mysql组复制(MGR) ...