这一篇巩固前几篇文章的学到的技术,利用urllib库爬取美女图片,其中采用了多线程,文件读写,
目录匹配,正则表达式解析,字符串拼接等知识,这些都是前文提到的,综合运用一下,写个爬虫
示例爬取美女图片。
先定义几个匹配规则和User_Agent

1
2
3
4
5
6
7
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/49.0.2623.221 Safari/537.36 SE 2.X MetaSr 1.0'
PATTERN1 = r'<div id="content">.*?<h2>(.*?)</h2>'
PATTERN2 = r'<p><img src="(.*?)"'
PATTERN2 = r'<p><img class=".*?src="(.*?)"'
PATTERN3 = r'''<li class='next-page'><a target="_blank" href='(.*?)'>下一页'''
PATTERN4 = r'^(.*)/'
PATTERN5 = r'^.*/(.*?)$'

读者可以根据不同网站的代码去修改这些规则,达到匹配一些网站的目的。

1定义抓图类

1
2
3
4
5
6
7
8
9
class GetMMPic(object):
def __init__(self,path,httpstr):
# 去除首位空格
path = path.strip()
# 去除尾部 \ 符号
path = path.rstrip('\\')
self.path = path
self.url = httpstr
self.user_agent = USER_AGENT

初始化构造函数中设置了路径和网络地址,以及请求的user_agent。

2封装信息请求和读取函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
def requestData(self,url, user_agent):
try:
req = request.Request(url)
req.add_header('User-Agent', user_agent)
response = request.urlopen(req,timeout = 8)
#bytes变为字符串
content = response.read().decode('utf-8')
return content
except error.URLError as e:
if hasattr(e,'code'):
print (e.code)
if hasattr(e,'reason'):
print (e.reason)
except error.HTTPError as e:
if hasattr(e,'code'):
print(e.code)
if hasattr(e,'reason'):
print(e.reason)
print('HTTPError!!!')

这个函数功能主要是请求url网络地址,加上user_agent后,获取数据,并且采用utf-8
编码方式解析。

3封装创建目录函数

1
2
3
4
5
6
7
8
9
10
11
def makedir(self,dirname):
joinpath = os.path.join(self.path,dirname)
print(joinpath)
isExists = os.path.exists(joinpath)
if isExists:
print('目录已经存在\n')
return None
else:
os.makedirs(joinpath)
print('创建成功\n')
return joinpath

该函数主要是完成在GMMPic类配置的路径下(默认是./),生成子目录,子目录的名字由
参数决定。简单地说就是要在当前目录下生成文件名对应的文件夹,保存不同的图片。

4 获取当前页面信息保存图片

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
def getPageData(self,httpstr):
content = self.requestData(self.url, self.user_agent)
namepattern = re.compile(PATTERN1,re.S)
nameresult = re.search(namepattern, content)
namestr = nameresult.group(1)
dirpath = self.makedir(namestr)
if not dirpath:
print('目录已存在')
return picpattern = re.compile(PATTERN2,re.S) lastpattern = re.compile(PATTERN5, re.S) while(1):
print('正在爬取%s........'%(namestr))
picitems = re.findall(picpattern,content)
for item in picitems:
picrs = re.search(lastpattern, item)
picname = picrs.group(1)
filedir = os.path.join(dirpath,picname)
url = quote(item, safe = string.printable)
try:
req = request.Request(url)
req.add_header('User-Agent',USER_AGENT)
response = request.urlopen(req)
picdata =response.read()
with open(filedir,'wb') as file:
file.write(picdata)
except error.URLError as e:
if hasattr(e,'code'):
print (e.code)
if hasattr(e,'reason'):
print (e.reason)
except error.HTTPError as e:
if hasattr(e,'code'):
print (e.code)
if hasattr(e,'reason'):
print (e.reason) print('\n%s爬取成功.......'%(namestr))
break

getPageData()函数根据PATTERN2匹配页面符合条件的图片资源,根据PATTERN5取出图片名字(不含类型),
通过for循环一个一个保存。

运行程序,提示输入网址,
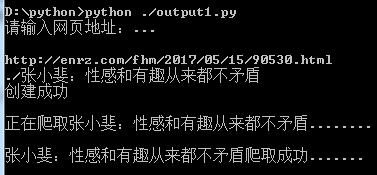
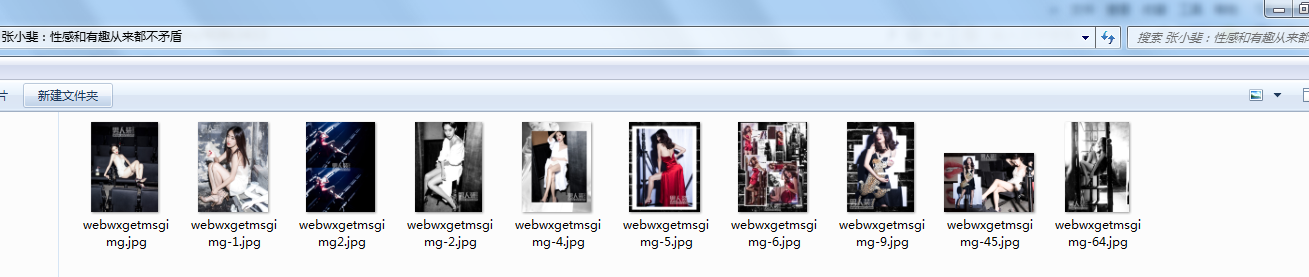
这里输入男人装某篇文章的地址,效果如下:
5 采用多线程提高并发能力

编写线程回调函数 workthread, 每个线程去爬不同的文章

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def workthread(item, user_agent,path):
strurl = 'http://yxpjw.club'+item[0]
picname = item[1]
print('正在爬取%s...........................\n' %(picname))
content = requestData(strurl,user_agent) strurl2 = re.search(r'^(.*)/',strurl).group(0)
print('https headers...............%s'%(strurl2))
#destname = os.path.join(path,picname+'.txt')
#with open(destname, 'w',encoding='gbk') as file:
#file.write(content)
destdir = os.path.join(path,picname)
os.makedirs(destdir)
page = 1
while(1):
content = getpagedata(content,destdir,page,strurl2)
if not content:
break
page = page + 1
print('%s数据爬取成功!!!\n'%(picname))

开辟多个线程,去爬首页各个分栏,实现自动化抓图

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def getDetailList(self,content):
s2 = r'<h2><a target="_blank" href="(.*?)" title="(.*?)"'
pattern =re.compile(s2 , re.S
)
result = re.findall(pattern, content)
with open('file.txt','w',encoding='gbk') as f:
f.write(content) if not result:
print('匹配规则不适配..............') threadsList=[]
for item in result:
t = threading.Thread(target = workthread, args=(item, self.user_agent, self.path))
threadsList.append(t)
t.start() for threadid in threadsList:
threadid.join()

源码下载地址:
https://github.com/secondtonone1/python-
谢谢关注我的公众号:
python学习(十七) 爬取MM图片的更多相关文章

  1. Python爬虫学习(6): 爬取MM图片

    为了有趣我们今天就主要去爬取以下MM的图片,并将其按名保存在本地.要爬取的网站为: 大秀台模特网 1. 分析网站 进入官网后我们发现有很多分类: 而我们要爬取的模特中的女模内容,点进入之后其网址为:h ...

  2. 百度图片爬虫-python版-如何爬取百度图片?

    上一篇我写了如何爬取百度网盘的爬虫,在这里还是重温一下,把链接附上: http://www.cnblogs.com/huangxie/p/5473273.html 这一篇我想写写如何爬取百度图片的爬虫 ...

  3. [Python学习] 简单爬取CSDN下载资源信息

    这是一篇Python爬取CSDN下载资源信息的样例,主要是通过urllib2获取CSDN某个人全部资源的资源URL.资源名称.下载次数.分数等信息.写这篇文章的原因是我想获取自己的资源全部的评论信息. ...

  4. python学习之——爬取网页信息

    爬取网页信息 说明:正则表达式有待学习,之后完善此功能 #encoding=utf-8 import urllib import re import os #获取网络数据到指定文件 def getHt ...

  5. python爬虫之爬取百度图片

    ##author:wuhao##爬取指定页码的图片,如果需要爬取某一类的所有图片,整体框架不变,但需要另作分析#import urllib.requestimport urllib.parseimpo ...

  6. Python 学习笔记---爬取海贼王动漫

    最近无聊整理的爬虫代码,可以自动爬取腾讯动漫的任意漫画,思路如下: 1. 先获取想下载的动漫url, 这里用了 getUrls ,直接获取动漫的最后一章 2. 然后进入到该动漫去获取要下载的图片url ...

  7. Python多线程爬虫爬取网页图片

    临近期末考试,但是根本不想复习!啊啊啊啊啊啊啊!!!! 于是做了一个爬虫,网址为 https://yande.re,网页图片为动漫美图(图片带点颜色........宅男福利 github项目地址为:h ...

  8. [python] 常用正则表达式爬取网页信息及分析HTML标签总结【转】

    [python] 常用正则表达式爬取网页信息及分析HTML标签总结 转http://blog.csdn.net/Eastmount/article/details/51082253 标签: pytho ...

  9. python 3 爬取百度图片

    python 3 爬取百度图片 学习了:https://blog.csdn.net/X_JS612/article/details/78149627

随机推荐

  1. python编辑用户登入界面

    1.需求分析 登入界面需要达到以下要求: 系统要有登入和注册两个选项可供选择 系统要能够实现登入出错提示,比如账户密码错误等,用户信息保存在user_info.txt文件夹中 系统要能够进行登入错误次 ...

  2. Codeforces Round #553 (Div. 2) C

    C. Problem for Nazar time limit per test 1 second memory limit per test 256 megabytes input standard ...

  3. varnish squid nginx比较

    linux运维中,web cache server方案的部署是一个很重要的环节,选择也有很多种比如:varnish.squid.nginx.下面就对当下常用的这几个web cache server做一 ...

  4. Scrum立会报告+燃尽图(十月二十八日总第十九次)

    此作业要求参见:https://edu.cnblogs.com/campus/nenu/2018fall/homework/2288 项目地址:https://git.coding.net/zhang ...

  5. 王者荣耀交流协会 — Alpha阶段中间产物

    1. 版本控制 Coding :https://git.coding.net/SuperCodingChao/PSPDaily.git 2. 软件功能说明书 软件功能说明书发布在小组成员袁玥同学的博客 ...

  6. 每日Scrum--No.2

    Yesterday:找地图 Today: 找到最适合我们软件的地图版本 Problem:找不到特别匹配的版本

  7. MySQL数据库错误号:2003 - Can't connect to MYSQL server on 'localhost'(10061)

    打开Windows+R在里面输入services.msc打开服务 在MySQL服务是右键点击启动,让其状态显为正在运行即可 启动完毕,然后再用命令CMD去连接,或者Navicat都不再报上面的错

  8. PHP面向对象之final关键字

    最终类 最终类,其实就是一种特殊要求的类:要求该类不允许往下继承下去. 形式: final  class  类名{ //类的成员定义...跟一般类的定义一样! } 最终方法 最终方法,就是一个不允许下 ...

  9. utuntu下安装pip&pip3

    在utuntu下建议不要使用apt-get install 安装pip,会出现很多问题. 建议使用如下方式安装: wget https://bootstrap.pypa.io/get-pip.py - ...

  10. 【C++】深度探索C++对象模型读书笔记--构造函数语义学(The Semantics of constructors)(四)

    成员们的初始化队伍(member Initia 有四种情况必须使用member initialization list: 1. 当初始化一个reference member时: 2. 当初始化一个co ...