
[转]毕设- 深入HBase架构解析(二)
前言
这是《深入HBase架构解析(一)》的续,不多废话,继续。。。。
HBase读的实现
通过前文的描述,我们知道在HBase写时,相同Cell(RowKey/ColumnFamily/Column相同)并不保证在一起,甚至删除一个Cell也只是写入一个新的Cell,它含有Delete标记,而不一定将一个Cell真正删除了,因而这就引起了一个问题,如何实现读的问题?要解决这个问题,我们先来分析一下相同的Cell可能存在的位置:首先对新写入的Cell,它会存在于MemStore中;然后对之前已经Flush到HDFS中的Cell,它会存在于某个或某些StoreFile(HFile)中;最后,对刚读取过的Cell,它可能存在于BlockCache中。既然相同的Cell可能存储在三个地方,在读取的时候只需要扫瞄这三个地方,然后将结果合并即可(Merge Read),在HBase中扫瞄的顺序依次是:BlockCache、MemStore、StoreFile(HFile)。其中StoreFile的扫瞄先会使用Bloom Filter过滤那些不可能符合条件的HFile,然后使用Block Index快速定位Cell,并将其加载到BlockCache中,然后从BlockCache中读取。我们知道一个HStore可能存在多个StoreFile(HFile),此时需要扫瞄多个HFile,如果HFile过多又是会引起性能问题。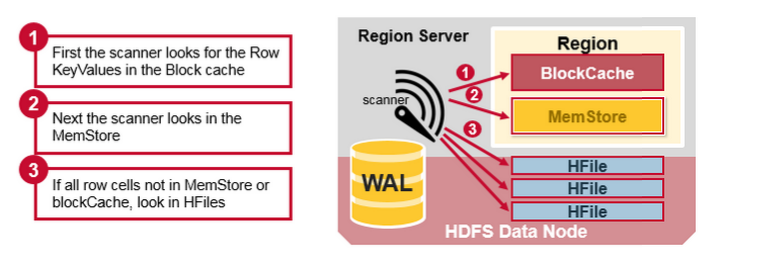
Compaction
MemStore每次Flush会创建新的HFile,而过多的HFile会引起读的性能问题,那么如何解决这个问题呢?HBase采用Compaction机制来解决这个问题,有点类似Java中的GC机制,起初Java不停的申请内存而不释放,增加性能,然而天下没有免费的午餐,最终我们还是要在某个条件下去收集垃圾,很多时候需要Stop-The-World,这种Stop-The-World有些时候也会引起很大的问题,比如参考本人写的这篇文章,因而设计是一种权衡,没有完美的。还是类似Java中的GC,在HBase中Compaction分为两种:Minor Compaction和Major Compaction。
- Minor Compaction是指选取一些小的、相邻的StoreFile将他们合并成一个更大的StoreFile,在这个过程中不会处理已经Deleted或Expired的Cell。一次Minor Compaction的结果是更少并且更大的StoreFile。(这个是对的吗?BigTable中是这样描述Minor Compaction的:As write operations execute, the size of the memtable in- creases. When the memtable size reaches a threshold, the memtable is frozen, a new memtable is created, and the frozen memtable is converted to an SSTable and written to GFS. This minor compaction process has two goals: it shrinks the memory usage of the tablet server, and it reduces the amount of data that has to be read from the commit log during recovery if this server dies. Incom- ing read and write operations can continue while com- pactions occur. 也就是说它将memtable的数据flush的一个HFile/SSTable称为一次Minor Compaction)
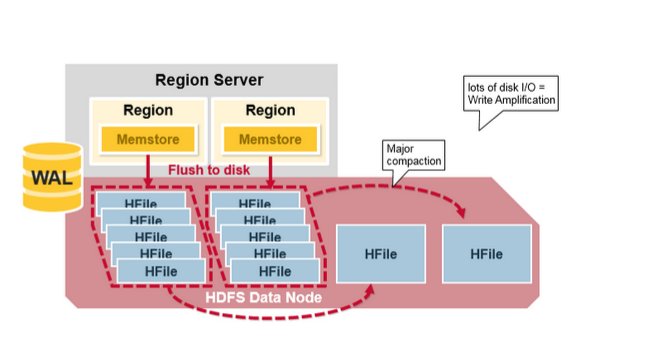
- Major Compaction是指将所有的StoreFile合并成一个StoreFile,在这个过程中,标记为Deleted的Cell会被删除,而那些已经Expired的Cell会被丢弃,那些已经超过最多版本数的Cell会被丢弃。一次Major Compaction的结果是一个HStore只有一个StoreFile存在。Major Compaction可以手动或自动触发,然而由于它会引起很多的IO操作而引起性能问题,因而它一般会被安排在周末、凌晨等集群比较闲的时间。
更形象一点,如下面两张图分别表示Minor Compaction和Major Compaction。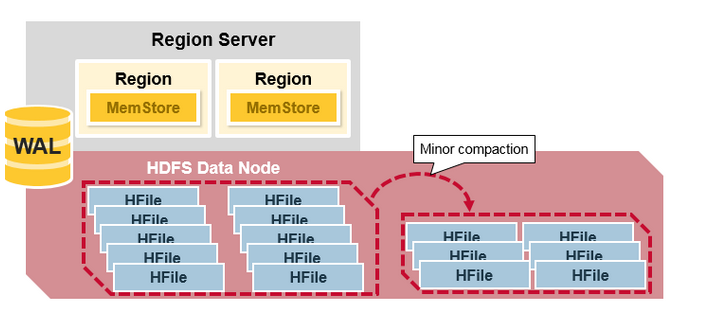
HRegion Split
最初,一个Table只有一个HRegion,随着数据写入增加,如果一个HRegion到达一定的大小,就需要Split成两个HRegion,这个大小由hbase.hregion.max.filesize指定,默认为10GB。当split时,两个新的HRegion会在同一个HRegionServer中创建,它们各自包含父HRegion一半的数据,当Split完成后,父HRegion会下线,而新的两个子HRegion会向HMaster注册上线,处于负载均衡的考虑,这两个新的HRegion可能会被HMaster分配到其他的HRegionServer中。关于Split的详细信息,可以参考这篇文章:《Apache HBase Region Splitting and Merging》。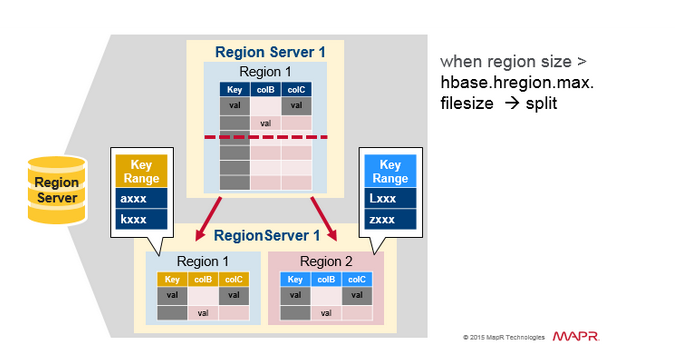
HRegion负载均衡
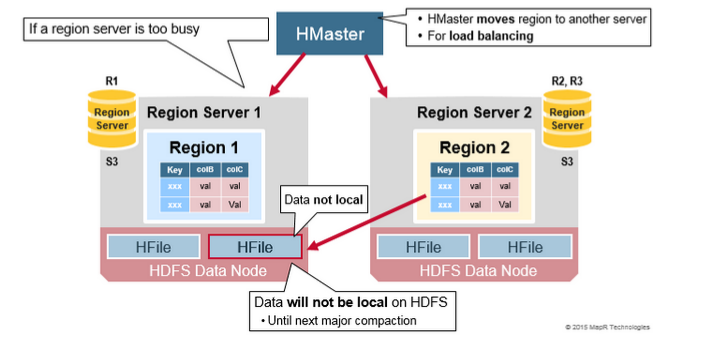
在HRegion Split后,两个新的HRegion最初会和之前的父HRegion在相同的HRegionServer上,出于负载均衡的考虑,HMaster可能会将其中的一个甚至两个重新分配的其他的HRegionServer中,此时会引起有些HRegionServer处理的数据在其他节点上,直到下一次Major Compaction将数据从远端的节点移动到本地节点。
HRegionServer Recovery
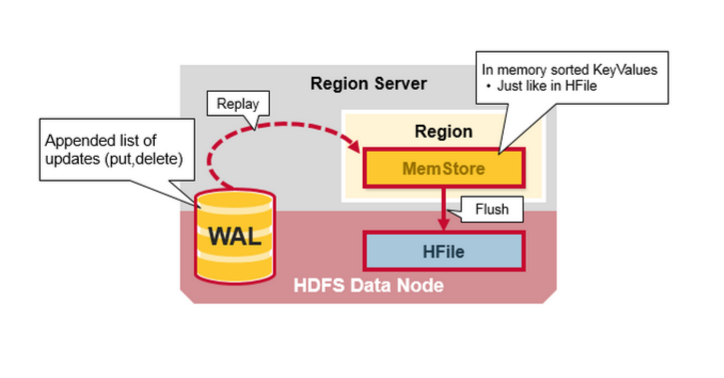
当一台HRegionServer宕机时,由于它不再发送Heartbeat给ZooKeeper而被监测到,此时ZooKeeper会通知HMaster,HMaster会检测到哪台HRegionServer宕机,它将宕机的HRegionServer中的HRegion重新分配给其他的HRegionServer,同时HMaster会把宕机的HRegionServer相关的WAL拆分分配给相应的HRegionServer(将拆分出的WAL文件写入对应的目的HRegionServer的WAL目录中,并并写入对应的DataNode中),从而这些HRegionServer可以Replay分到的WAL来重建MemStore。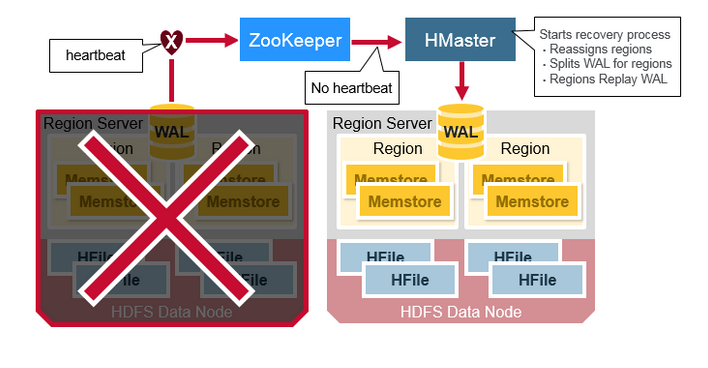
HBase架构简单总结
在NoSQL中,存在著名的CAP理论,即Consistency、Availability、Partition Tolerance不可全得,目前市场上基本上的NoSQL都采用Partition Tolerance以实现数据得水平扩展,来处理Relational DataBase遇到的无法处理数据量太大的问题,或引起的性能问题。因而只有剩下C和A可以选择。HBase在两者之间选择了Consistency,然后使用多个HMaster以及支持HRegionServer的failure监控、ZooKeeper引入作为协调者等各种手段来解决Availability问题,然而当网络的Split-Brain(Network Partition)发生时,它还是无法完全解决Availability的问题。从这个角度上,Cassandra选择了A,即它在网络Split-Brain时还是能正常写,而使用其他技术来解决Consistency的问题,如读的时候触发Consistency判断和处理。这是设计上的限制。
从实现上的优点:
- HBase采用强一致性模型,在一个写返回后,保证所有的读都读到相同的数据。
- 通过HRegion动态Split和Merge实现自动扩展,并使用HDFS提供的多个数据备份功能,实现高可用性。
- 采用HRegionServer和DataNode运行在相同的服务器上实现数据的本地化,提升读写性能,并减少网络压力。
- 内建HRegionServer的宕机自动恢复。采用WAL来Replay还未持久化到HDFS的数据。
- 可以无缝的和Hadoop/MapReduce集成。
实现上的缺点:
- WAL的Replay过程可能会很慢。
- 灾难恢复比较复杂,也会比较慢。
- Major Compaction会引起IO Storm。
- 。。。。
参考:
https://www.mapr.com/blog/in-depth-look-hbase-architecture#.VdNSN6Yp3qx
http://jimbojw.com/wiki/index.php?title=Understanding_Hbase_and_BigTable
http://hbase.apache.org/book.html
http://www.searchtb.com/2011/01/understanding-hbase.html
http://research.google.com/archive/bigtable-osdi06.pdf
[转]毕设- 深入HBase架构解析(二)的更多相关文章
- [转]毕设- 深入HBase架构解析(一)
深入HBase架构解析(一) 前记 公司内部使用的是MapR版本的Hadoop生态系统,因而从MapR的官网看到了这篇文文章:An In-Depth Look at the HBase Archi ...
- HBASE架构解析(二)
http://www.blogjava.net/DLevin/archive/2015/08/22/426950.html HBase读的实现 通过前文的描述,我们知道在HBase写时,相同Cell( ...
- 深入HBase架构解析(二)【转】
转自:http://www.blogjava.net/DLevin/archive/2015/08/22/426950.html 前言 这是<深入HBase架构解析(一)>的续,不多废话, ...
- 【转】HBase架构解析
转载地址:http://www.blogjava.net/DLevin/archive/2015/08/22/426877.html HBase架构组成 HBase采用Master/Slave架构搭建 ...
- HBASE架构解析(一)
http://www.blogjava.net/DLevin/archive/2015/08/22/426877.html 前记 公司内部使用的是MapR版本的Hadoop生态系统,因而从MapR的官 ...
- 深入HBase架构解析(一)[转]
前记 公司内部使用的是MapR版本的Hadoop生态系统,因而从MapR的官网看到了这篇文文章:An In-Depth Look at the HBase Architecture,原本想翻译全文,然 ...
- 深入HBase架构解析(一)
前记 公司内部使用的是MapR版本的Hadoop生态系统,因而从MapR的官网看到了这篇文文章:An In-Depth Look at the HBase Architecture,原本想翻译全文,然 ...
- Tomcat架构解析(二)-----Connector、Tomcat启动过程以及Server的创建过程
Connector用于跟客户端建立连接,获取客户端的Socket,交由Container处理.需要解决的问题有监听.协议以及处理器映射等等. 一.Connector设计 Connector要实现的 ...
- HBase架构解析
Hbase组件  客户端Client 整个HBase集群的入口 使用HBase RPC机制与HMaster和HRegionserver通信 与HMaster通信进行管理类的操作 与HRegionse ...
随机推荐
- 使用html替代excel导出数据的优势和技巧
之前一直使用NPOI或者微软office官方组件导出excel,但是多多少少会有写小问题,不是数据量不能过大(xls的问题,用xlsx就可以更大了),就是速度慢,或者文件体积太大 中途采用过csv(逗 ...
- .NET程序调试技巧(一):快速定位异常的一些方法
作为一个程序员,解BUG是我们工作中常做的工作,甚至可以说解决问题能力是一个人工作能力的重要体现.因为这体现了一个程序员的技术水平.技术深度.经验等等. 那么在我们解决BUG的过程中,定位问题是非常重 ...
- 【SR】正则化
MAP框架:
- CornerStone配置SVN,HTTP及SVN简单使用说明
本文转载至 http://blog.csdn.net/allison162004/article/details/38796857 已经安装了的小伙伴请直接看三步骤 一.下载地址 CornerSton ...
- SQL case when else
先占个坑,sql 版本的swith case SELECT Oldvote, (CASE THEN (SELECT NOW() from dual) END) as "number" ...
- ORACLE_SID的查找
SID是System IDentifier的缩写,而ORACLE_SID就是Oracle System Identifier的缩写,在Oracle系统中,ORACLE_SID以环境变量的形式出现,在特 ...
- Career Planning:Developers Best Practices Tutorial
This small tutorial is based on my past 16+ years of experience in software development industry. I ...
- python类的相关知识第一部分
一.类的相关概念 (1).什么是类 具有同种属性的对象称为类,是个抽象的概念.比如说:汽车.人.狗.神: (2).什么是对象或实例 日常生活中的所有东西都是对象,是类的实例化.比如说:推土车是汽车的实 ...
- 面向对象 - 1.封装之如何实现属性的隐藏/2.封装的意义/3.封装与扩展性/4.property的使用
1.封装之如何实现属性的隐藏封装: __x=1 # 把数据属性隐藏 (如何实现隐藏) 类定义阶段 __开头发生了变形 __x --> _A__x特点: 1.在类外部无法直接:obj.__Attr ...
- json/pickle/shelve/xml/configparser/hashlib/subprocess - 总结
序列化:序列化指把内存里的数据类型转成字符串,以使其能存储到硬盘或通过网络传输到远程,因为硬盘或网络传输时只能接受bytes为什么要序列化:可以直接把内存数据(eg:10个列表,3个嵌套字典)存到硬盘 ...