
Linux Hadoop2.7.3 安装(单机模式) 一
Linux Hadoop2.7.3 安装(单机模式) 一
Linux Hadoop2.7.3 安装(单机模式) 二
java环境安装 http://www.cnblogs.com/zeze/p/5902124.html
java 环境安装配置 etc/profile:
export JAVA_HOME=/usr/jdk/jdk1..0_112

export JRE_HOME=/usr/jdk/jdk1..0_112/jre

export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib:$CLASSPATH

export PATH=$JAVA_HOME/bin:$PATH
SSH安装 http://www.linuxidc.com/Linux/2014-01/94793.htm
yum install openssh-server
创建ssh文件夹,在ssh文件夹下创建两个文件id_dsa及id_dsa.pub,这是一对私钥和公钥,然后把id_dsa.pub(公钥)追加到授权的key里面去。
ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa

cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys
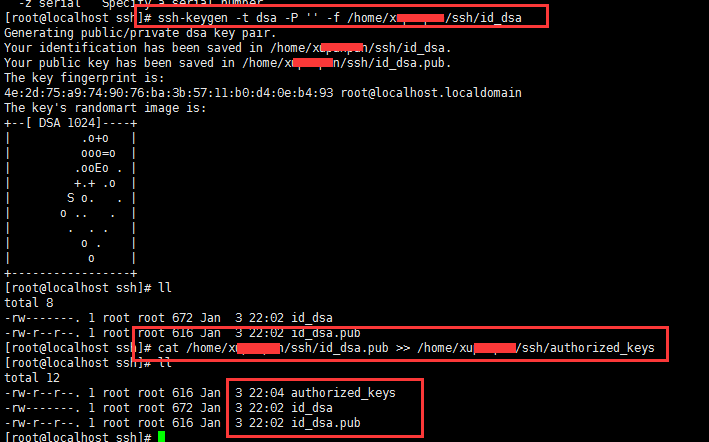
登陆ssh,输入命令:
ssh localhost
第一次登陆可能会询问是否继续链接,输入yes即可,以后登陆直接登进去。

安装hadoop2.7.3
下载:http://apache.fayea.com/hadoop/common/hadoop-2.7.3/hadoop-2.7.3.tar.gz
tar xzvf hadoop-2.7..tar.gz

mv hadoop-2.7. hadoop
配置启动Hadoop
1、修改hadoop2.7.3/etc/hadoop/hadoop-env.sh指定JAVA_HOME
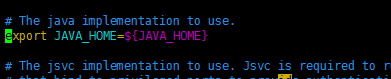
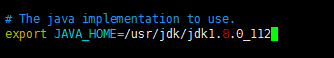
2、修改hdfs的配置文件
修改hadoop2.7.3/etc/hadoop/core-site.xml 如下:
<configuration>

    <!-- 指定HDFS老大(namenode)的通信地址 -->

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://0.0.0.0:9000</value>

    </property>

    <!-- 指定hadoop运行时产生文件的存储路径 -->

    <property>

        <name>hadoop.tmp.dir</name>

        <value>/home/xupanpan/hadoop/temp</value>

    </property>

</configuration>

修改hadoop2.7.3/etc/hadoop/hdfs-site.xml 如下:
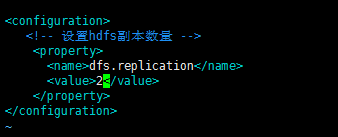
3、启动与停止
第一次启动得先格式化
/home/xupanpan/hadoop/hadoop/bin/hdfs namenode -format
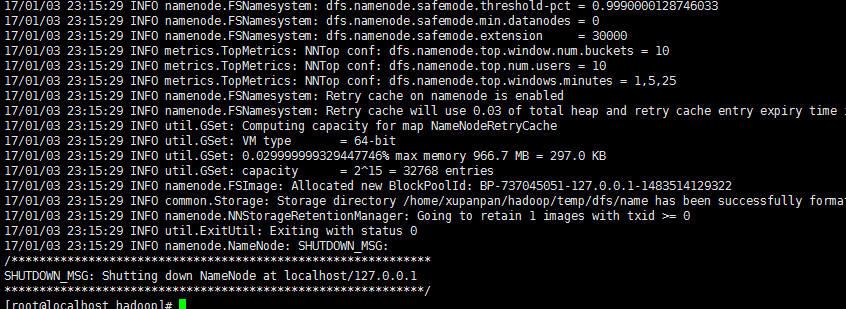
启动hdfs
/home/xupanpan/hadoop/hadoop/sbin/start-dfs.sh

预览
http://192.168.20.225:50070/

停止hdfs
/home/xupanpan/hadoop/hadoop/sbin/stop-dfs.sh
Linux Hadoop2.7.3 安装(单机模式) 一的更多相关文章
- Linux Hadoop2.7.3 安装(单机模式) 二
Linux Hadoop2.7.3 安装(单机模式) 一 Linux Hadoop2.7.3 安装(单机模式) 二 YARN是Hadoop 2.0中的资源管理系统,它的基本设计思想是将MRv1中的Jo ...
- Ubuntu14.04下安装Hadoop2.5.1 (单机模式)
本文地址:http://www.cnblogs.com/archimedes/p/hadoop-standalone-mode.html,转载请注明源地址. 欢迎关注我的个人博客:www.wuyudo ...
- Ubuntu 14.04下安装Hadoop2.4.0 (单机模式)
转自 http://www.linuxidc.com/Linux/2015-01/112370.htm 一.在Ubuntu下创建Hadoop组和hadoop用户 增加hadoop用户组,同时在该组里增 ...
- 一、Ubuntu14.04下安装Hadoop2.4.0 (单机模式)
一.在Ubuntu下创建hadoop组和hadoop用户 增加hadoop用户组,同时在该组里增加hadoop用户,后续在涉及到hadoop操作时,我们使用该用户. 1.创建hadoop用户组 2.创 ...
- Ubuntu14.04下安装Hadoop2.4.0 (单机模式)
一.在Ubuntu下创建hadoop组和hadoop用户 增加hadoop用户组,同时在该组里增加hadoop用户,后续在涉及到hadoop操作时,我们使用该用户. 1.创建hadoop用户组 2.创 ...
- Hadoop2.6.0安装—单机/伪分布
目录 环境准备 创建hadoop用户 更新apt 配置SSH免密登陆 安装配置Java环境 安装Hadoop Hadoop单机/伪分布配置 单机Hadoop 伪分布Hadoop 启动Hadoop 停止 ...
- hadoop2.6.4 搭建单机模式
注(要先安装jdk,最好jdk版本>=1.7) 安装jdk http://www.cnblogs.com/zhangXingSheng/p/6228432.html 给普通用户添加su ...
- linux centos7最小化安装桥接模式网络设置、xshell、xftf
一.网络连接设置1.桥接模式 使用电脑真实网卡,可以和自己的电脑连接,也可以和外部网络连接2.NAT模式 使用wmware network adapter vmnet8虚拟网卡,可以和自己的电脑连接, ...
- linux centos7最小化安装NAT模式网络设置
1.网络连接设置为NAT模式2.开启CentOS7,以root登陆3.vi /etc/sysconfig/network-scripts/ifcfg-ensXXXX4.设置BOOTPROTO=dhcp ...
随机推荐
- 关于Unity3D自定义编辑器的学习
被人物编辑器折腾了一个月,最终还是交了点成品上去(还要很多优化都还么做). 刚接手这项工作时觉得没概念,没想法,不知道.后来就去看<<Unity5.X从入门到精通>>中有关于 ...
- 【分享】标准springMVC+mybatis项目maven搭建最精简教程
文章由来:公司有个实习同学需要做毕业设计,不会搭建环境,我就代劳了,顺便分享给刚入门的小伙伴,我是自学的JAVA,所以我懂的.... (大图直接观看显示很模糊,请在图片上点击右键然后在新窗口打开看) ...
- C# 发送邮件 附件名称为空
示例代码: // 1.创建邮件 MailMessage mailMsg = new MailMessage(); mailMsg.To.Add(new MailAddress("test@ ...
- 获取微软原版“Windows 10 推送器(GWX)” 卸载工具
背景: 随着Windows 10 免费更新的结束,针对之前提供推送通知的工具(以下简称GWX)来说使命已经结束,假设您还未将Windows 8.1 和Windows 7 更新到Windows 10 的 ...
- JDBC简介
jdbc连接数据库的四个对象 DriverManager 驱动类 DriverManager.registerDriver(new com.mysql.jdbc.Driver());不建议使用 ...
- 使用DeviceOne实现微信小程序功能
微信小程序即将推出,还没推出就火的不行了.基于微信这个巨大平台,小程序必然能有巨大成功.不过它并不能完全取代App,该开发App还得开发.如果我们自己想实现一个基于自己的APP包含类似微信的小程序功能 ...
- WINDOWS系统下MYSQL安装过程中的注意事项
1.首先MySQL的安装方式有两种:一种是MSI安装方式,很简单就像安装Windows软件一样.另外一种就是ZIP安装方式.这种相对而言比较麻烦.新手推荐MSI安装方式. 安装方式有以下两种: MSI ...
- asp.net core 实战之 redis 负载均衡和"高可用"实现
1.概述 分布式系统缓存已经变得不可或缺,本文主要阐述如何实现redis主从复制集群的负载均衡,以及 redis的"高可用"实现, 呵呵双引号的"高可用"并不是 ...
- MySQL数据库罕见的BUG——Can't get hostname for your address
在连接mysql jdbc时候,抛出了 com.mysql.jdbc.exceptions.jdbc4.MySQLNonTransientConnectionException: Communicat ...
- MySQL+Amoeba实现数据库主从复制和读写分离
MySQL读写分离是在主从复制的基础上进一步通过在master上执行写操作,在slave上执行读操作来实现的.通过主从复制,master上的数据改动能够同步到slave上,从而保持了数据的一致性.实现 ...