
HBase 中加盐之后的表如何读取:Spark 篇
在 《HBase 中加盐之后的表如何读取:协处理器篇》 文章中介绍了使用协处理器来查询加盐之后的表,本文将介绍第二种方法来实现相同的功能。
我们知道,HBase 为我们提供了 hbase-mapreduce 工程包含了读取 HBase 表的 InputFormat、OutputFormat 等类。这个工程的描述如下:
This module contains implementations of InputFormat, OutputFormat, Mapper, Reducer, etc which are needed for running MR jobs on tables, WALs, HFiles and other HBase specific constructs. It also contains a bunch of tools: RowCounter, ImportTsv, Import, Export, CompactionTool, ExportSnapshot, WALPlayer, etc.
我们也知道,虽然上面描述的是 MR jobs,但是 Spark 也是可以使用这些 InputFormat、OutputFormat 来读写 HBase 表的,如下:
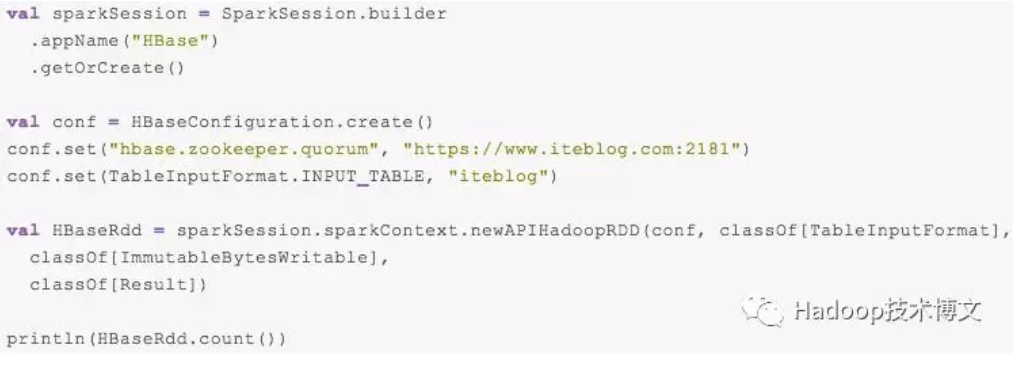
上面程序使用 TableInputFormat 计算了 iteblog 表的总行数。如果我们想查询某个 UID 的所有历史记录如何实现呢?如果你查看 TableInputFormat 代码,你会发现其包含了很大参数设置:
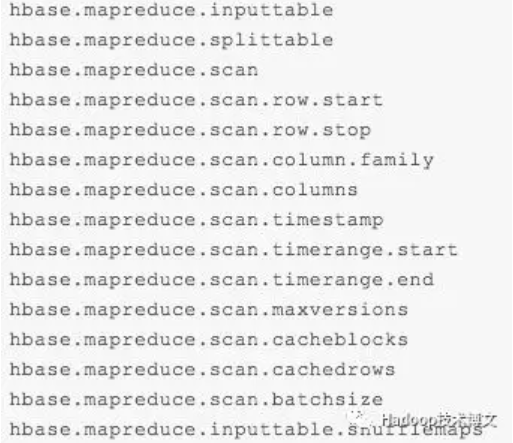
其中 hbase.mapreduce.inputtable 就是需要查询的表,也就是上面 Spark 程序里面的 TableInputFormat.INPUT_TABLE。而 hbase.mapreduce.scan.row.start 和 hbase.mapreduce.scan.row.stop 分别对应的是需要查询的起止 Rowkey,所以我们可以利用这个信息来实现某个范围的数据查询。但是要注意的是,iteblog 这张表是加盐了,所以我们需要在 UID 之前加上一些前缀,否则是查询不到数据的。不过 TableInputFormat 并不能实现这个功能。那如何处理呢?答案是重写 TableInputFormat 的 getSplits 方法。
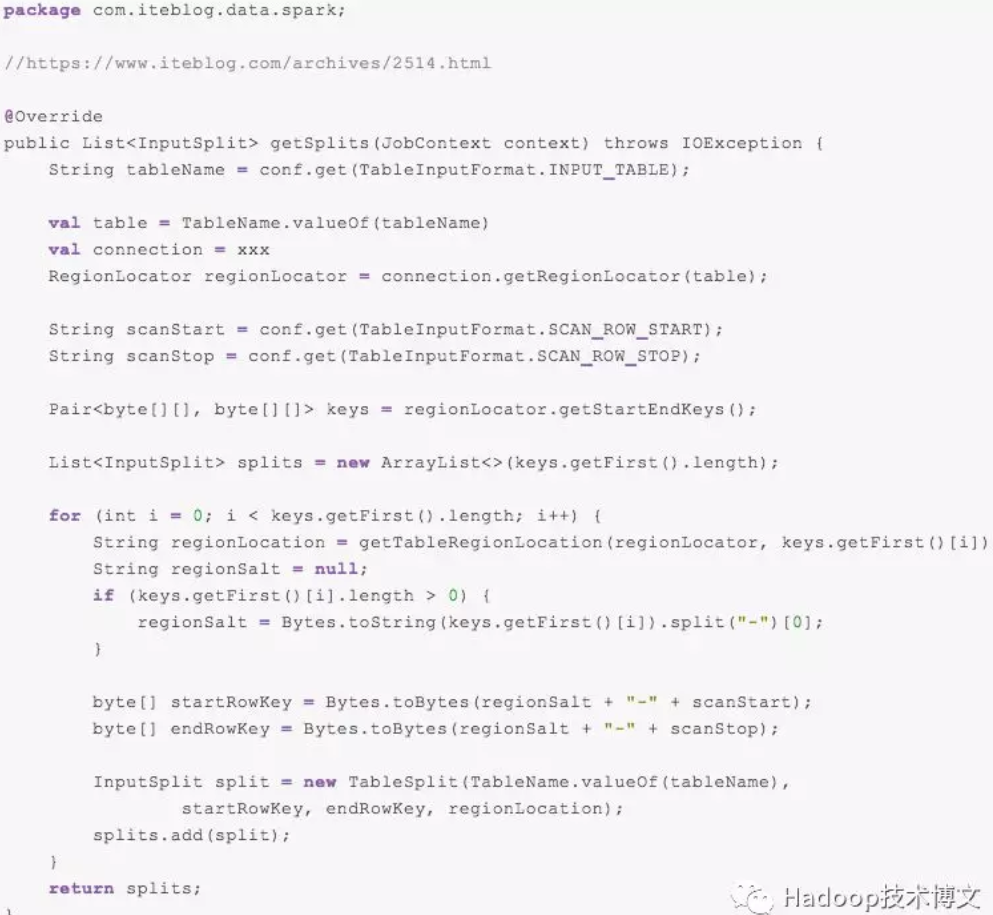
从名字也可以看出 getSplits 是计算有多少个 Splits。在 HBase 中,一个 Region 对应一个 Split,对应于 TableSplit 实现类。TableSplit 的构造是需要传入 startRow 和 endRow。startRow 和 endRow 对应的就是上面 hbase.mapreduce.scan.row.start 和 hbase.mapreduce.scan.row.stop 参数传进来的值,所以如果我们需要处理加盐表,就需要在这里实现。
另一方面,我们可以通过 RegionLocator 的 getStartEndKeys() 拿到某张表所有 Region 的 StartKeys 和 EndKeys 的。然后将拿到的 StartKey 和用户传进来的 hbase.mapreduce.scan.row.start 和 hbase.mapreduce.scan.row.stop 值进行拼接即可实现我们要的需求。根据这个思路,我们的代码就可以按照如下实现:
然后我们同样查询 UID = 1000 的用户所有历史记录,那么我们的程序可以如下实现:
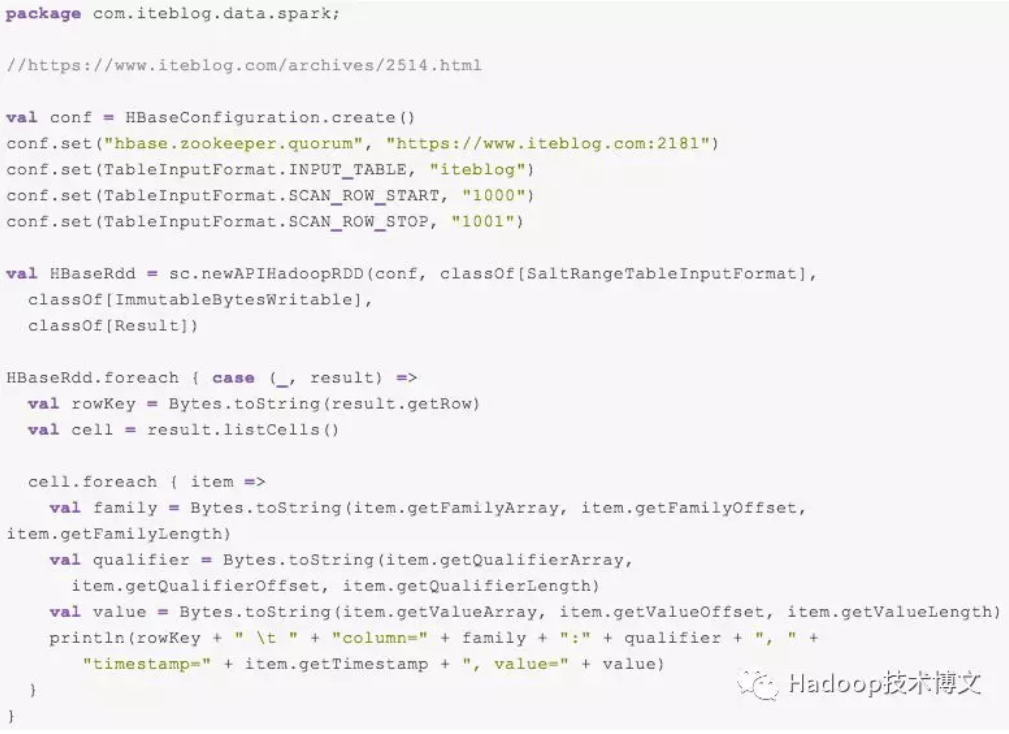
我们编译打包上面的程序,然后使用下面命令运行上述程序:
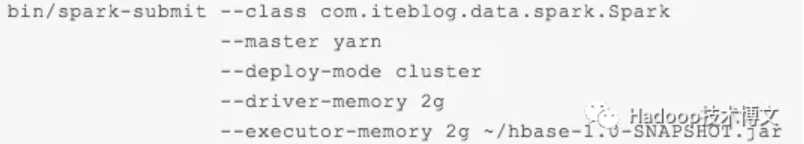
得到的结果如下:

和前面文章使用 HBase Shell 输出结果一致。好了,到这里就介绍完如何在 Spark 中查询 HBase 加盐之后的表了,明天我会介绍如何在 MapReduce 中查询 HBase 加盐之后的表,敬请关注。
HBase 中加盐之后的表如何读取:Spark 篇的更多相关文章
- HBase中加盐(Salting)之后的表如何读取:协处理器文章
我们介绍了避免数据斑点的三种比较常见方法: 加盐-盐腌 哈希-散列 反转-反转 其中在加盐(Salting)的方法里面是这么描述的:给Rowkey分配一个随机指针以使其和之前排序不同.但是在Rowke ...
- HBase 中加盐(Salting)之后的表如何读取:Spark 篇
我们知道,HBase 为我们提供了 hbase-mapreduce 工程包含了读取 HBase 表的 InputFormat.OutputFormat 等类.这个工程的描述如下:This module ...
- hbase数据加盐(Salting)存储与协处理器查询数据的方法
转自: https://blog.csdn.net/finad01/article/details/45952781 ----------------------------------------- ...
- kylin的clube合并后清理hbase中产生的相关历史表
kylin的clube合并后清理hbase中产生的相关历史表 kylin 的clube 历史的每次构建,都会产生一个hbase的表:虽然可以设置按照一定策略合并,但是合并后hbase 历史表不会被自动 ...
- 【转帖】HBase读写的几种方式(二)spark篇
HBase读写的几种方式(二)spark篇 https://www.cnblogs.com/swordfall/p/10517177.html 分类: HBase undefined 1. HBase ...
- HBase读写的几种方式(二)spark篇
1. HBase读写的方式概况 主要分为: 纯Java API读写HBase的方式: Spark读写HBase的方式: Flink读写HBase的方式: HBase通过Phoenix读写的方式: 第一 ...
- Ecplise 中 加载JDBC 连接 Mysql 数据库读取数据
准备工作 首先下载 JDBC 驱动,下载地址https://www.mysql.com/products/connector/ 将压缩包解压得到文件 mysql-connector-java-5.1. ...
- [Phoenix] 四、加盐表
摘要: 在密码学中,加盐是指在散列之前将散列内容(例如:密码)的任意固定位置插入特定的字符串.这个在散列中加入字符串的方式称为“加盐”.其作用是让加盐后的散列结果和没有加盐的结果不相同,在不同的应用情 ...
- 使用Hive或Impala执行SQL语句,对存储在HBase中的数据操作
CSSDesk body { background-color: #2574b0; } /*! zybuluo */ article,aside,details,figcaption,figure,f ...
随机推荐
- java_第一年_JDBC(4)
注:该篇只是为了小白的我熟悉下JDBC的代码,练习篇 在mysql中建test测试库,并创建一张employees表,加入一些数据如下图: 通过JDBC连接对表中数据进行添加: package lzj ...
- LeetCode #657. Robot Return to Origin 机器人能否返回原点
https://leetcode-cn.com/problems/robot-return-to-origin/ 设置 flagUD 记录机器人相对于原点在纵向上的最终位置 flagRL 记录机器人相 ...
- 洛谷 P1972 [SDOI2009]HH的项链(树状数组,离线)
传送门 解题思路 因为是求区间的不同种类数,所以我们用树状数组(貌似并没有什么直接联系) (...表示到) 还是和原来一样,用s[i]来表示a[i-lowbit(i)]...a[i]的种类数. 因为有 ...
- 1571. [Usaco2009 Open]滑雪课Ski
传送门 可以想到 $dp$,设 $f[i][j]$ 表示当前等级为 $i$,时间为 $j$ 的最大滑雪次数 显然上课不会上让自己等级降低的课,所以第一维 $i$ 满足无后效性 然后直接枚举 $i,j$ ...
- Java中POJO及其细分XO、DAO的概念
各层命名规约: A) Service/DAO 层方法命名规约 1) 获取单个对象的方法用 get 做前缀. 2) 获取多个对象的方法用 list 做前缀. 3) 获取统计值的方法用 count 做前缀 ...
- 【ASE高级软件工程】Alpha 阶段 backend组 scrum1 记录
本次会议于11月4日,19:10 在微软北京西二号楼13478召开,持续40分钟. 与会人员:Haifeng Chen, Zhikai Chen, Hao Wang, Jia Ning 请假: Xin ...
- Switch能否用String类型做参数?
switch(expr): 其中,expr参数可以是一个枚举常量(由整型或字符类型实现)或一个整数表达式,其中整数表达式可以是基本类型int或其包装类Integer.由于byte.short和char ...
- java ArrayList的基本使用
package java06; /* 数组的长度是不可以发生改变的 Arraylist 集合的长度可以发生改变 对于ArrayList来说,有一个尖括号<E>代表泛型 泛型:就是装在结合中 ...
- 记录每个action执行时间
import org.apache.commons.lang.time.StopWatch; import org.aspectj.lang.JoinPoint; import org.aspectj ...
- Python3.5-20190529-os模块
os.getcwd() 获取当前路径os.listdir("路径") 返回该路径下面所有的文件os.path.abspath(path):返回path的绝对路径.os.path.s ...