
python regrex
Python正则表达式指南
The source from the website http://www.cnblogs.com/huxi/archive/2010/07/04/1771073.html
1. 正则表达式基础
1.1. 简单介绍
正则表达式并不是Python的一部分。正则表达式是用于处 理字符串的强大工具,拥有自己独特的语法以及一个独立的处理引擎,效率上可能不如str自带的方法,但功能十分强大。得益于这一点,在提供了正则表达式的 语言里,正则表达式的语法都是一样的,区别只在于不同的编程语言实现支持的语法数量不同;但不用担心,不被支持的语法通常是不常用的部分。如果已经在其他 语言里使用过正则表达式,只需要简单看一看就可以上手了。
下图展示了使用正则表达式进行匹配的流程:
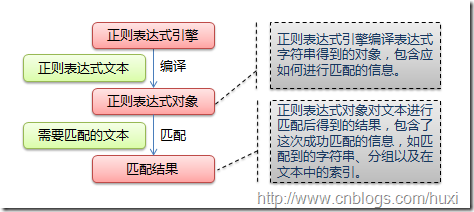
正则表达式的大致匹配过程是:依次拿出表达式和文本中的字符比较,如果每一个字符都能匹配,则匹配成功;一旦有匹配不成功的字符则匹配失败。如果表达式中有量词或边界,这个过程会稍微有一些不同,但也是很好理解的,看下图中的示例以及自己多使用几次就能明白。
下图列出了Python支持的正则表达式元字符和语法:

1.2. 数量词的贪婪模式与非贪婪模式
正则表达式通常用于在文本中查找匹配的字符串。Python里数量词默认是贪婪的 (在少数语言里也可能是默认非贪婪),总是尝试匹配尽可能多的字符;非贪婪的则相反,总是尝试匹配尽可能少的字符。例如:正则表达式"ab*"如果用于查 找"abbbc",将找到"abbb"。而如果使用非贪婪的数量词"ab*?",将找到"a"。
1.3. 反斜杠的困扰
与大多数编程语言相同,正则表达式里使用"\"作为转义字符,这就可能造成反斜杠困扰。假如你需要匹 配文本中的字符"\",那么使用编程语言表示的正则表达式里将需要4个反斜杠"\\\\":前两个和后两个分别用于在编程语言里转义成反斜杠,转换成两个 反斜杠后再在正则表达式里转义成一个反斜杠。Python里的原生字符串很好地解决了这个问题,这个例子中的正则表达式可以使用r"\\"表示。同样,匹 配一个数字的"\\d"可以写成r"\d"。有了原生字符串,你再也不用担心是不是漏写了反斜杠,写出来的表达式也更直观。
1.4. 匹配模式
正则表达式提供了一些可用的匹配模式,比如忽略大小写、多行匹配等,这部分内容将在Pattern类的工厂方法re.compile(pattern[, flags])中一起介绍。
2. re模块
2.1. 开始使用re
Python通过re模块提供对正则表达式的支持。使用re的一般步骤是先将正则表达式的字符串形式编译为Pattern实例,然后使用Pattern实例处理文本并获得匹配结果(一个Match实例),最后使用Match实例获得信息,进行其他的操作。
# encoding: UTF-8import re# 将正则表达式编译成Pattern对象pattern = re.compile(r'hello')# 使用Pattern匹配文本,获得匹配结果,无法匹配时将返回Nonematch = pattern.match('hello world!')if match: # 使用Match获得分组信息 print match.group()### 输出 #### hellore.compile(strPattern[, flag]):
这个方法是Pattern类的工厂方法,用于将字符串形式的正则表达式编译为Pattern对象。 第二个参数flag是匹配模式,取值可以使用按位或运算符'|'表示同时生效,比如re.I | re.M。另外,你也可以在regex字符串中指定模式,比如re.compile('pattern', re.I | re.M)与re.compile('(?im)pattern')是等价的。
可选值有:
- re.I(re.IGNORECASE): 忽略大小写(括号内是完整写法,下同)
- M(MULTILINE): 多行模式,改变'^'和'$'的行为(参见上图)
- S(DOTALL): 点任意匹配模式,改变'.'的行为
- L(LOCALE): 使预定字符类 \w \W \b \B \s \S 取决于当前区域设定
- U(UNICODE): 使预定字符类 \w \W \b \B \s \S \d \D 取决
a=re.compile(r"""\d + # the integral part\. # the decimal point\d * # some fractional digits""", re.X)b=re.compile(r"\d+\.\d*")于unicode定义的字符属性
- X(VERBOSE): 详细模式。这个模式下正则表达式可以是多行,忽略空白字符,并可以加入注释。以下两个正则表达式是等价的:
re提供了众多模块方法用于完成正则表达式的功能。这些方法可以使用Pattern实例的相应方法替代,唯一的好处是少写一行re.compile()代 码,但同时也无法复用编译后的Pattern对象。这些方法将在Pattern类的实例方法部分一起介绍。如上面这个例子可以简写为:
m = re.match(r'hello', 'hello world!')print m.group()2.2. Match
Match对象是一次匹配的结果,包含了很多关于此次匹配的信息,可以使用Match提供的可读属性或方法来获取这些信息。
属性:
- string: 匹配时使用的文本。
- re: 匹配时使用的Pattern对象。
- pos: 文本中正则表达式开始搜索的索引。值与Pattern.match()和Pattern.seach()方法的同名参数相同。
- endpos: 文本中正则表达式结束搜索的索引。值与Pattern.match()和Pattern.seach()方法的同名参数相同。
- lastindex: 最后一个被捕获的分组在文本中的索引。如果没有被捕获的分组,将为None。
- lastgroup: 最后一个被捕获的分组的别名。如果这个分组没有别名或者没有被捕获的分组,将为None。
方法:
- group([group1, …]):
获得一个或多个分组截获的字符串;指定多个参数时将以元组形式返回。group1可以使用编号也可以使用别名;编号0代表整个匹配的子串;不填写参数时,返回group(0);没有截获字符串的组返回None;截获了多次的组返回最后一次截获的子串。 - groups([default]):
以元组形式返回全部分组截获的字符串。相当于调用group(1,2,…last)。default表示没有截获字符串的组以这个值替代,默认为None。
- groupdict([default]):
返回以有别名的组的别名为键、以该组截获的子串为值的字典,没有别名的组不包含在内。default含义同上。 - start([group]):
返回指定的组截获的子串在string中的起始索引(子串第一个字符的索引)。group默认值为0。
- end([group]):
返回指定的组截获的子串在string中的结束索引(子串最后一个字符的索引+1)。group默认值为0。 - span([group]):
返回(start(group), end(group))。 - expand(template):
将匹配到的分组代入template中然后返回。template中可以使用\id或\g<id>、
\g<name>引用分组,但不能使用编号0。\id与\g<id>是等价的;但\10将被认为是第10个分组,如果你想表达
\1之后是字符'0',只能使用\g<1>0。
import rem = re.match(r'(\w+) (\w+)(?P<sign>.*)', 'hello world!')print "m.string:", m.stringprint "m.re:", m.reprint "m.pos:", m.posprint "m.endpos:", m.endposprint "m.lastindex:", m.lastindexprint "m.lastgroup:", m.lastgroupprint "m.group(1,2):", m.group(1, 2)print "m.groups():", m.groups()print "m.groupdict():", m.groupdict()print "m.start(2):", m.start(2)print "m.end(2):", m.end(2)print "m.span(2):", m.span(2)print r"m.expand(r'\2 \1\3'):", m.expand(r'\2 \1\3')### output #### m.string: hello world!# m.re: <_sre.SRE_Pattern object at 0x016E1A38># m.pos: 0# m.endpos: 12# m.lastindex: 3# m.lastgroup: sign# m.group(1,2): ('hello', 'world')# m.groups(): ('hello', 'world', '!')# m.groupdict(): {'sign': '!'}# m.start(2): 6# m.end(2): 11# m.span(2): (6, 11)# m.expand(r'\2 \1\3'): world hello!2.3. Pattern
Pattern对象是一个编译好的正则表达式,通过Pattern提供的一系列方法可以对文本进行匹配查找。
Pattern不能直接实例化,必须使用re.compile()进行构造。
Pattern提供了几个可读属性用于获取表达式的相关信息:
- pattern: 编译时用的表达式字符串。
- flags: 编译时用的匹配模式。数字形式。
- groups: 表达式中分组的数量。
- groupindex: 以表达式中有别名的组的别名为键、以该组对应的编号为值的字典,没有别名的组不包含在内。
import rep = re.compile(r'(\w+) (\w+)(?P<sign>.*)', re.DOTALL)print "p.pattern:", p.patternprint "p.flags:", p.flagsprint "p.groups:", p.groupsprint "p.groupindex:", p.groupindex### output #### p.pattern: (\w+) (\w+)(?P<sign>.*)# p.flags: 16# p.groups: 3# p.groupindex: {'sign': 3}实例方法[ | re模块方法]:
- match(string[, pos[, endpos]]) | re.match(pattern, string[, flags]):
这个方法将从string的pos下标处起尝试匹配pattern;如果pattern结束时仍可匹配,则返回一个Match对象;如果匹配过程中pattern无法匹配,或者匹配未结束就已到达endpos,则返回None。pos和endpos的默认值分别为0和len(string);re.match()无法指定这两个参数,参数flags用于编译pattern时指定匹配模式。
注意:这个方法并不是完全匹配。当pattern结束时若string还有剩余字符,仍然视为成功。想要完全匹配,可以在表达式末尾加上边界匹配符'$'。
示例参见2.1小节。
- search(string[, pos[, endpos]]) | re.search(pattern, string[, flags]):
这个方法用于查找字符串中可以匹配成功的子串。从string的pos下标处起尝试匹配pattern,如果pattern结束时仍可匹配,则返回一个Match对象;若无法匹配,则将pos加1后重新尝试匹配;直到pos=endpos时仍无法匹配则返回None。pos和endpos的默认值分别为0和len(string));re.search()无法指定这两个参数,参数flags用于编译pattern时指定匹配模式。
# encoding: UTF-8 import re # 将正则表达式编译成Pattern对象 pattern = re.compile(r'world') # 使用search()查找匹配的子串,不存在能匹配的子串时将返回None # 这个例子中使用match()无法成功匹配 match = pattern.search('hello world!') if match: # 使用Match获得分组信息 print match.group() ### 输出 ### # worldpython regrex的更多相关文章
- 利用python进行数据分析之数据规整化
数据分析和建模大部分时间都用在数据准备上,数据的准备过程包括:加载,清理,转换与重塑. 合并数据集 pandas对象中的数据可以通过一些内置方法来进行合并: pandas.merge可根据一个或多个键 ...
- Python中的多进程与多线程(一)
一.背景 最近在Azkaban的测试工作中,需要在测试环境下模拟线上的调度场景进行稳定性测试.故而重操python旧业,通过python编写脚本来构造类似线上的调度场景.在脚本编写过程中,碰到这样一个 ...
- Python高手之路【六】python基础之字符串格式化
Python的字符串格式化有两种方式: 百分号方式.format方式 百分号的方式相对来说比较老,而format方式则是比较先进的方式,企图替换古老的方式,目前两者并存.[PEP-3101] This ...
- Python 小而美的函数
python提供了一些有趣且实用的函数,如any all zip,这些函数能够大幅简化我们得代码,可以更优雅的处理可迭代的对象,同时使用的时候也得注意一些情况 any any(iterable) ...
- JavaScript之父Brendan Eich,Clojure 创建者Rich Hickey,Python创建者Van Rossum等编程大牛对程序员的职业建议
软件开发是现时很火的职业.据美国劳动局发布的一项统计数据显示,从2014年至2024年,美国就业市场对开发人员的需求量将增长17%,而这个增长率比起所有职业的平均需求量高出了7%.很多人年轻人会选择编 ...
- 可爱的豆子——使用Beans思想让Python代码更易维护
title: 可爱的豆子--使用Beans思想让Python代码更易维护 toc: false comments: true date: 2016-06-19 21:43:33 tags: [Pyth ...
- 使用Python保存屏幕截图(不使用PIL)
起因 在极客学院讲授<使用Python编写远程控制程序>的课程中,涉及到查看被控制电脑屏幕截图的功能. 如果使用PIL,这个需求只需要三行代码: from PIL import Image ...
- Python编码记录
字节流和字符串 当使用Python定义一个字符串时,实际会存储一个字节串: "abc"--[97][98][99] python2.x默认会把所有的字符串当做ASCII码来对待,但 ...
- Apache执行Python脚本
由于经常需要到服务器上执行些命令,有些命令懒得敲,就准备写点脚本直接浏览器调用就好了,比如这样: 因为线上有现成的Apache,就直接放它里面了,当然访问安全要设置,我似乎别的随笔里写了安全问题,这里 ...
随机推荐
- js的原型链和constructor
转载:http://www.108js.com/article/article1/10201.html?id=1092 请先瞻仰上边的这篇文章. 对象的原型链: box.__proto__.__pro ...
- 数据结构——动态链表(C++)
定义一个节点: [cpp] view plain copy print? #include <iostream> using namespace std; typedef int T; ...
- CMY/CMYK 打印机色彩
CMY 发光物体和反光物体产生颜色的机制不同. 前者指光源光, 它的颜色由发光波长决定. 后者指不能发光但却能表现出颜色的物体, 例如色素. 色素的颜色由它不能吸收的光的波长决定. 比如红色色素, 除 ...
- 唯一分解定理 poj 1365
一行代表一个数 x 给你底数和指数 求x-1的唯一分解定理的底数和指数 从大到小输出 #include<stdio.h> #include<string.h> #include ...
- hibernate DetachedCriteria实现多表关联查询createAlias的使用
记录本例查询初衷: 有表: 表1,表2,表3 关系 1 many-to-one 2 2 many-to-one 3 结果:要通过表3中的条件反向查询表1中相关的数据 public Page<We ...
- Spring-程序中获取注册bean的方式
获得spring里注册Bean的四种方法,特别是第三种方法,简单: 一:方法一(多在struts框架中)继承BaseDispatchAction import com.mas.wawacommuni ...
- HTTP协议学习---(九)cookie
Cookie是HTTP协议中非常重要的东西, 之前拜读了Fish Li 写的[细说Cookie], 让我学到了很多东西.Fish的这篇文章写得太经典了. 所以我这篇文章就没有太多内容了. 最近我打算写 ...
- java中i=i++字节码分析
原文出处: Ticmy 1 2 int i = 0; i = i++; 结果还是0为什么? 程序的执行顺序是这样的:因为++在后面,所以先使用i,"使用"的含义就是i++这个表达式 ...
- VS2015 安装mvc4安装包以及vs2010 sp1后导致Razor语法失效代码不高亮(能正常运行)/视图页面无法智能提示(.cshtml)解决办法
VS2015默认asp.net mvc 版本为5.0以上,默认不支持创建5.0以下的版本.所以想要使用mvc 4.0只能单独安装.在网上搜了几篇教程后在微软官网下载了Visual Studio 201 ...
- OPENGL——背面剔除
Opengl 表面剔除是提高 Opengl 程序渲染效率的一个有效途径. 我们知道,OpenGL 渲染的基本单位是一个个的三角形面片.无论多么复杂的3D 模 型都是由一个个基本的三角型的面片组成的. ...