
Hadoop概念学习系列之Java调用Shell命令和脚本,致力于hadoop/spark集群(三十六)
前言
说明的是,本博文,是在以下的博文基础上,立足于它们,致力于我的大数据领域!
http://kongcodecenter.iteye.com/blog/1231177
http://blog.csdn.net/u010376788/article/details/51337312
http://blog.csdn.net/arkblue/article/details/7897396
第一种:普通做法
首先,编号写WordCount.scala程序。
然后,打成jar包,命名为WC.jar。比如,我这里,是导出到windows桌面。
其次,上传到linux的桌面,再移动到hdfs的/目录。
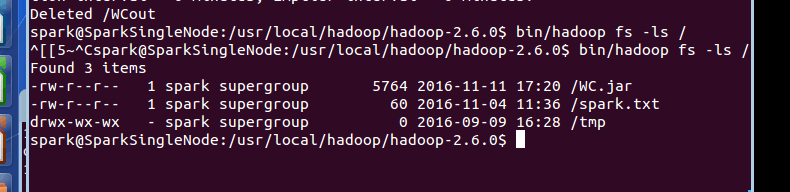
最后,在spark安装目录的bin下,执行
spark-submit \
> --class cn.spark.study.core.WordCount \
> --master local[1] \
> /home/spark/Desktop/WC.jar \
> hdfs://SparkSingleNode:9000/spark.txt \
> hdfs://SparkSingleNode:9000/WCout

第二种:高级做法
有时候我们在Linux中运行Java程序时,需要调用一些Shell命令和脚本。而Runtime.getRuntime().exec()方法给我们提供了这个功能,而且Runtime.getRuntime()给我们提供了以下几种exec()方法:
不多说,直接进入。
步骤一: 为了规范起见,命名为JavaShellUtil.java。在本地里写好
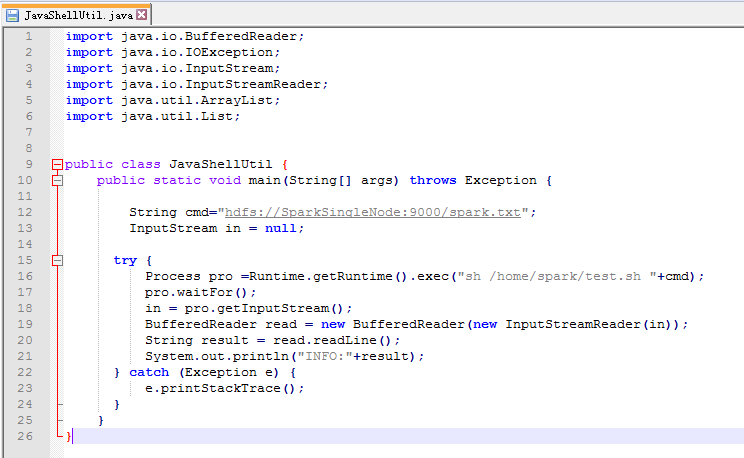
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStream;
import java.io.InputStreamReader;
import java.util.ArrayList;
import java.util.List;
public class JavaShellUtil {
public static void main(String[] args) throws Exception {
String cmd="hdfs://SparkSingleNode:9000/spark.txt";
InputStream in = null;
try {
Process pro =Runtime.getRuntime().exec("sh /home/spark/test.sh "+cmd);
pro.waitFor();
in = pro.getInputStream();
BufferedReader read = new BufferedReader(new InputStreamReader(in));
String result = read.readLine();
System.out.println("INFO:"+result);
} catch (Exception e) {
e.printStackTrace();
}
}
}
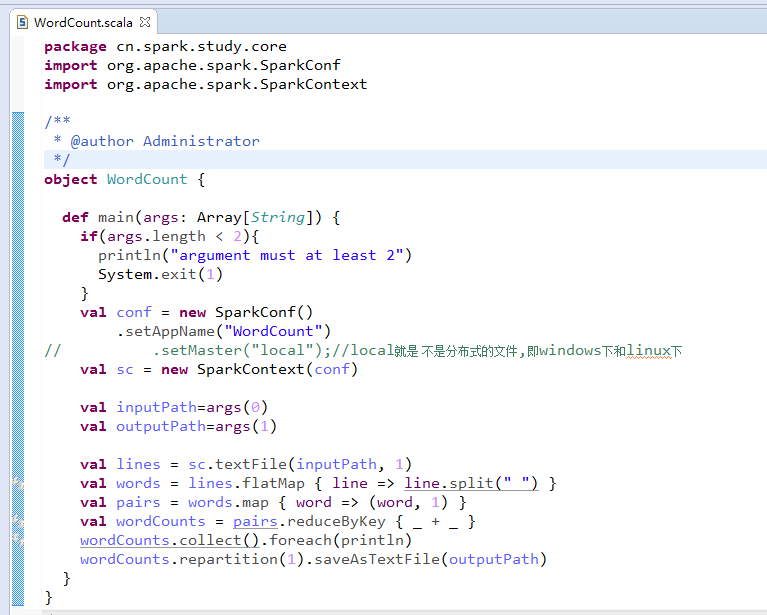
package cn.spark.study.core
import org.apache.spark.SparkConf
import org.apache.spark.SparkContext
/**
* @author Administrator
*/
object WordCount {
def main(args: Array[String]) {
if(args.length < 2){
println("argument must at least 2")
System.exit(1)
}
val conf = new SparkConf()
.setAppName("WordCount")
// .setMaster("local");//local就是 不是分布式的文件,即windows下和linux下
val sc = new SparkContext(conf)
val inputPath=args(0)
val outputPath=args(1)
val lines = sc.textFile(inputPath, 1)
val words = lines.flatMap { line => line.split(" ") }
val pairs = words.map { word => (word, 1) }
val wordCounts = pairs.reduceByKey { _ + _ }
wordCounts.collect().foreach(println)
wordCounts.repartition(1).saveAsTextFile(outputPath)
}
}
步骤二:编写好test.sh脚本

spark@SparkSingleNode:~$ cat test.sh
#!/bin/sh
/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin/spark-submit \
--class cn.spark.study.core.WordCount \
--master local[1] \
/home/spark/Desktop/WC.jar \
$1 hdfs://SparkSingleNode:9000/WCout
步骤三:上传JavaShellUtil.java,和打包好的WC.jar
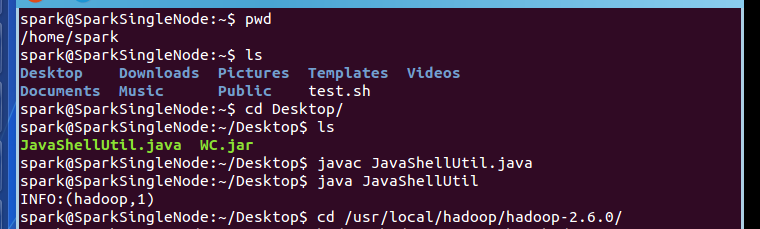
spark@SparkSingleNode:~$ pwd
/home/spark
spark@SparkSingleNode:~$ ls
Desktop Downloads Pictures Templates Videos
Documents Music Public test.sh
spark@SparkSingleNode:~$ cd Desktop/
spark@SparkSingleNode:~/Desktop$ ls
JavaShellUtil.java WC.jar
spark@SparkSingleNode:~/Desktop$ javac JavaShellUtil.java
spark@SparkSingleNode:~/Desktop$ java JavaShellUtil
INFO:(hadoop,1)
spark@SparkSingleNode:~/Desktop$ cd /usr/local/hadoop/hadoop-2.6.0/
步骤四:查看输出结果
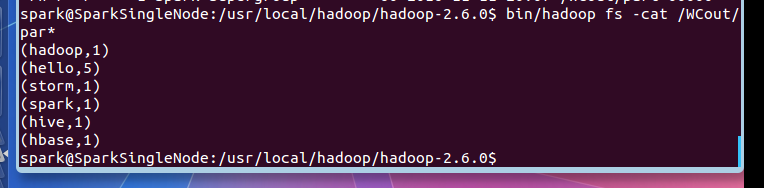
spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ bin/hadoop fs -cat /WCout/par*
(hadoop,1)
(hello,5)
(storm,1)
(spark,1)
(hive,1)
(hbase,1)
spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$
成功!
关于
Shell 传递参数
见
http://www.runoob.com/linux/linux-shell-passing-arguments.html
最后说的是,不局限于此,可以穿插在以后我们生产业务里的。作为调用它即可,非常实用!
Hadoop概念学习系列之Java调用Shell命令和脚本,致力于hadoop/spark集群(三十六)的更多相关文章
- java基础/java调用shell命令和脚本
一.项目需求: 从某一机构获取证书,证书机构提供小工具,执行.sh脚本即可启动服务,本地调用该服务即可获取证书. 问题:linux服务器启动该服务,不能关闭.一旦关闭,服务即停止. 解决方案:java ...
- java调用shell命令及脚本
shell脚本在处理文本及管理操作系统时强大且简单,将shell脚本结合到应用程序中则是一种快速实现的不错途径本文介绍使用java代码调用并执行shell 我在 -/bin/ 目录下写了jbossLo ...
- shell 脚本实战笔记(10)--spark集群脚本片段念念碎
前言: 通过对spark集群脚本的研读, 对一些重要的shell脚本技巧, 做下笔记. *). 取当前脚本的目录 sbin=`dirname "$0"` sbin=`cd &quo ...
- Java 调用 Shell 命令
近日项目中有这样一个需求:系统中的外币资金调度完成以后,要将调度信息生成一个Txt文件,然后将这个Txt文件发送到另外一个系统(Kondor)中.生成文件自然使用OutputStreamWirter了 ...
- Hadoop Hive概念学习系列之hive里的扩展接口(CLI、Beeline、JDBC)(十六)
<Spark最佳实战 陈欢>写的这本书,关于此知识点,非常好,在94页. hive里的扩展接口,主要包括CLI(控制命令行接口).Beeline和JDBC等方式访问Hive. CLI和B ...
- java 调用shell命令
原文:http://kongcodecenter.iteye.com/blog/1231177 Java通过SSH2协议执行远程Shell脚本(ganymed-ssh2-build210.jar) ...
- java 执行shell命令遇到的坑
正常来说java调用shell命令就是用 String[] cmdAry = new String[]{"/bin/bash","-c",cmd} Runtim ...
- Hadoop概念学习系列之Hadoop新手学习指导之入门需知(二十)
不多说,直接上干货! 零基础学习hadoop,没有想象的那么困难,也没有想象的那么容易.从一开始什么都不懂,到能够搭建集群,开发.整个过程,只要有Linux基础,虚拟机化和java基础,其实hadoo ...
- [转载]JAVA调用Shell脚本
FROM:http://blog.csdn.net/jj12345jj198999/article/details/11891701 在实际项目中,JAVA有时候需要调用C写出来的东西,除了JNI以外 ...
随机推荐
- XXS level2
(1)用level1的方法尝试,发现行不通 (2)查看PHP源代码 <?php ini_set("display_errors", 0); $str = $_GET[&quo ...
- meta viewport的原理
https://blog.csdn.net/zhouziyu2011/article/details/60570547
- IIS下使用 HTTP/2
IIS 使用 HTTP/2 什么叫HTTP/2? HTTP 2.0即超文本传输协议 2.0,是下一代HTTP协议.是由互联网工程任务组(IETF)的Hypertext Transfer Protoco ...
- php基础-2
php的逻辑运算 &&符号 <?php function tarcrnum() { for ($i = 0; $i <= 100; $i++) { if ($i % 2 = ...
- SVN三种合并类型
https://blog.csdn.net/zht666/article/details/36178117 转自:http://wenku.baidu.com/link?url=pnALYESJnX0 ...
- 使用 Prometheus 监控minio 性能指标信息&&docker-compose 方式运行
minio server 已经支持Prometheus 了,对于系统的运行参数我们可以方便.实时的查看 运行使用docker-compose docker-compose 文件 version: &q ...
- S老师 Top-Down RPG Starter Kit 学习
character creation using UnityEngine; using System.Collections; public class CharacterCreation : Mon ...
- [转]SQL UNION 和 UNION ALL 操作符
SQL UNION 操作符 UNION 操作符用于合并两个或多个 SELECT 语句的结果集. 请注意,UNION 内部的 SELECT 语句必须拥有相同数量的列.列也必须拥有相似的数据类型.同时,每 ...
- uglifyjs-webpack-plugin 插件,drop_console 默认为 false(不清除 console 语句),drop_debugger 默认为 true(清除 debugger 语句)
uglifyjs-webpack-plugin 插件,drop_console 默认为 false(不清除console语句),drop_debugger 默认为 true(清除 debugger 语 ...
- apache HTML5 History 模式 配置
说明 使用的 Apache/2.4.6 版本. 文档这么写的: 但是 没说 IfModule 放在哪里 . httpd.conf 里面有大量的 IfModule . 这样的.但是实测 无效.无 ...