
kmp算法散记
1.
https://blog.csdn.net/abcjennifer/article/details/5794547
#include<bits/stdc++.h>

using namespace std;

char t[],p[];    //文本串t,模式串p

int next[];

//记录当前索引位置的前一个字符的相同前缀后缀的最长长度。

void getnext()//打表离线计算模式串p

{

    int len=strlen(p);

}

int KMP(char t[],char p[])

//统计模式串p在文本串s出现次数(允许重叠)

//文本串t,模式串p

{

    int ans=;        //统计值

    int i;            //在文本串s上移动进位的索引“指针”

    int n=strlen(t);//文本串t的长度

    int m=strlen(p);//模式串p的长度

    if(n== && m==)

    {

        if(t[]==p[]) return ;

        else return ;

    }

    getnext(p);        //获得模式串p的next数组

    int q=;        //在模式串q上移动进位的索引“指针”

    for(i=;i<n;i++)

    {

        while(q> && p[q]!=t[i]) q=next[q];

        if(p[q]==t[i]) q++;

        //某一位的字符匹配成功,继续匹配下一位

        if(q==m)//模式串在文本串中匹配成功

        {

            ans++;

            q=next[q];

        }

        //q总是被赋值给next[q]的,这是一种优化

    }

    return ans;

}

int main()

{

    int T;

    scanf("%d",&T);

    getchar();// 熟稔之!

    while(T--)

    {

        scanf("%s%s",p,t);

        printf("%d\n",KMP(t,p));

    }

    return ;

}
2.
在重述 kmp算法的原理之前,BF 算法是绕不开的话题,也只有了解了BF算法,才能知道KMP算法的优势。
BF算法的原理是一位一位地比较,比较到失配位的时候,将(模式串)P串 向后移动一个单位,再从头一位一位地进行匹配。
int ViolentMatch(char* s,char* p)//文本串s,模式串p

{

	int slen=strlen(s);//文本串长度slen

	int plen=strlen(p);//模式串长度plen

	int i=0;

	int j=0;

	while(i<slen && j<plen)//匹配过程

	{

		if(s[i]==p[j])

		{

			i++;

			j++;

		}

		else

		{

			i=i-j+1;

			j=0;

		}

		//每次匹配失败时,i回溯,j被置为0.

	}

	if(j==plen) return i-j;

	//匹配成功,返回模式串p在文本串s中的位置,否则返回-1

	else 		return  -1;

}
3.
Knuth-Morris-Pratt 字符串查找算法,简称为 “KMP算法”,常用于在一个文本串S内查找一个模式串P 的出现位置,这个算法由Donald Knuth、Vaughan Pratt、James H. Morris三人于1977年联合发表,故取这3人的姓氏命名此算法。
next 数组各值的含义:代表当前字符之前的字符串中,有多大长度的相同前缀后缀。例如如果next [j] = k,代表j 之前的字符串中有最大长度为k 的相同前缀后缀。
在某个字符失配时,该字符对应的next 值会告诉你下一步匹配中,模式串P应该跳到哪个位置(跳到next [j] 的位置)。
如果next [j] 等于0或-1,则跳到模式串的开头字符;
若next [j] = k 且 k > 0,代表下次匹配跳到j 之前的某个字符,而不是跳到开头,且具体跳过了k 个字符。
int KmpSearch(char* s,char* p)//文本串s,模式串p

{

	int slen=strlen(s);//文本串s的长度 slen

	int plen=strlen(p);//模式串p的长度plen

	int i=0;		   //文本串p的指针

	int j=0; 		   //模式串s的指针

	while(i<slen && j<plen)	//匹配ing...

	{

		if(j==-1 || s[i]==p[j])

		{

			i++;

			j++;

		}

		else j=next[j];

	}

	if(j==plen) return i-j;

	else 		return -1;

}
4.
寻找前缀后缀最长公共元素长度
对于P = p0 p1 ...pj-1 pj,寻找模式串P中长度最大且相等的前缀和后缀。
如果存在p0 p1 ...pk-1 pk = pj- k pj-k+1...pj-1 pj,那么在包含pj的模式串中有最大长度为k+1的相同前缀后缀。
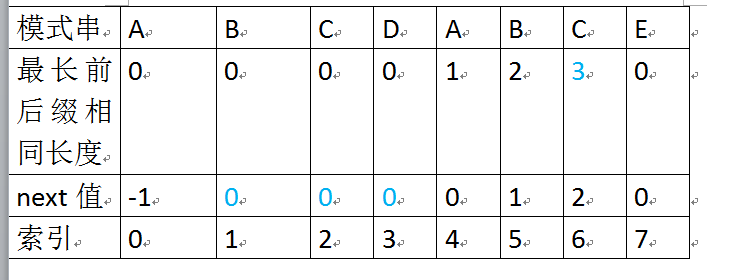
举个例子,如果给定的模式串为“abab”,那么它的各个子串的前缀后缀的公共元素的最大长度如下表格所示:
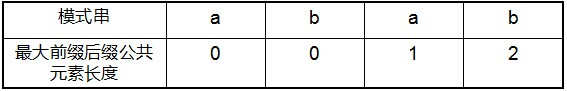
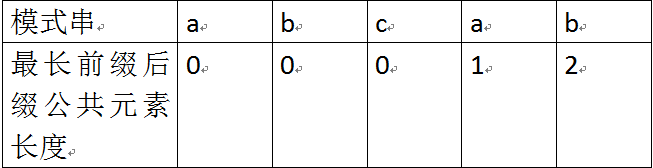
比如对于字符串aba来说,它有长度为1的相同前缀后缀a;而对于字符串abab来说,它有长度为2的相同前缀后缀ab。
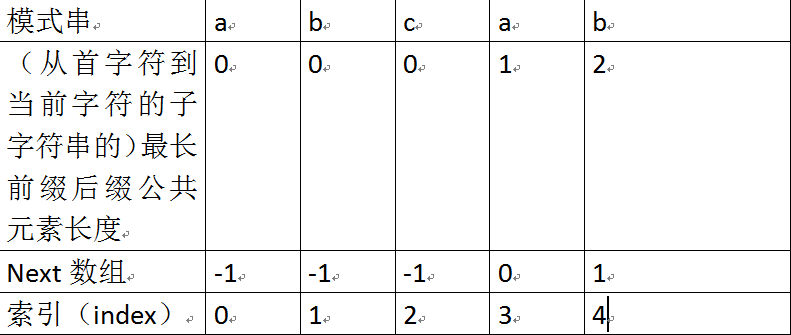
next 数组考虑的是除当前字符外的也就是当前字符前的字符串的最长相同前缀后缀的长度,所以通过第1步骤求得各个子字符串的前缀后缀的公共元素的最大长度后,
只要稍作变形即可:将第一步骤中求得的值整体右移一位(-=1),然后初值赋为-1,如下表格所示:

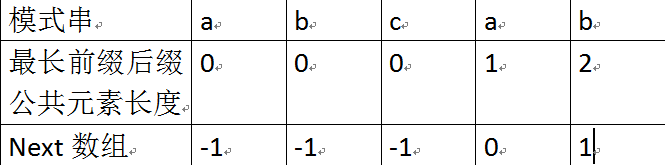
比如对于aba来说,第3个字符a之前的字符串ab中有长度为0的相同前缀后缀,所以第3个字符a对应的next值为0;
而对于abab来说,第4个字符b之前的字符串aba中有长度为1的相同前缀后缀a,所以第4个字符b对应的next值为1。
根据next数组进行匹配
匹配失配,j = next [j],模式串向右移动(+=)的位数为:j - next[j]。

5.
接下来,咱们来写代码求下next 数组。
基于之前的理解,可知计算next 数组的方法可以采用递推:
如果对于值k,已有p0 p1, ..., pk-1 = pj-k pj-k+1, ..., pj-1,相当于next[j] = k。
此意味着什么呢?究其本质,next[j] = k 代表模式串P在index==j处的字符p[j] 之前的模式串子串中,有长度为k 的相同前缀和后缀。
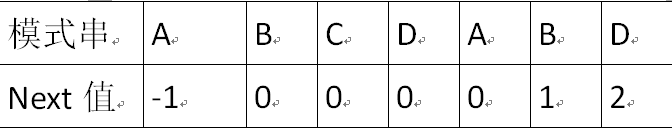
举个例子,如下图,根据模式串“ABCDABD”的next 数组可知失配位置的字符D对应的next 值为2,
代表字符D前有长度为2的相同前缀和后缀(这个相同的前缀后缀即为“AB”),失配后,模式串需要向右移动j - next [j] = 6 - 2 =4位。(光需要移动模式串P就好啦!)
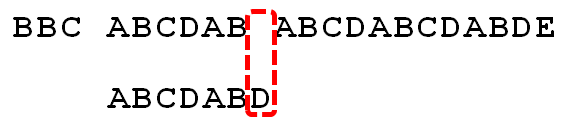
向右移动4位后,模式串中的字符C继续跟文本串匹配。
下面的问题是:已知next [0, ..., j],如何求出next [j + 1]呢?(如何由已知追求未知啦嘞!)
next [j] = k(相当于 “p0...pk-1” == “pj-k...pj-1” )
对于P的前j+1个序列字符:
6.
a beautiful picture: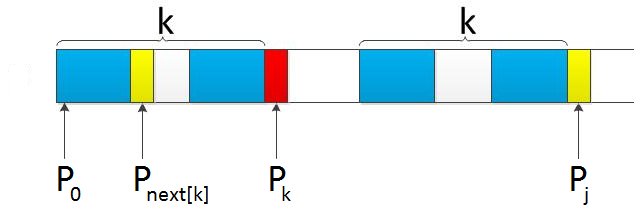
可以通过递推求得next 数组,代码如下所示:
7.
KMP算法的匹配流程:
假设现在文本串S匹配到 i 位置,模式串P匹配到 j 位置:
如果(1). j = -1,or (2).当前字符匹配成功(即S[i] == P[j]):都令i++,j++,继续匹配(match)下一个字符;
如果j != -1,且当前字符匹配失败(即S[i] != P[j]),则令 i 不变,j = next[j]。此举意味着失配时,模式串P相对于文本串S向右移动了j - next [j] 位。
(1). 最开始匹配时
P[0]跟S[0]匹配失败,
所以执行“如果j != -1,且当前字符匹配失败(即S[i] != P[j]),则令 i 不变,j = next[j]”,所以j = -1,
故转而执行“如果j = -1,或者当前字符匹配成功(即S[i] == P[j]),都令i++,j++”,
得到i = 1,j = 0,即P[0]继续跟S[1]匹配。
P[0]跟S[1]又失配,j再次等于-1,i、j继续自增,从而P[0]跟S[2]匹配。
P[0]跟S[2]失配后,P[0]又跟S[3]匹配。,直到P[0]跟S[4]匹配成功,开始执行此条指令的后半段:
如果j = -1,或者当前字符匹配成功(即S[i] == P[j]),都令i++,j++:
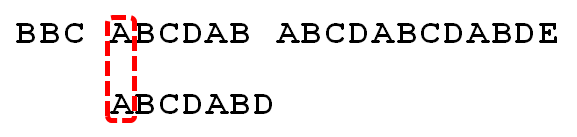
(2).
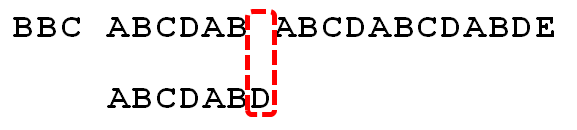
P[1]跟S[5]匹配成功,P[2]跟S[6]也匹配成功, ...,直到当匹配到P[6]处的字符D时失配(即S[10] != P[6]),由于P[6]处的D对应的next 值为2,
所以下一步用P[2]处的字符C继续跟S[10]匹配,相当于向右移动:j - next[j] = 6 - 2 =4 位。
(3).
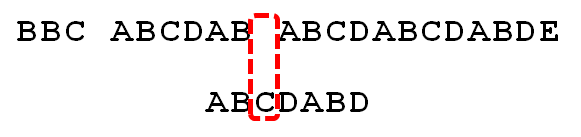
向右移动4位后,P[2]处的C再次失配,由于C对应的next值为0,所以下一步用P[0]处的字符继续跟S[10]匹配,相当于向右移动:j - next[j] = 2 - 0 = 2 位。
(4).
移动两位之后,A 跟空格不匹配,模式串后移1 位。

(5).
P[6]处的D再次失配,因为P[6]对应的next值为2,故下一步用P[2]继续跟文本串匹配,相当于模式串向右移动 j - next[j] = 6 - 2 = 4 位。
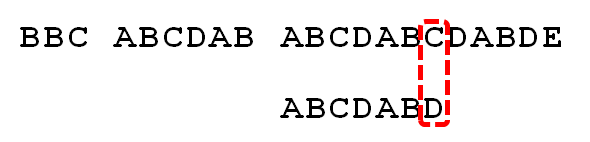
(6).
匹配成功,过程结束。
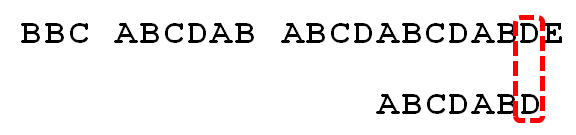
当p[j] != s[i] 时,下次匹配必然是p[ next [j]] 跟s[i]匹配,如果p[j] = p[ next[j] ],必然导致后一步匹配失败
(因为p[j]已经跟s[i]失配,然后你还用跟p[j]等同的值p[next[j]]去跟s[i]匹配,很显然,必然失配),所以不能允许p[j] = p[ next[j ]]。如果出现了p[j] = p[ next[j] ]咋办呢?
如果出现了,则需要再次递归,即令next[j] = next[ next[j] ]。
求next 数组的代码:
//求next数组的代码:

void GetNextval(char* p,int next[])

{

	int plen=strlen(p);

	next[0]=-1;

	int k=-1;//p[k]表示前缀

	int j=0;//p[j]表示后缀

	while(j<plen-1)//字符串p本身既不是其前缀也非其后缀.

	{

		if(k==-1 || p[k]==p[j])

		{

			k++;

			j++;

//Condition:k==-1 && p[j]!=p[k]

			if(p[j]!=p[k]) next[j]=k;

//Condition: p[j]==p[k]

			else 		   next[j]=next[k];

		}

		else k=next[k];

	}

}

int KmpSearch(char* s,char* p)

{

	int slen=strlen(s);

	int plen=strlen(p);

	int i=0;

	int j=0;

	while(i<len && j<len)

	{

		if(j==-1||s[i]==p[j])

		{

			i++;

			j++;

		}

		else

		{

			j=next[j];

		}

	}

	if(j=plen) return i-j;

	else 	   return -1;

}
kmp算法散记的更多相关文章
- 简单有效的kmp算法
以前看过kmp算法,当时接触后总感觉好深奥啊,抱着数据结构的数啃了一中午,最终才大致看懂,后来提起kmp也只剩下“奥,它是做模式匹配的”这点干货.最近有空,翻出来算法导论看看,原来就是这么简单(先不说 ...
- KMP算法
KMP算法是字符串模式匹配当中最经典的算法,原来大二学数据结构的有讲,但是当时只是记住了原理,但不知道代码实现,今天终于是完成了KMP的代码实现.原理KMP的原理其实很简单,给定一个字符串和一个模式串 ...
- 萌新笔记——用KMP算法与Trie字典树实现屏蔽敏感词(UTF-8编码)
前几天写好了字典,又刚好重温了KMP算法,恰逢遇到朋友吐槽最近被和谐的词越来越多了,于是突发奇想,想要自己实现一下敏感词屏蔽. 基本敏感词的屏蔽说起来很简单,只要把字符串中的敏感词替换成"* ...
- KMP算法实现
链接:http://blog.csdn.net/joylnwang/article/details/6778316 KMP算法是一种很经典的字符串匹配算法,链接中的讲解已经是很明确得了,自己按照其讲解 ...
- 数据结构与算法JavaScript (五) 串(经典KMP算法)
KMP算法和BM算法 KMP是前缀匹配和BM后缀匹配的经典算法,看得出来前缀匹配和后缀匹配的区别就仅仅在于比较的顺序不同 前缀匹配是指:模式串和母串的比较从左到右,模式串的移动也是从 左到右 后缀匹配 ...
- 扩展KMP算法
一 问题定义 给定母串S和子串T,定义n为母串S的长度,m为子串T的长度,suffix[i]为第i个字符开始的母串S的后缀子串,extend[i]为suffix[i]与字串T的最长公共前缀长度.求出所 ...
- 字符串模式匹配之KMP算法图解与 next 数组原理和实现方案
之前说到,朴素的匹配,每趟比较,都要回溯主串的指针,费事.则 KMP 就是对朴素匹配的一种改进.正好复习一下. KMP 算法其改进思想在于: 每当一趟匹配过程中出现字符比较不相等时,不需要回溯主串的 ...
- 算法:KMP算法
算法:KMP排序 算法分析 KMP算法是一种快速的模式匹配算法.KMP是三位大师:D.E.Knuth.J.H.Morris和V.R.Pratt同时发现的,所以取首字母组成KMP. 少部分图片来自孤~影 ...
- BF算法与KMP算法
BF(Brute Force)算法是普通的模式匹配算法,BF算法的思想就是将目标串S的第一个字符与模式串T的第一个字符进行匹配,若相等,则继续比较S的第二个字符和 T的第二个字符:若不相等,则比较S的 ...
随机推荐
- Linux 文件(持续更新)
一.文件类型 Linux操作系统把所有内容(文件.图片.视频.设备)都当作文件看待.处理,即一切皆文件. Linux系统把所有文件分为七种类型: 文件类型 文件类型标识 说明 使用ls -l命令查看文 ...
- 浅谈python的第三方库——pandas(一)
pandas作为python进行数据分析的常用第三方库,它是基于numpy创建的,使得运用numpy的程序也能更好地使用pandas. 1 pandas数据结构 1.1 Series 注:由于pand ...
- PTA 学生成绩链表处理(C语言)
本题要求实现两个函数,一个将输入的学生成绩组织成单向链表:另一个将成绩低于某分数线的学生结点从链表中删除. 函数接口定义: struct stud_node *createlist(); struct ...
- 三维偏序[cdq分治学习笔记]
三维偏序 就是让第一维有序 然后归并+树状数组求两维 cdq+cdq不会 告辞 #include <bits/stdc++.h> // #define int long long #def ...
- 使用pip安装Python库超时解决办法
如果在国内安装Python库,强烈推荐使用豆瓣的源http://pypi.douban.com/simple/ 可以这样使用 pip install -i http://pypi.douban.com ...
- PHP0006:PHP基础--函数2
如果php后面没有任何html代码就可以 删掉后面的 ?> 符号 file_put_content 是覆盖写入文件信息
- HashMap (JDK1.8) 分析
一.HashMap(JDK1.8) 1.基本知识.数据结构 (1)时间复杂度:用来衡量算法的运行时间. 参考:https://blog.csdn.net/qq_41523096/article/det ...
- 白面系列 docker
在讲docker之前,首先区分2个概念,容器和虚拟机. 容器: 虚拟机: 简单来说,容器虚拟化操作系统:虚拟机虚拟化硬件. 容器粒度更小更灵活:虚拟机包含资源更多更大. docker就是用来做容器化的 ...
- ng-模板语法
插值 文本绑定 <p>Message: {{ msg }}</p> <p [innerHTML]="msg"></p> 属性绑定 & ...
- BZOJ 4239: 巴士走读 最短路
显然,我们可以将询问按照规定时间从小到大排序,依次处理. 那么我们显然要求合法的点中从 $n$ 号点出发到达点 $i$ 的最迟时间,我们令这个为 $f[i]$ 而 $f[i]$ 显然可以用最短路来求. ...