
nltk27_NLTK聚类分析
http://www.pythontip.com/blog/post/10044/
Python自然语言处理(三) -- 利用NLTK进行聚类
这篇文章介绍如何利用NLTK进行聚类,和上两篇文章Python自然语言处理(一)、Python自然语言处理(二)不同,聚类不能算作自然语言处理的内容,但可以很容易应用到NLP中,因此将其划分到自然语言处理下。
-------------------进入正题--------------------
nltk内部封装了常用的聚类方法:Kmeans(K均值)、混合高斯聚类以及GAAC(组平均层次聚类)
使用这些聚类方法之前,需要保证已安装pynum,因为他们聚类传入的数据要求是pynum.array类型。
pynum的安装教程网上一大堆,这里不进行介绍。
一、数据准备
下面所有的聚类数据都是用这组:
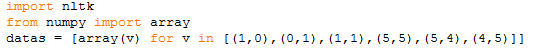
注意:datas的元素是array类型
二、Kmeans聚类
用到的函数:
nltk.cluster.kmeans.KMeansClusterer(num_means, distance )#返回Kmeans聚类器的对象,num_means:目标类别数,distance:自定义距离函数
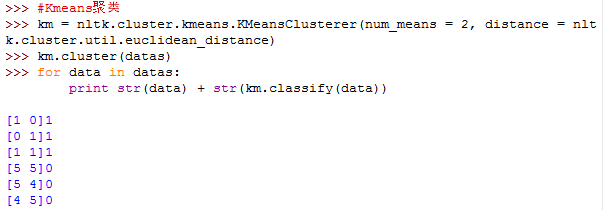
例子中,我们的目标类别数目为2, 距离函数为欧式距离
km.cluster(datas) #对数据集datas进行聚类
km.classify(data)#返回data被分到的类别
三、GAAC聚类
nltk.cluster.gaac.GAAClusterer(num_clusters , normalise )#num_clusters:目标类别数, normalise:是否归一化
这里需要说明一下,GAAC的距离使用的是点积的结果,并不是余弦相似度,如果normalise设置为True,将相似度进行归一化,此时的距离为余弦相似度
GAAC无法自定义相似度
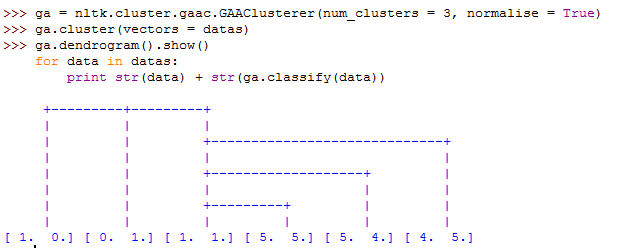
例子中,我们设置目标类别为3,距离需要归一化,也即相似度为余弦相似度。
上述结果可以看出,所分的三个类为{(1,0)}, {(0,1)}, {[ 1, 1.] [ 5, 5.] [ 5 , 4.] [ 4 , 5.]}
结果和Kmeans非常不同,这是因为使用的相似度为余弦相似度
四、混合高斯聚类
用到的函数:
nltk.cluster.em.EMClusterer(initial_means)#initial_means:the means of the gaussian cluster centers

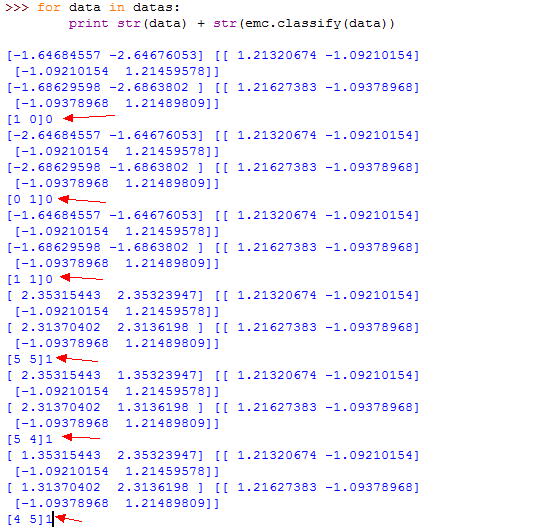
箭头表示聚类的结果,其余数据为中间数据。
nltk27_NLTK聚类分析的更多相关文章
- 地理信息系统 - ArcGIS - 高/低聚类分析工具(High/Low Clustering ---Getis-Ord General G)
前段时间在学习空间统计相关的知识,于是把ArcGIS里Spatial Statistics工具箱里的工具好好研究了一遍,同时也整理了一些笔记上传分享.这一篇先聊一些基础概念,工具介绍篇随后上传. 空间 ...
- SPSS数据分析—聚类分析
多元分析的主要思想之一就是降维,我们已经讲过了很多降维的方法,例如因子分析.主成分分析,多维尺度分析等,还有一种重要的降维方法,就是聚类分析. 聚类分析实质上就是按照距离远近将数据分成若干个类别,使得 ...
- 《BI那点儿事》Microsoft 聚类分析算法——三国人物身份划分
什么是聚类分析? 聚类分析属于探索性的数据分析方法.通常,我们利用聚类分析将看似无序的对象进行分组.归类,以达到更好地理解研究对象的目的.聚类结果要求组内对象相似性较高,组间对象相似性较低.在三国数据 ...
- 《BI那点儿事》Microsoft 顺序分析和聚类分析算法
Microsoft 顺序分析和聚类分析算法是由 Microsoft SQL Server Analysis Services 提供的一种顺序分析算法.您可以使用该算法来研究包含可通过下面的路径或“顺序 ...
- WEKA使用(基础配置+垃圾邮件过滤+聚类分析+关联挖掘)
声明: 1)本文由我bitpeach原创撰写,转载时请注明出处,侵权必究. 2)本小实验工作环境为Windows系统下的WEKA,实验内容主要有三部分,第一是分类挖掘(垃圾邮件过滤),第二是聚类分析, ...
- R语言简单实现聚类分析计算与分析(基于系统聚类法)
聚类分析计算与分析(基于系统聚类法) 下面以一个具体的例子来实现实证分析.2008年我国其中31个省.市和自治区的农村居民家庭平均每人全年消费性支出. 根据原始数据对我国省份进行归类统计. 原始数据如 ...
- R语言简单聚类分析
#以R基础包自带的鸢尾花(Iris)数据进行聚类分析iris data <- iris[,:] #系统聚类法(层次聚类法) distance <- dist(data) #计算距离 iri ...
- Arcgis for JS之Cluster聚类分析的实现(基于区域范围的)
原文:Arcgis for JS之Cluster聚类分析的实现(基于区域范围的) 咱们书接上文,在上文,实现了基于距离的空间聚类的算法实现,在本文,将继续介绍空间聚类之基于区域范围的实现方式,好了,闲 ...
- Arcgis for JS之Cluster聚类分析的实现
原文:Arcgis for JS之Cluster聚类分析的实现 在做项目的时候,碰见了这样一个问题:给地图上标注点对象,数据是从数据库来 的,包含XY坐标信息的,通过graphic和graphicla ...
随机推荐
- MongoDB学习笔记~MongoDBRepository仓储的实现
回到目录 仓储大叔,只要是持久化的东西,都要把它和仓储撤上关系,为啥,为的是开发人员在使用时统一,高可用及方便在各种方式之间实现动态的切换,如ef与redis和mongoDB的切换,你完成可以通过IR ...
- SQL Server 2008 R2——查找最小nIndex,nIndex存在而nIndex+1不存在 求最小连续数组中的最大值
=================================版权声明================================= 版权声明:原创文章 谢绝转载 请通过右侧公告中的“联系邮 ...
- java中设置代理的两种方式
1 前言 有时候我们的程序中要提供可以使用代理访问网络,代理的方式包括http.https.ftp.socks代理.比如在IE浏览器设置代理. 那我们在我们的java程序中使用代理呢,有如下两种方式. ...
- ::before和::after伪元素的用法
一.介绍 css3为了区分伪类和伪元素,伪元素采用双冒号写法. 常见伪类——:hover,:link,:active,:target,:not(),:focus. 常见伪元素——::first-let ...
- mysql添加索引命令
创建脚本 1.PRIMARY KEY(主键索引)mysql>ALTER TABLE `table_name` ADD PRIMARY KEY ( `column` ) 2.UNI ...
- 【Python网络编程】利用Python进行TCP、UDP套接字编程
之前实现了Java版本的TCP和UDP套接字编程的例子,于是决定结合Python的学习做一个Python版本的套接字编程实验. 流程如下: 1.一台客户机从其标准输入(键盘)读入一行字符,并通过其套接 ...
- POJ1236Network of Schools[强连通分量|缩点]
Network of Schools Time Limit: 1000MS Memory Limit: 10000K Total Submissions: 16571 Accepted: 65 ...
- 初学C#和MVC的一些心得,弯路,总结,还有教训(3)--Dapper
经过一番深思熟虑,决定先用Dapper吧..... 以下是我感觉比较有用的一些东西 Dapper项目地址 https://github.com/StackExchange/dapper-dot-ne ...
- windows7配置Nginx+php+mysql教程
windows7配置Nginx+php+mysql教程 最近在学习php,想把自己的学习经历记录下来,并写一些经验,仅供参考交流.此文适合那些刚刚接触php,想要学习并想要自己搭建Nginx+php+ ...
- linux下vi命令大全
进入vi的命令vi filename :打开或新建文件,并将光标置于第一行首vi +n filename :打开文件,并将光标置于第n行首vi + filename :打开文件,并将光标置于最后一行首 ...