
Flume 学习笔记之 Flume NG高可用集群搭建
Flume NG高可用集群搭建:
架构总图:
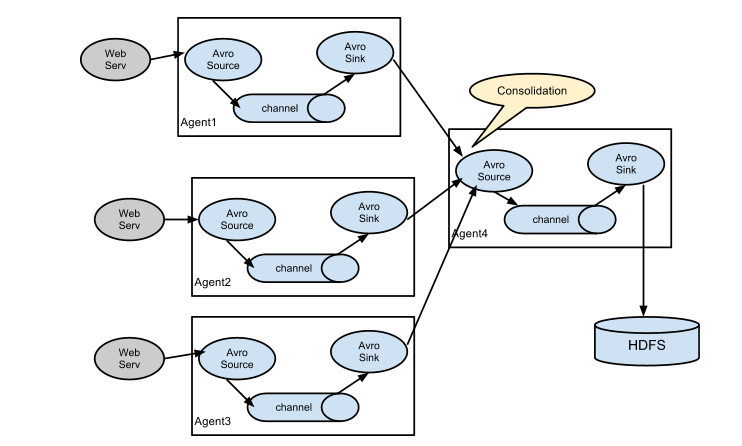
架构分配:
|
角色 |
Host |
端口 |
|
agent1 |
hadoop3 |
52020 |
|
collector1 |
hadoop1 |
52020 |
|
collector2 |
hadoop2 |
52020 |
agent1配置(flume-client.conf):
#agent1 name

agent1.channels = c1

agent1.sources = r1

agent1.sinks = k1 k2

#set gruop

agent1.sinkgroups = g1

#set channel

agent1.channels.c1.type = memory

agent1.channels.c1.capacity = 1000

agent1.channels.c1.transactionCapacity = 100

agent1.sources.r1.channels = c1

agent1.sources.r1.type = exec

agent1.sources.r1.command = tail -F /home/sky/flume/log_exec_tail

agent1.sources.r1.interceptors = i1 i2

agent1.sources.r1.interceptors.i1.type = static

agent1.sources.r1.interceptors.i1.key = Type

agent1.sources.r1.interceptors.i1.value = LOGIN

agent1.sources.r1.interceptors.i2.type = timestamp

# set sink1

agent1.sinks.k1.channel = c1

agent1.sinks.k1.type = avro

agent1.sinks.k1.hostname = hadoop1

agent1.sinks.k1.port = 52020

# set sink2

agent1.sinks.k2.channel = c1

agent1.sinks.k2.type = avro

agent1.sinks.k2.hostname = hadoop2

agent1.sinks.k2.port = 52020

#set sink group

agent1.sinkgroups.g1.sinks = k1 k2

#set failover

agent1.sinkgroups.g1.processor.type = failover

agent1.sinkgroups.g1.processor.priority.k1 = 10

agent1.sinkgroups.g1.processor.priority.k2 = 1

agent1.sinkgroups.g1.processor.maxpenalty = 10000
collector1配置(flume-server.conf):
#set Agent name

a1.sources = r1

a1.channels = c1

a1.sinks = k1

#set channel

a1.channels.c1.type = memory

a1.channels.c1.capacity = 1000

a1.channels.c1.transactionCapacity = 100

# other node,nna to nns

a1.sources.r1.type = avro

a1.sources.r1.bind = hadoop1

a1.sources.r1.port = 52020

a1.sources.r1.interceptors = i1

a1.sources.r1.interceptors.i1.type = static

a1.sources.r1.interceptors.i1.key = Collector

a1.sources.r1.interceptors.i1.value = hadoop1

a1.sources.r1.channels = c1

#set sink to hdfs

a1.sinks.k1.type=logger

a1.sinks.k1.channel=c1
collector2配置(flume-server.conf):
#set Agent name

a1.sources = r1

a1.channels = c1

a1.sinks = k1

#set channel

a1.channels.c1.type = memory

a1.channels.c1.capacity = 1000

a1.channels.c1.transactionCapacity = 100

# other node,nna to nns

a1.sources.r1.type = avro

a1.sources.r1.bind = hadoop2

a1.sources.r1.port = 52020

a1.sources.r1.interceptors = i1

a1.sources.r1.interceptors.i1.type = static

a1.sources.r1.interceptors.i1.key = Collector

a1.sources.r1.interceptors.i1.value = hadoop2

a1.sources.r1.channels = c1

#set sink to hdfs

a1.sinks.k1.type=logger

a1.sinks.k1.channel=c1
先启动server,在启动client:
flume-ng agent --conf conf --conf-file /usr/local/flume/conf/flume-server.conf --name a1 -Dflume.root.logger=INFO,console
flume-ng agent --conf conf --conf-file /usr/local/flume/conf/flume-client.conf --name agent1 -Dflume.root.logger=INFO,console
测试验证:
hadoop1收到了hadoop3的消息了,哈哈。hadoop2没有收到消息,那是因为hadoop1的priority高。
hadoop3:

hadoop1:

hadoop2:

再次测试Failover:
停掉hadoop1的Flume,再次在hadoop3发送数据。可见hadoop3的Flume报错重连了,并且hadoop2收到了数据。如果再次启动hadoop1的Flume,一切又会恢复到hadoop1接收。
hadoop3:


hadoop2:

这样测试就完毕了。Flume高可用集群就搭建好了!
Flume 学习笔记之 Flume NG高可用集群搭建的更多相关文章
- Flume NG高可用集群搭建详解
.Flume NG简述 Flume NG是一个分布式,高可用,可靠的系统,它能将不同的海量数据收集,移动并存储到一个数据存储系统中.轻量,配置简单,适用于各种日志收集,并支持 Failover和负载均 ...
- SpringCloud全家桶学习之服务注册与发现及Eureka高可用集群搭建(二)
一.Eureka服务注册与发现 (1)Eureka是什么? Eureka是NetFlix的一个子模块,也是核心模块之一.Eureka是一个基于REST的服务,用于定位服务,以实现云端中间层服务发现和故 ...
- Hadoop 3.1.2(HA)+Zookeeper3.4.13+Hbase1.4.9(HA)+Hive2.3.4+Spark2.4.0(HA)高可用集群搭建
目录 目录 1.前言 1.1.什么是 Hadoop? 1.1.1.什么是 YARN? 1.2.什么是 Zookeeper? 1.3.什么是 Hbase? 1.4.什么是 Hive 1.5.什么是 Sp ...
- .Net Core2.1 秒杀项目一步步实现CI/CD(Centos7.2)系列一:k8s高可用集群搭建总结以及部署API到k8s
前言:本系列博客又更新了,是博主研究很长时间,亲自动手实践过后的心得,k8s集群是购买了5台阿里云服务器部署的,这个集群差不多搞了一周时间,关于k8s的知识点,我也是刚入门,这方面的知识建议参考博客园 ...
- 实现CI/CDk8s高可用集群搭建总结以及部署API到k8s
实现CI/CD(Centos7.2)系列二:k8s高可用集群搭建总结以及部署API到k8s 前言:本系列博客又更新了,是博主研究很长时间,亲自动手实践过后的心得,k8s集群是购买了5台阿里云服务器部署 ...
- hadoop高可用集群搭建小结
hadoop高可用集群搭建小结1.Zookeeper集群搭建2.格式化Zookeeper集群 (注:在Zookeeper集群建立hadoop-ha,amenode的元数据)3.开启Journalmno ...
- Spark高可用集群搭建
Spark高可用集群搭建 node1 node2 node3 1.node1修改spark-env.sh,注释掉hadoop(就不用开启Hadoop集群了),添加如下语句 export ...
- Hadoop HA高可用集群搭建(Hadoop+Zookeeper+HBase)
声明:作者原创,转载注明出处. 作者:帅气陈吃苹果 一.服务器环境 主机名 IP 用户名 密码 安装目录 master188 192.168.29.188 hadoop hadoop /home/ha ...
- MongoDB高可用集群搭建(主从、分片、路由、安全验证)
目录 一.环境准备 1.部署图 2.模块介绍 3.服务器准备 二.环境变量 1.准备三台集群 2.安装解压 3.配置环境变量 三.集群搭建 1.新建配置目录 2.修改配置文件 3.分发其他节点 4.批 ...
随机推荐
- STL 中priority_queue小结
(1)为了运用priority_queue,你必须包含头文件<queue>:#include<queue> (2)在头文件中priority_queue定义如下: nam ...
- GRE Words Revenge AC自动机 二进制分组
GRE Words Revenge 题意和思路都和上一篇差不多. 有一个区别就是需要移动字符串.关于这个字符串,可以用3次reverse来转换, 前面部分翻转一下, 后面部分翻转一下, 最后整个串翻转 ...
- codeforces 811 C. Vladik and Memorable Trip(dp)
题目链接:http://codeforces.com/contest/811/problem/C 题意:给你n个数,现在让你选一些区间出来,对于每个区间中的每一种数,全部都要出现在这个区间. 每个区间 ...
- django中使用事务以及接入支付宝支付功能
之前一直想记录一下在项目中使用到的事务以及支付宝支付功能,自己一直犯懒没有完,趁今天有点兴致,在这记录一下. 商城项目必备的就是支付订单的功能,所以就会涉及到订单的保存以及支付接口的引入.先来看看订单 ...
- JS-特效 ~ 01. 事件对象、offset偏移/检测、无缝滚动、自动循环轮播图
Math.round ( ) :正书四舍五入,负数五舍六入 用定时器,先清除定时器 事件对象 event event:事件被触动时,鼠标和键盘的状态,通过属性控制 Offset:偏移,检测 1. 获取 ...
- mybatis foreach批量处理
---恢复内容开始--- http://blog.csdn.net/jiesa/article/details/52185617 foreach属性 属性 描述 item 循环体中的具体对象.支持属性 ...
- 数据库常用SQL语句(三):子查询
一.为什么会使用子查询 虽然可以通过连接查询来实现多表查询数据记录,但不建议使用,因为连接查询的性能很差,为什么呢?我们来进行分析,例如 我们要查询部门表t_dept 和雇员表t_employee中的 ...
- 8 分钟入门 K8s | 详解容器基本概念
作者| 阿里巴巴高级开发工程师 傅伟 一.容器与镜像 什么是容器? 在介绍容器的具体概念之前,先简单回顾一下操作系统是如何管理进程的. 首先,当我们登录到操作系统之后,可以通过 ps 等操作看到各式各 ...
- Go从入门到放弃
Go语言介绍 为什么你应该学习Go语言? 开发环境准备 从零开始搭建Go语言开发环境 VS Code配置Go语言开发环境 Go语言基础 Go语言基础之变量和常量 Go语言基础之基本数据类型 Go语言基 ...
- MySql创建索引、删除索引、新增字段、删除字段、修改字段语句
--------------------------------------------------------- -- ALTER TABLE 创建索引 ---------------------- ...