
Solr_全文检索引擎系统
Solr介绍:
Solr 是Apache下的一个顶级开源项目,采用Java开发,它是基于Lucene的全文搜索服务。Solr可以独立运行在Jetty、Tomcat等这些Servlet容器中。
Solr的作用:
solr是一个现成的全文检索引擎系统, 放入tomcat下可以独立运行, 对外通过http协议提供全文检索服务(就是对索引和文档的增删改查服务), 在代码中可以通过solrJ(solr的客户端的jar包)来调用solr服务。
Lucene和solr的区别:
lucene是一个全文检索引擎工具包, 就是一堆jar包, 它放入tomcat下不能独立运行, 但是我们可以使用lucene来构建全文检索引擎系统;
solr底层是用lucene来开发的一个全文检索引擎系统, 放入tomcat下就可以独立运行, 对外通过http的形式,提供全文检索服务(索引和文档的增删改查服务)。
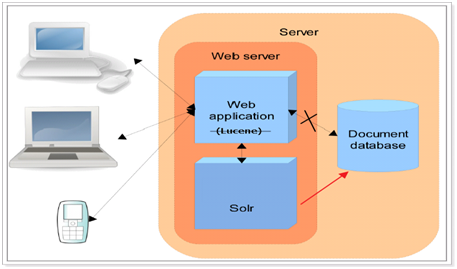
在Tomcat容器中部署solr工程的步骤:
1、下载solr压缩包,下载地址:http://archive.apache.org/dist/lucene/solr/(我这里使用的是solr-4.10.3);
2、准备好一个干净的Tomcat容器,并配置好JDK;
3、找到solr解压后的目录,将solr-4.10.3\example\webapps目录下的solr.war包放进Tomcat容器中运行,直接运行的目的是解压该war包,解压好之后关闭Tomcat容器并删除war包(必须要删除war包,否则再次运行时就覆盖了以前配置好的solr服务),开始部署solr服务;
4、找到solr解压后的目录,将solr-4.10.3\example\lib\ext目录下的所有jar包复制到Tomcat容器下的solr项目中的WEB-INF/lib目录下;
5、为solr服务准备家目录,找打solr解压后的目录,将solr-4.10.3\example目录下的有一个名称为solr的目录直接拷贝到硬盘根目录下,并且命名为solrHome(一般推荐这样做);
6、开始配置solr服务,找到Tomcat容器中部署的solr项目中的WEB-INF/web.xml文件,进行配置,首先打开<env-entry>标签,并且将刚刚拷贝好的solr的家目录的路径配置进去。
  <env-entry>

       <env-entry-name>solr/home</env-entry-name>

       <env-entry-value>G:\solrHome</env-entry-value>

       <env-entry-type>java.lang.String</env-entry-type>

    </env-entry>
7、启动Tomcat容器,并通过http://127.0.0.1:8080/solr地址访问即可,如果看到以下界面则配置成功。

8、 solr服务配置成功之后,就会默认有一个collection1的实例,如果需要的话也可以配置多个,将solrHome目录下的collection1目录拷贝多个并将每个目录下的core.properties配置文件中修改一下即可,记得重启Tomcat容器。
通过SolrJ操作并访问solr服务中的数据:
什么是solrj?
solrj是访问solr服务的Java客户端,提供索引和搜索的请求方法。

创建工程,并引入solrj所需的jar包:
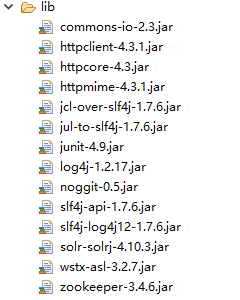
需求一:向solr服务中的collection1实例中添加数据?
   //向solr服务器中的collection1实例中添加数据

     @Test

     public void add() throws Exception{

         //1、创建与solr服务器的连接

         /*

          * http://localhost:8080/solr默认连接的是collection1实例

          * 如果想连接其他的实例,如collection2、collection3则在连接时必须指定:http://localhost:8080/solr/实例名称

          */

         SolrServer server = new HttpSolrServer("http://localhost:8080/solr");

         //2、创建solr的文档对象并添加数据

         SolrInputDocument document = new SolrInputDocument();

         document.addField("id", "003");

         document.addField("title", "solr");

         //3、将文档对象添加到solr服务器

         server.add(document);

         //4、提交

         server.commit();

     }
需求二:修改solr服务中collection3实例中的数据?
 //修改solr服务器上collection3实例中的数据

     @Test

     public void update() throws Exception{

         //1、连接solr服务器上collection3实例中的数据

         SolrServer server = new HttpSolrServer("http://localhost:8080/solr/collection3");

         //2、创建solr的文档对象并将数据修改

         SolrInputDocument document = new SolrInputDocument();

         document.addField("id", "001");

         document.addField("title", "博学谷");

         //3、将文档对象添加到solr服务器

         server.add(document);

         //4、提交

         server.commit();

     }
需求三:对solr服务中的数据进行删除操作,根据id删除、删除所有数据?
   //删除solr服务器上collection2实例中的指定数据:

     @Test

     public void delete() throws Exception{

         //1、连接solr服务器

         SolrServer server = new HttpSolrServer("http://localhost:8080/solr/collection2");

         //2、根据id删除数据

         server.deleteById("002");

         //3、提交

         server.commit();

     }

     //删除solr服务器上collection1实例中的所有数据:

     @Test

     public void deleteAll() throws Exception{

         //1、连接solr服务器

         SolrServer server = new HttpSolrServer("http://localhost:8080/solr/collection1");

         //2、删除指定实例下的所有数据

         server.deleteByQuery("*:*");

         //3、提交

         server.commit();

     }
需求四:检索solr服务中collection3实例中的全部数据?
   //查询solr服务器上collection3实例中所有的数据:

     @Test

     public void findAll() throws Exception{

         //1、连接solr服务器

         SolrServer server = new HttpSolrServer("http://localhost:8080/solr/collection3");

         //2、创建查询对象

         SolrQuery query = new SolrQuery();

         //3、给查询对象中设置查询条件

         query.setQuery("*:*");

         //4、查询并获取响应

         QueryResponse response = server.query(query);

         //5、从响应中获得结果集

         SolrDocumentList results = response.getResults();

         //6、处理结果集

         //输出结果集的总查询条数

         System.out.println(results.getNumFound());

         for (SolrDocument solrDocument : results) {

             System.out.println("id*************"+solrDocument.get("id"));

             System.out.println("title**********"+solrDocument.get("title"));

             System.out.println("===========================================");

         }

     }
Solr_全文检索引擎系统的更多相关文章
- solr服务中集成IKAnalyzer中文分词器、集成dataimportHandler插件
昨天已经在Tomcat容器中成功的部署了solr全文检索引擎系统的服务:今天来分享一下solr服务在海量数据的网站中是如何实现数据的检索. 在solr服务中集成IKAnalyzer中文分词器的步骤: ...
- Lucene总结
数据的分类 结构化数据:有固定类型或者有固定长度的数据 例如:数据库中的数据(mysql,oracle等), 元数据(就是windows中的数据) 结构化数据搜索方法: 数据库中数据通过sql语句可以 ...
- Solr入门介绍
solr入门案例 solr是apache下的一个全文检索引擎系统. 我们需要在服务器上单独去部署solr, 通过它的客户端工具包solrJ, 就是一个 jar包, 集成到我们项目中来调用服务器中 ...
- [IR] Open Source Search Engines
From:http://blog.csdn.net/xum2008/article/details/8740063 本文档是对现有的开源的搜索引擎的一个简单介绍 1. Lucene Lucene ...
- 全文搜索技术—Lucene
1. 内容安排 实现一个文件的搜索功能,通过关键字搜索文件,凡是文件名或文件内容包括关键字的文件都需要找出来.还可以根据中文词语进程查询,并且支持多种条件查询. 本案例中的原始内容就是磁盘上的文件 ...
- 全文搜索技术—Solr
1. 学习计划 1. Solr的安装及配置 a) Solr整合tomcat b) Solr后台管理功能介绍 c) 配置中文分析器 2. 使用Solr的后台管理索引库 a) ...
- solr简单学习---1
*服务器配置略,比较复杂,看视频 1.导入jar包 package cn.itcast.solr; import org.apache.solr.client.solrj.SolrServer; im ...
- Solr全文检索框架
概述: 什么是Solr? Solr是Apache下的一个顶级开源项目,采用Java开发,它是基于Lucene的全文搜索服务.Solr可以独立运行在Jetty.tomcat.webLogic.webSh ...
- lucene 全文检索工具的介绍
Lucene:全文检索工具:这是一种思想,使用的是C语言写出来的 1.Lucene就是apache下的一个全文检索工具,一堆的jar包,我们可以使用lucene做一个谷歌和百度一样的搜索引擎系统 2. ...
随机推荐
- 【.net 深呼吸】序列化中的“引用保留”
假设 K 类中有两个属性/字段的类型相同,并且它们引用的是同一个对象实例,在序列化的默认处理中,会为每个引用单独生成数据. 看看下面两个类. [DataContract] public class 帅 ...
- DDD CQRS架构和传统架构的优缺点比较
明天就是大年三十了,今天在家有空,想集中整理一下CQRS架构的特点以及相比传统架构的优缺点分析.先提前祝大家猴年新春快乐.万事如意.身体健康! 最近几年,在DDD的领域,我们经常会看到CQRS架构的概 ...
- CSS十问——好奇心+刨根问底=CSSer
最近有时间,想把酝酿的几篇博客都写出来,今天前端小学生带着10个问题,跟大家分享一下学习CSS的一些体会,我觉得想学好CSS,必须保持一颗好奇心和刨根问底的劲头,而不是复制粘贴,得过且过.本人能力有限 ...
- 当忘记mysql数据库密码时如何进行修改
因为长时间没有使用数据库了,或者把密码改完之后就忘了数据库密码,不能正常进入数据库,也无法修改密码,有一个简单的常用修改密码方式: 1.首先找到和打开mysql.exe和mysqld.exe所在的文件 ...
- 转:serialVersionUID作用
汗,以前学了还忘了... Java的序列化机制是通过在运行时判断类的serialVersionUID来验证版本一致性的.在进行反序列化时,JVM会把传来的字节流中的serialVersionUID与本 ...
- 【翻译】Awesome R资源大全中文版来了,全球最火的R工具包一网打尽,超过300+工具,还在等什么?
0.前言 虽然很早就知道R被微软收购,也很早知道R在统计分析处理方面很强大,开始一直没有行动过...直到 直到12月初在微软技术大会,看到我软的工程师演示R的使用,我就震惊了,然后最近在网上到处了解和 ...
- notepad++设置默认打开txt文件失效的解决方法
1.系统环境 win10企业版,64位系统 2.初步设置 设置txt默认为notepad++打开,菜单:设置->首选项->文件关联 选择对应的文件扩展,点击"关闭"按钮 ...
- OpenLiveWriter代码插件
1.OpenLiveWriter安装 Windows Live Writer在2012年就停止了更新,Open Live Writer(以下简称OLW)是由Windows Live WriterWri ...
- Java列表
Java列表踩过的坑 其中subList是RandomAccessSubList,不是序列化的列表,不可以加入tair. 加入tair测试代码 @Autowired private CacheMana ...
- 设计模式之工厂模式VS抽象工厂
一.工厂模式主要是为创建对象提供过渡接口,以便将创建对象的具体过程屏蔽隔离起来,达到提高灵活性的目的. 工厂模式在<Java与模式>中分为三类:1)简单工厂模式(Simple Factor ...