
MySql分区后创建索引加速单表查询和连表查询
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
本文链接:https://blog.csdn.net/konkon2012/article/details/96482548
为了加快查询,我们通常根据Where条件创建索引!那么分区后再创建索引,那就应该更快了!
我们依据订单表和订单商品表举例,先创建表结构:
CREATE TABLE `zstb_orders` (

`order_id` INT(10) UNSIGNED NOT NULL AUTO_INCREMENT,

`org_id` INT(10) UNSIGNED NOT NULL,

`order_money` DECIMAL(6,2) UNSIGNED NOT NULL DEFAULT '0.00',

PRIMARY KEY (`order_id`,`org_id`),

KEY `order_id` (`order_id`)

) ENGINE=INNODB DEFAULT CHARSET=utf8;

CREATE TABLE `zstb_orders_goods` (

`order_id` INT(10) UNSIGNED NOT NULL DEFAULT '0',

`org_id` INT(10) UNSIGNED NOT NULL DEFAULT '0',

`goods_id` INT(10) UNSIGNED NOT NULL DEFAULT '0',

`goods_name` VARCHAR(20) DEFAULT '',

PRIMARY KEY (`order_id`,`org_id`,`goods_id`)

) ENGINE=INNODB DEFAULT CHARSET=utf8;
我们通过`org_id`来对两张表进行分区,脚本如下:
ALTER TABLE `zstb_orders` PARTITION BY RANGE(`org_id`) (

PARTITION p1 VALUES LESS THAN (100),

PARTITION p2 VALUES LESS THAN (200),

PARTITION p3 VALUES LESS THAN (300),

PARTITION p4 VALUES LESS THAN (400),

PARTITION p5 VALUES LESS THAN MAXVALUE

);

ALTER TABLE `zstb_orders_goods` PARTITION BY RANGE(`org_id`) (

PARTITION p1 VALUES LESS THAN (100),

PARTITION p2 VALUES LESS THAN (200),

PARTITION p3 VALUES LESS THAN (300),

PARTITION p4 VALUES LESS THAN (400),

PARTITION p5 VALUES LESS THAN MAXVALUE

);
至于为什么要使用'org_id'来进行分区,不是本文要讨论的问题,你可以根据你自身的需求使用其他字段来进行分区。
然后插入几条数据:
INSERT INTO `zstb_orders`(`order_id`, `org_id`, order_money) VALUES (1, 50, 200);

INSERT INTO `zstb_orders_goods`(`order_id`,`org_id`,`goods_id`,`goods_name`) VALUES (1, 50, 1, '酸奶');

INSERT INTO `zstb_orders_goods`(`order_id`,`org_id`,`goods_id`,`goods_name`) VALUES (1, 50, 2, '纯奶');

INSERT INTO `zstb_orders`(`order_id`, `org_id`, order_money) VALUES (2, 150, 200);

INSERT INTO `zstb_orders_goods`(`order_id`,`org_id`,`goods_id`,`goods_name`) VALUES (2, 150, 1, '酸奶');

INSERT INTO `zstb_orders_goods`(`order_id`,`org_id`,`goods_id`,`goods_name`) VALUES (2, 150, 2, '纯奶');

INSERT INTO `zstb_orders`(`order_id`, `org_id`, order_money) VALUES (3, 350, 200);

INSERT INTO `zstb_orders_goods`(`order_id`,`org_id`,`goods_id`,`goods_name`) VALUES (3, 350, 1, '酸奶');

INSERT INTO `zstb_orders_goods`(`order_id`,`org_id`,`goods_id`,`goods_name`) VALUES (3, 350, 2, '纯奶');
接下来我们来进行查询分析:
EXPLAIN PARTITIONS SELECT * FROM `zstb_orders` WHERE org_id = 150;

我们对订单表进行查询的时候,发现虽然仅仅扫描‘p2’分区,但是没有使用到主键索引,有点遗憾。
同样,我们也对订单商品表进行查询分析:
EXPLAIN PARTITIONS SELECT * FROM `zstb_orders_goods` WHERE org_id = 150;

结果还是只扫描'p2'分区,并没有使用到主键索引。
我们再分析连表查询试试:
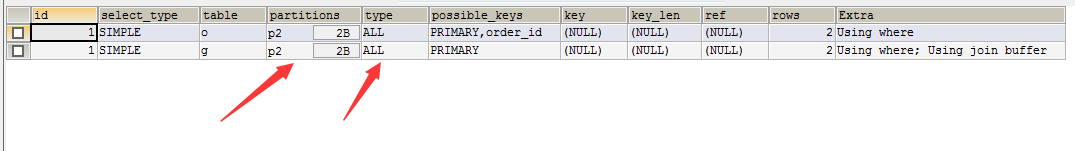
EXPLAIN PARTITIONS SELECT * FROM `zstb_orders` AS o JOIN `zstb_orders_goods` AS g ON o.order_id = g.order_id WHERE o.org_id = 150;

对主表‘zstb_orders’的查询虽然只扫描‘p2’分区,但是没有使用主键索引。
对连表‘zstb_orders_goods’的查询是扫描全表,但是使用了主键索引,为什么没有扫描具体的分区表呢?
EXPLAIN PARTITIONS SELECT * FROM `zstb_orders` AS o JOIN `zstb_orders_goods` AS g ON o.order_id = g.order_id AND o.org_id = g.org_id WHERE o.org_id = 150;
考虑‘zstb_orders_goods’是通过'org_id'进行分区的,但是连表查询的时候,没有指明对'org_id',我们只需要在关联查询条件
上面增加‘org_id’的关联即可,分析如下:
主表查询没有变化,连表‘zstb_orders_goods’的查询虽然找到了分区表'p2',但是索引又丢失了!
所以,如果我们需要建立分区的同时,还要使用索引的话,得重新创建了。
ALTER TABLE `zstb_orders_goods` ADD INDEX org_id_index(`org_id`);
创建完之后,我们先看看单表查询情况:
EXPLAIN PARTITIONS SELECT * FROM `zstb_orders_goods` WHERE org_id = 150;

刚才虽然扫描了'p2'分区,但是没有使用索引,这次我们创建索引后,它就用上了,OK!
在分析刚才的连表查询语句:
EXPLAIN PARTITIONS SELECT * FROM `zstb_orders` AS o JOIN `zstb_orders_goods` AS g ON o.order_id = g.order_id AND o.org_id = g.org_id WHERE o.org_id = 150;
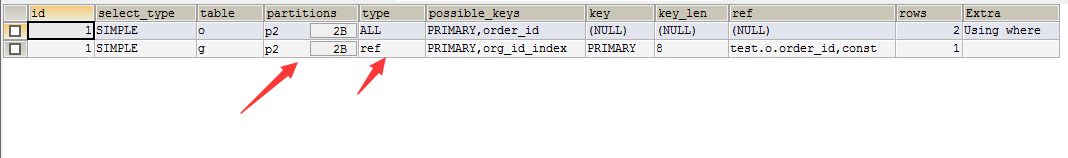
即扫描了分区表,又使用到了索引!
当然,如果希望主表'zstb_orders'查询的时候也使用索引的话,那么我们也需要对'zstb_orders'创建'org_id'索引即可。
————————————————
版权声明:本文为CSDN博主「咆哮的程序猿」的原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/konkon2012/article/details/96482548
MySql分区后创建索引加速单表查询和连表查询的更多相关文章
- Oracle常用操作——创建表空间、临时表空间、创建表分区、创建索引、锁表处理
摘要:Oracle数据库的库表常用操作:创建与添加表空间.临时表空间.创建表分区.创建索引.锁表处理 1.表空间 ■ 详细查看表空间使用状况,包括总大小,使用空间,使用率,剩余空间 --详细查看表空 ...
- 几百万的数据,mysql快速高效创建索引
有一个问题,一张表有3百万条记录,随着时间的增加,记录量会更多,此时查询速度很慢.在创建此表前没有未相应字段添加索引,所以此时需要为表添加索引.但是因为数据量大的原因,索引添加不成功,想了很多办法,终 ...
- mysql 分区后查询效率
准备工作: 蠕虫复制 文章表 增加数据到112万 语法:insert into tableNameA select * from tableNameB 未分区查询 54s 改变现有表 ...
- MySQL 分区建索引
200 ? "200px" : this.width)!important;} --> 介绍 mysql分区后每个分区成了独立的文件,虽然从逻辑上还是一张表其实已经分成了多张 ...
- mysql分区表之三:MySQL分区建索引[转]
介绍 mysql分区后每个分区成了独立的文件,虽然从逻辑上还是一张表其实已经分成了多张独立的表,从“information_schema.INNODB_SYS_TABLES”系统表可以看到每个分区都存 ...
- mysql笔记02 创建高性能的索引
创建高性能的索引 1. 索引(在MySQL中也叫做"键(key)")是存储引擎用于快速找到记录的一种数据结构. 2. 索引可以包含一个或多个列的值.如果索引包含多个列,那么列的顺序 ...
- SOLR对多个(关联)表创建索引
又两天没写博客,关于SOLR的东西,写了一周了还没写完我也是醉了,毕竟会的东西真不多,周四晚上加班没写,周五晚上公司同事聚会也没写,今天在家,还是把最后的一点写完吧,我会的剩下的也就是一个对多个表创建 ...
- MySQL的视图和索引
MySQL的视图 简单来说MySQL的视图就是对SELECT 命令的定义的一个快捷键,我们查询时会用到非常复杂的SELECT语句,而这个语句我们以后还会经常用到,我们可以经这个语句生产视图.视图是一个 ...
- MySQL数据库篇之索引原理与慢查询优化之一
主要内容: 一.索引的介绍 二.索引的原理 三.索引的数据结构 四.聚集索引与辅助索引 五.MySQL索引管理 六.测试索引 七.正确使用索引 八.联合索引与覆盖索引 九.查询优化神器--explai ...
随机推荐
- EF 批量增删改 EntityFramework.Extensions
EntityFramework.Extensions 1.官方网站 http://entityframework-extensions.net/ 2 破解版 Z.EntityFramework.E ...
- xml和json的判断格式是否相等
手动撸了个 xml 和 json 格式匹配的代码. /** * 判断数据的结构.遍历节点然后去对应的json那边查找是否存在这样的节点 * * @param root 配置的xml所对应的对Eleme ...
- 编译安装 keepalived-2.0.16.tar.gz
一.下载安装包 wget https://www.keepalived.org/software/keepalived-2.0.16.tar.gz 安装相关依赖 把所有的rpm包放在一个目录下. rp ...
- win2008r2 32位odbc安装笔记
这ORACLE也太难用了,想简单点了事只用个ODBC CLIENT都是件麻烦事,总结了一下,安装流程如下: 1.去官网或其它地方下载: 64位: instantclient-basic-windows ...
- JMeter压测时报“内存不足”故障的9个简单解决方案
Test failed! java.lang.OutOfMemoryError: Java heap space 测试失败了!java.lang.OutOfMemoryError:Java堆空间 在不 ...
- 手写二叉树-先序构造(泛型)-层序遍历(Java版)
如题 先序构造 数据类型使用了泛型,在后续的更改中,更换数据类型只需要少许的变更代码 层序遍历 利用Node类的level属性 所有属性的权限全为public ,为了方便先这么写吧,建议还是用priv ...
- Centos7-网卡配置
目标计划:熟悉Linux网卡 1.修改网卡名称,替换自动生成的网卡名 2.新建网卡配置文件与新增网卡的关系 3.网卡bond模式配置,team模式 4.NetworkManager-nmcli管理网络 ...
- ARTS-week6
Algorithm 给定一个已按照升序排列 的有序数组,找到两个数使得它们相加之和等于目标数.函数应该返回这两个下标值 index1 和 index2,其中 index1 必须小于 index2 Tw ...
- 通过ip找mac
# coding:utf-8 import os cmd = {'arp': 'arp -a | find "', 'route': 'route PRINT ' } def win_mac ...
- C# Base64字符串生成图片
C# Base64字符串生成图片: //签字图片Base64格式去除开头多余字符data:image/png;base64, strSignImg = strSignImg.Substring(str ...