
flume到flume消息传递
环境:两台虚拟机( 每台都有flume)
第一台slave作为消息的产生者
第二台master作为消息的接收者 IP(192.168.83.133)
原理:通过监听slave中文件的变化,获取变化信息,发送到另一台电脑。
1、slave上配置conf里面的example.conf(标红的注意下)
#Name the components on this agent

a1.sources = r1

a1.sinks = k1

a1.channels = c1

# Describe/configure the source

a1.sources.r1.type = exec

a1.sources.r1.command = tail -F /home/qq/pp/data/test.log

a1.sources.r1.channels = c1

# Describe the sink

##sink端的avro是一个数据发送者

a1.sinks = k1

##type设置成avro来设置发消息

a1.sinks.k1.type = avro

a1.sinks.k1.channel = c1

##下沉到hadoop2这台机器

a1.sinks.k1.hostname = 192.168.83.133

##下沉到mini2中的44444

a1.sinks.k1.port = 44444

a1.sinks.k1.batch-size =

# Use a channel which buffers events in memory

a1.channels.c1.type = memory

a1.channels.c1.capacity =

a1.channels.c1.transactionCapacity =

# Bind the source and sink to the channel

a1.sources.r1.channels = c1

a1.sinks.k1.channel = c1
2、master上配置conf里面的example.conf(标红的注意下)
# Name the components on this agent

a1.sources = r1

a1.sinks = k1

a1.channels = c1

# Describe/configure the source

##source中的avro组件是一个接收者服务

a1.sources.r1.type = avro

a1.sources.r1.channels = c1

a1.sources.r1.bind = 0.0.0.0

a1.sources.r1.port = 44444

# Describe the sink

a1.sinks.k1.type = logger

# Use a channel which buffers events in memory

a1.channels.c1.type = memory

a1.channels.c1.capacity =

a1.channels.c1.transactionCapacity =

# Bind the source and sink to the channel

a1.sources.r1.channels = c1

a1.sinks.k1.channel = c1
3、向监听文件写入字符串(程序循环写入,不用手动修改test.log文件了)
[root@s1 # cd /home/qq/pp/data

[root@s1 home/qq/pp/data# while true

> do

> echo "fdssdgfgf" >> test.log
> sleep

> done
4、查看上面的程序是否执行
#cd /home/qq/pp/data
#tail -f test.log
显示如下即可:
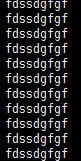
5、打开消息接收者master的flume
进入flume安装目录,执行如下语句
bin/flume-ng agent -c conf -f conf/example.conf -n a1 -Dflume.root.logger=INFO,console
现在回打印出一些信息
6、启动slave的flume
进入flume安装目录,执行如下语句
bin/flume-ng agent -c conf -f conf/example.conf -n a1 -Dflume.root.logger=INFO,console
7、查看5)中的窗口会显示插入的字符串

参考:https://blog.csdn.net/tototuzuoquan/article/details/73203241
flume到flume消息传递的更多相关文章
- Flume篇---Flume安装配置与相关使用
一.前述 Copy过来一段介绍Apache Flume 是一个从可以收集例如日志,事件等数据资源,并将这些数量庞大的数据从各项数据资源中集中起来存储的工具/服务,或者数集中机制.flume具有高可用, ...
- [Flume][Kafka]Flume 与 Kakfa结合例子(Kakfa 作为flume 的sink 输出到 Kafka topic)
Flume 与 Kakfa结合例子(Kakfa 作为flume 的sink 输出到 Kafka topic) 进行准备工作: $sudo mkdir -p /flume/web_spooldir$su ...
- [Flume]使用 Flume 来传递web log 到 hdfs 的例子
[Flume]使用 Flume 来传递web log 到 hdfs 的例子: 在 hdfs 上创建存储 log 的目录: $ hdfs dfs -mkdir -p /test001/weblogsfl ...
- Flume学习——Flume中事务的定义
首先要搞清楚的问题是:Flume中的事务用来干嘛? Flume中的事务用来保证消息的可靠传递. 当使用继承自BasicChannelSemantics的Channel时,Flume强制在操作Chann ...
- Flume学习——Flume的架构
Flume有三个组件:Source.Channel 和 Sink.在源码中对应同名的三个接口. When a Flume source receives an event, it stores it ...
- 【Flume】flume于transactionCapacity和batchSize进行详细的分析和质疑的概念
我不知道你用flume读者熟悉无论这两个概念 一开始我是有点困惑,? 没感觉到transactionCapacity的作用啊? batchSize又是干啥的啊? -- -- 带着这些问题,我们深入源代 ...
- 整体认识flume:Flume介绍、分布式安装、常见问题及解决方案
问题导读 1.什么是flume? 2.flume包含哪些组件? 3.Flume在读取utf-8格式的文件时会出现解析不了时间戳,该如何解决? Flume是一个分布式.可靠.和高可用的海量日志采集.聚合 ...
- 日志采集框架Flume以及Flume的安装部署(一个分布式、可靠、和高可用的海量日志采集、聚合和传输的系统)
Flume支持众多的source和sink类型,详细手册可参考官方文档,更多source和sink组件 http://flume.apache.org/FlumeUserGuide.html Flum ...
- 流量分析系统---flume(测试flume+kafka)
1.在flume官方网站下载最新的flume wget http://124.205.69.169/files/A1540000011ED5DB/mirror.bit.edu.cn/apach ...
随机推荐
- spring-security.xml——安全性框架配置文件
<?xml version="1.0" encoding="UTF-8"?><beans:beans xmlns="http://w ...
- 2019-09-16 PHP CURL CURLOPT参数说明(curl_setopt)
CURLOPT_RETURNTRANSFER 选项: curl_setopt($ch, CURLOPT_RETURNTRANSFER,1); 如果成功只将结果返回,不自动输出任何内容. 如果失败返回F ...
- OKGo vs RxHttpUtils ...
jeasonlzy/okhttp-OkGohttps://github.com/jeasonlzy/okhttp-OkGo Android OkGo基本操作https://www.jianshu.co ...
- SpringBoot集成JWT
JWT(json web tokens)是目前比较流行的跨域认证解决方案:说通俗点就是比较流行的token生成和校验的方案.碰巧公司有个app的项目的token采用了jwt方案,因此记录下后端 ...
- python库包大全(转)
python 库资源大全 转自: Python 资源大全中文版 环境管理 管理 Python 版本和环境的工具 p:非常简单的交互式 python 版本管理工具.官网 pyenv:简单的 Python ...
- springboot集成spring data ElasticSearch
ES支持SpringBoot使用类似于Spring Data Jpa的方式查询,使得查询更加方便. 1.依赖引入 compile “org.springframework.boot:spring-bo ...
- NBU磁带库报错代码
Linux驱动报错"Sense Key"和"ASC and ASCQ"含义 1.Sense Keys Definitions 0x0 No sense 0x1 ...
- Mybatis-plus中的condition条件
@Test public void testCondition() { String name = "王"; String email = ""; condit ...
- 00-赵志勇机器学习-Logistics_Regression-data.txt(转载)
4.45925637575900 8.22541838354701 0 0.0432761720122110 6.30740040001402 0 6.99716180262699 9.3133933 ...
- Git创建与简单使用
一. 服务器端 创建空的仓库(以项目tm201为例) 1. git账户登录 2. 新建仓库目录 mkdir tm101.git && cd tm201.git 3. git初始化新的空 ...