
scrapy——4 —反爬措施—logging—重要参数—POST请求发送实战
scrapy——4
- 动态的设置User-Agent(随即切换User-Agent,模拟不同的用户的浏览器信息)
- 禁用Cookies(也就是不启用cookies middleware,不向Server发送cookies的使用发现爬虫行为)可以通过COOKIES_ENABLED控制CookiesMiddleware开启或关闭
- 设置延迟下载(防止访问过于频繁,设置为2秒或者更高)
- Google Cache 和 BaiduCache:如果可能的话,使用谷歌/百度等搜索引擎服务器页面缓存获取页面数据。
- 使用Ip地址池:;VPN和代理IP,现在大部分网站都是根据IP来反爬的
Log levels——Scrapy提供5层loggin等级:
- CRITICAL - 严重错误(critical)
- ERROR - 一般错误(regular errors)
- WARNING - 警告信息(warning messages)
- INFO - 一般信息(informational messages)
- DEBUG - 调试信息(debugging messages)
logging设置:
通过在setting.py中进行以下设置可以被用来配置logging:
- LOG_ENABLED 默认: True,启用logging
- LOG_ENCODING 默认: 'utf-8',logging使用的编码
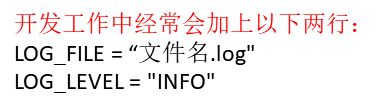
- LOG_FILE 默认: None,在当前目录里创建logging输出文件的文件名
- LOG_LEVEL 默认: 'DEBUG',log的最低级别
- LOG_STDOUT 默认: False 如果为 True,进程所有的标准输出(及错误)将会被重定向到log中。例如,执行 print "hello" ,其将会在Scrapy log中显示。
- 在尝试运行代码时,这样输入 scrapy crawl xxxx --nolog 输出时不会弹出logging信息

- url: 就是需要请求,并进行下一步处理的url
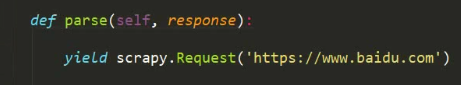
- callback: 指定该请求返回的Response,由那个函数来处理。
- method: 请求一般不需要指定,默认GET方法,可设置为"GET", "POST", "PUT"等,且保证字符串大写
- headers: 请求时,包含的头文件。一般不需要
- meta: 比较常用,在不同的请求之间传递数据使用的。字典dict型
- encoding: 使用默认的 'utf-8' 就行。
- dont_filter: 表明该请求不由调度器过滤。这是当你想使用多次执行相同的请求,忽略重复的过滤器。默认为False。


- status: 响应码
- _set_body(body): 响应体
- _set_url(url):响应url


实战— 豆瓣登陆
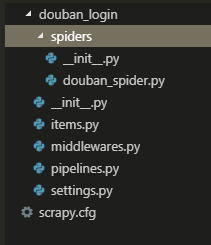
- 先创建项目
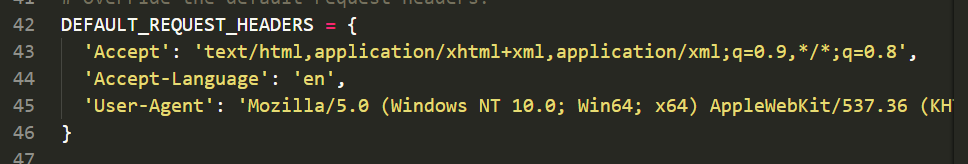
- douban_login\settings.py 设置请求头以及你的账号和密码(setting中)
- douban_login\spiders\douban_spider.py 写代码
# -*- coding: utf-8 -*-

import scrapy

from ..settings import username, password

class DoubanSpiderSpider(scrapy.Spider):

    name = 'douban_spider'

    allowed_domains = ['douban.com']

    start_urls = ['https://accounts.douban.com/login']

    def start_requests(self):

        data = {    # POST请求多要携带的数据,由formdata传递

            'source': 'index_nav',

            'form_email': username,

            'form_password': password,

        }

        yield scrapy.FormRequest(url=self.start_urls[0], formdata=data, callback=self.login_after)

    def login_after(self, response):

        print(response.url)

        user = response.xpath('//a[@class="bn-more"]/span/text()').extract_first() # 获取用户姓名,方便确认登陆是或否成功

        print('当前用户:%s'%user)

'''

douban_login$ scrapy crawl douban_spider --nolog

https://www.douban.com/

当前用户:pywjh的帐号

'''
实战二——gethub登陆
方法雷同,在setting中设置用户名和密码,需要注意的是,gethub有一个令牌的反爬措施,需要get请求一个登陆页面获取令牌,再POST请求登陆
# -*- coding: utf-8 -*-

from ..settings import username, password

import scrapy

class GithubSpider(scrapy.Spider):

    name = 'github'

    allowed_domains = ['github.com']

    start_urls = ['https://github.com/login']

    def parse(self, response):

        token = response.xpath("//input[@name='authenticity_token']/@value").extract_first()

        data = {

            'utf8': '✓',

            'authenticity_token': token,

            'login': username,

            'password': password,

            'commit': 'Sign in',

        }

        yield  scrapy.FormRequest(

            url='https://github.com/session',

            formdata=data,

            callback=self.parse_item)

    def parse_item(self,response):

        name = response.xpath('//*[@id="user-links"]/li[3]/details/summary/img/@alt').extract_first().replace('@', '')

        print('当前用户:%s'%name)
scrapy——4 —反爬措施—logging—重要参数—POST请求发送实战的更多相关文章
- 常见的反爬措施:UA反爬和Cookie反爬
摘要:为了屏蔽这些垃圾流量,或者为了降低自己服务器压力,避免被爬虫程序影响到正常人类的使用,开发者会研究各种各样的手段,去反爬虫. 本文分享自华为云社区<Python爬虫反爬,你应该从这篇博客开 ...
- Scrapy中的反反爬、logging设置、Request参数及POST请求
常用的反反爬策略 通常防止爬虫被反主要有以下几策略: 动态设置User-Agent(随机切换User-Agent,模拟不同用户的浏览器信息.) 禁用cookies(也就是不启用cookies midd ...
- 【Python3爬虫】反反爬之破解同程旅游加密参数 antitoken
一.前言简介 在现在各个网站使用的反爬措施中,使用 JavaScript 加密算是很常用的了,通常会使用 JavaScript 加密某个参数,例如 token 或者 sign.在这次的例子中,就采取了 ...
- Python爬虫入门教程 64-100 反爬教科书级别的网站-汽车之家,字体反爬之二
说说这个网站 汽车之家,反爬神一般的存在,字体反爬的鼻祖网站,这个网站的开发团队,一定擅长前端吧,2019年4月19日开始写这篇博客,不保证这个代码可以存活到月底,希望后来爬虫coder,继续和汽车之 ...
- Python爬虫入门教程 61-100 写个爬虫碰到反爬了,动手破坏它!
python3爬虫遇到了反爬 当你兴冲冲的打开一个网页,发现里面的资源好棒,能批量下载就好了,然后感谢写个爬虫down一下,结果,一顿操作之后,发现网站竟然有反爬措施,尴尬了. 接下来的几篇文章,我们 ...
- k 近邻算法解决字体反爬手段|效果非常好
字体反爬,是一种利用 CSS 特性和浏览器渲染规则实现的反爬虫手段.其高明之处在于,就算借助(Selenium 套件.Puppeteer 和 Splash)等渲染工具也无法拿到真实的文字内容. 这种反 ...
- python爬虫之字体反爬
一.什么是字体反爬? 字体反爬就是将关键性数据对应于其他Unicode编码,浏览器使用该页面自带的字体文件加载关键性数据,正常显示,而当我们将数据进行复制粘贴.爬取操作时,使用的还是标准的Unicod ...
- 记一次css字体反爬
前段时间在看css反爬的时候,发现很多网站都做了css反爬,比如,设置字体反爬的(58同城租房版块,实习僧招聘https://www.shixiseng.com/等)设置雪碧图反爬的(自如租房http ...
- CSS常见反爬技术
目录 利用字体 反爬原理 应对措施 难点: 利用背景 反爬原理 应对措施 利用伪类 反爬原理 应对措施 利用元素定位 反爬原理 应对措施 利用字符切割 反爬原理 应对措施 利用字体 反爬原理 反爬原理 ...
随机推荐
- cf 749D Leaving Auction
Leaving Auction time limit per test 2 seconds memory limit per test 256 megabytes input standard inp ...
- TS流解析 四
一 从TS流开始 数字电视机顶盒接收到的是一段段的码流,我们称之为TS(Transport Stream,传输流),每个TS流都携带一些信息,如Video.Audio以及我们需要学习的PAT.PMT等 ...
- bzoj4872
期望dp 首先如果k=n的话,那么我们从后往前,只要看到两者的灯就关上,因为如果当前一个灯没关上,那么之后不可能关上,一个灯只能由自己倍数控制,所以这样我们就计算出了需要操作的次数,如果这个次数< ...
- 43. ExtJs控件属性配置详细
转自:https://www.cnblogs.com/mannixiang/p/6558225.html 序言: 1.本文摘自网络,看控件命名像是4.0以前的版本,但控件属性配置仍然可以借鉴(不 ...
- PCB WebAPI跨域访问 实现方式
我们写WebAPI不仅自己系统调用,也需要给其它系统调用,那么如何实现跨域访问了,在这里介绍2种方法实现 方法一.修改Web.Config文件 实现 此方法是全局实现跨域,如果仅想某个方法实现跨域 ...
- codevs1258 关路灯(☆区间dp)
1258 关路灯 时间限制: 1 s 空间限制: 128000 KB 题目等级 : 大师 Master 题目描述 Description 多瑞卡得到了一份有趣而高薪的工作.每天早晨他必须 ...
- codevs1026商务旅行
1036 商务旅行 时间限制: 1 s 空间限制: 128000 KB 题目等级 : 钻石 Diamond 题解 题目描述 Description 某首都城市的商人要经常到各城镇去做 ...
- Django day32 跨域问题,创建vue项目,axios的使用
一:跨域问题 1.同源策略(浏览器的安全策略) 只允许当前页面朝当前域下发请求,如果向其他域发请求,请求可以正常发送,数据也可以拿回,但是被浏览器拦截了 2.cors:只要服务器实现了CORS,就可以 ...
- Akka源码分析-Persistence-AtLeastOnceDelivery
使用过akka的应该都知道,默认情况下,消息是按照最多一次发送的,也就是tell函数会尽量把消息发送出去,如果发送失败,不会重发.但有些业务场景,消息的发送需要满足最少一次,也就是至少要成功发送一次. ...
- RHEL6.5 设置yum,IP地址,解压缩
系统运维 www.osyunwei.com 温馨提醒:qihang01原创内容©版权所有,转载请注明出处及原文链接 服务器相关设置如下: 操作系统:RHEL 6.5 64位 IP地址:192.168. ...