
洛谷 P2824 [HEOI2016/TJOI2016]排序 (线段树合并)
(另外:题解中有一种思路很高妙而且看上去可以适用一些其他情况的离线方法)
线段树合并&复杂度的简单说明:https://blog.csdn.net/zawedx/article/details/51818475
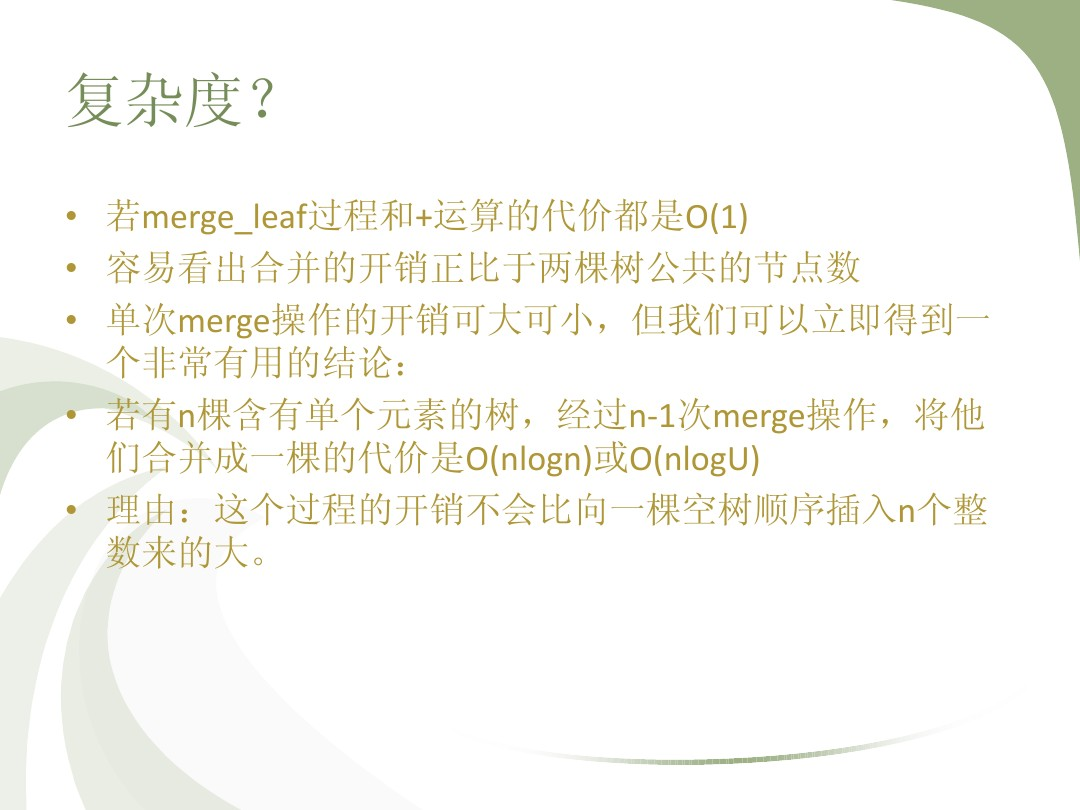
调用一次合并函数的时间是常数,
而合并函数每调用一次就会删掉一个点,
所以合并的总代价为删掉的点数和,
或者理解为:
所以好像要合并就不能可持久化?(指保留每一个版本,在合并后仍旧保留合并前的版本)(不确定)
(部分的可持久化应该是可以的,就是在每次合并后保留合并前的版本,但合并前的版本不能再次拿去合并了)
(就是在merge里改一下,如果两个节点同时不为空则新建一个节点而不是直接把其中一个节点当成新节点)
(原因是,这样子相当于每调用一次merge函数从最多删掉一个点变成最多增加一个点;而显然调用merge函数的次数一定是对的,那么增加的空间复杂度也是对的)
此题就是个线段树合并裸题了,额外用一个set维护序列中某一段区间对应的权值线段树的根节点。区间排序就找出set中所有与询问区间相交的区间,将相交部分分裂出来(对应线段树的部分也要分裂出来,可能是前k大或后k大或整一段),然后将剩余部分插回set,最后将所有分出来的相交部分并起来,就得到询问区间排好序的权值线段树。复杂度是n*log
错误记录:空间开成O(n),
没删调试信息的代码:
 #include<cstdio>

 #include<algorithm>

 #include<set>

 using namespace std;

 int n,m;

 namespace SegT

 {

 const int N=;

 int lc[N],rc[N],dat[N];

 int st[N+];int top;

 void init()    {for(int i=N-;i>=;i--)st[++top]=i;}

 int getnode()    {int t=st[top--];lc[t]=rc[t]=dat[t]=;return t;}

 void delnode(int x)    {st[++top]=x;}

 #define mid (l+((r-l)>>1))

 int L,x;

 void _addx(int l,int r,int &num)

 {

     if(!num)    num=getnode();

     if(l==r)    {dat[num]+=x;return;}

     if(L<=mid)    _addx(l,mid,lc[num]);

     else    _addx(mid+,r,rc[num]);

     dat[num]=dat[lc[num]]+dat[rc[num]];

 }

 void addx(int pos,int &num)    {L=pos;x=;_addx(,n,num);}

 void split(int l,int r,int &num,int &x,int k)

 //当前区间为[l,r],将num中的前k小拆出来,放到x中

 {

     //assert(dat[num]>=k&&k>0);

     if(!k)    return;

     if(!x)    x=getnode();

     if(l==r)    {dat[num]-=k;dat[x]+=k;return;}

     int t=dat[lc[num]];

     if(t>k)    split(l,mid,lc[num],lc[x],k);

     else    lc[x]=lc[num],lc[num]=;

     if(t<k)    split(mid+,r,rc[num],rc[x],k-t);

     dat[num]=dat[lc[num]]+dat[rc[num]];

     dat[x]=dat[lc[x]]+dat[rc[x]];

 }

 int merge(/*int l,int r,*/int num,int x)

 //将x和num并起来

 {

     if(!x||!num)    return x+num;

     //if(l==r)    {dat[num]+=dat[x];delnode(x);return;}

     lc[num]=merge(lc[num],lc[x]);

     rc[num]=merge(rc[num],rc[x]);

     dat[num]+=dat[x];

     delnode(x);

     return num;

 //    if(!lc[num]||!lc[x])    lc[num]=lc[num]+lc[x];

 //    else    merge(l,mid,lc[num],lc[x]);

 //    if(!rc[num]||!rc[x])    rc[num]=rc[num]+rc[x];

 //    else    merge(mid+1,r,rc[num],rc[x]);

 //    dat[num]=dat[lc[num]]+dat[rc[num]];

 //    delnode(x);

 }

 int _query_kth(int l,int r,int k,int num)

 {

     if(l==r)    return l;

     if(dat[lc[num]]>=k)    return _query_kth(l,mid,k,lc[num]);

     else    return _query_kth(mid+,r,k-dat[lc[num]],rc[num]);

 }

 int query_kth(int k,int num)

 {

     return _query_kth(,n,k,num);

 }

 #undef mid

 }

 struct Dat

 {

     int r,l,nd,type;//type=0升序,type=1降序

 };

 bool operator<(const Dat &a,const Dat &b)

 {

     return a.r<b.r||(a.r==b.r&&a.l<b.l);

 }

 set<Dat> s;

 int split_node(int l,int r)

 {

     int ansn=,tn;Dat t;

     auto it=s.lower_bound((Dat){l,,,});

     if(it->l!=l)

     {

         t=*it;s.erase(it);tn=;

         if(t.type==)

         {

             SegT::split(,n,t.nd,tn,l-t.l);

             s.insert((Dat){l-,t.l,tn,});

             //ansn=SegT::merge(ansn,t.nd);

             s.insert((Dat){t.r,l,t.nd,});

         }

         else

         {

             SegT::split(,n,t.nd,tn,t.r-l+);

             s.insert((Dat){l-,t.l,t.nd,});

             //ansn=SegT::merge(ansn,tn);

             s.insert((Dat){t.r,l,tn,});

         }

     }

     it=s.lower_bound((Dat){r,,,});

     if(it->r!=r)

     {

         t=*it;s.erase(it);tn=;

         if(t.type==)

         {

             SegT::split(,n,t.nd,tn,r-t.l+);

             s.insert((Dat){t.r,r+,t.nd,});

             //ansn=SegT::merge(ansn,tn);

             s.insert((Dat){r,t.l,tn,});

         }

         else

         {

             SegT::split(,n,t.nd,tn,t.r-r);

             s.insert((Dat){t.r,r+,tn,});

             //ansn=SegT::merge(ansn,t.nd);

             s.insert((Dat){r,t.l,t.nd,});

         }

     }

     while()

     {

         it=s.lower_bound((Dat){l,,,});

         if(it==s.end()||it->l>r)    break;

         t=*it;s.erase(it);

         ansn=SegT::merge(ansn,t.nd);

     }

     return ansn;

 }

 //void out()

 //{

 //    for(auto i : s)

 //    {

 //        printf("a%d %d %d %d\n",i.r,i.l,i.nd,i.type);

 //    }

 //}

 int main()

 {

     SegT::init();

     int t,t2,i,idx,l,r,q;

     scanf("%d%d",&n,&m);

     for(i=;i<=n;i++)

     {

         scanf("%d",&t);

         t2=SegT::getnode();

         SegT::addx(t,t2);

         s.insert((Dat){i,i,t2,});

     }

     while(m--)

     {

         scanf("%d%d%d",&idx,&l,&r);

         t=split_node(l,r);

         s.insert((Dat){r,l,t,idx});

     }

     scanf("%d",&q);

     t=split_node(q,q);

     printf("%d",SegT::query_kth(,t));

     return ;

 }
删了一些奇怪调试代码之后的代码:
 #pragma GCC optimize("Ofast")

 #pragma GCC optimize("inline","fast-math","unroll-loops","no-stack-protector")

 #pragma GCC diagnostic error "-fwhole-program"

 #pragma GCC diagnostic error "-fcse-skip-blocks"

 #pragma GCC diagnostic error "-funsafe-loop-optimizations"

 #pragma GCC diagnostic error "-std=c++14"

 #include<cstdio>

 #include<algorithm>

 #include<set>

 using namespace std;

 int n,m;

 namespace SegT

 {

 const int N=;

 int lc[N],rc[N],dat[N];

 int st[N+];int top;

 void init()    {for(int i=N-;i>=;i--)st[++top]=i;}

 int getnode()    {int t=st[top--];lc[t]=rc[t]=dat[t]=;return t;}

 void delnode(int x)    {st[++top]=x;}

 #define mid (l+((r-l)>>1))

 int L,x;

 void _addx(int l,int r,int &num)

 {

     if(!num)    num=getnode();

     if(l==r)    {dat[num]+=x;return;}

     if(L<=mid)    _addx(l,mid,lc[num]);

     else    _addx(mid+,r,rc[num]);

     dat[num]=dat[lc[num]]+dat[rc[num]];

 }

 void addx(int pos,int &num)    {L=pos;x=;_addx(,n,num);}

 void split(int l,int r,int &num,int &x,int k)

 //当前区间为[l,r],将num中的前k小拆出来,放到x中

 {

     if(!k)    return;

     if(!x)    x=getnode();

     if(l==r)    {dat[num]-=k;dat[x]+=k;return;}

     int t=dat[lc[num]];

     if(t>k)    split(l,mid,lc[num],lc[x],k);

     else    lc[x]=lc[num],lc[num]=;

     if(t<k)    split(mid+,r,rc[num],rc[x],k-t);

     dat[num]=dat[lc[num]]+dat[rc[num]];

     dat[x]=dat[lc[x]]+dat[rc[x]];

 }

 int merge(int num,int x)

 //将x和num并起来

 {

     if(!x||!num)    return x+num;

     //if(l==r)    {dat[num]+=dat[x];delnode(x);return;}//不用判的

     lc[num]=merge(lc[num],lc[x]);

     rc[num]=merge(rc[num],rc[x]);

     dat[num]+=dat[x];

     delnode(x);

     return num;

 }

 int _query_kth(int l,int r,int k,int num)

 {

     if(l==r)    return l;

     if(dat[lc[num]]>=k)    return _query_kth(l,mid,k,lc[num]);

     else    return _query_kth(mid+,r,k-dat[lc[num]],rc[num]);

 }

 int query_kth(int k,int num)

 {

     return _query_kth(,n,k,num);

 }

 #undef mid

 }

 struct Dat

 {

     int r,l,nd,type;//type=0升序,type=1降序

 };

 bool operator<(const Dat &a,const Dat &b)

 {

     return a.r<b.r||(a.r==b.r&&a.l<b.l);

 }

 set<Dat> s;

 int split_node(int l,int r)

 {

     int ansn=,tn;Dat t;

     auto it=s.lower_bound((Dat){l,,,});

     if(it->l!=l)

     {

         t=*it;s.erase(it);tn=;

         if(t.type==)

         {

             SegT::split(,n,t.nd,tn,l-t.l);

             s.insert((Dat){l-,t.l,tn,});

             s.insert((Dat){t.r,l,t.nd,});

         }

         else

         {

             SegT::split(,n,t.nd,tn,t.r-l+);

             s.insert((Dat){l-,t.l,t.nd,});

             s.insert((Dat){t.r,l,tn,});

         }

     }

     it=s.lower_bound((Dat){r,,,});

     if(it->r!=r)

     {

         t=*it;s.erase(it);tn=;

         if(t.type==)

         {

             SegT::split(,n,t.nd,tn,r-t.l+);

             s.insert((Dat){t.r,r+,t.nd,});

             s.insert((Dat){r,t.l,tn,});

         }

         else

         {

             SegT::split(,n,t.nd,tn,t.r-r);

             s.insert((Dat){t.r,r+,tn,});

             s.insert((Dat){r,t.l,t.nd,});

         }

     }

     while()

     {

         it=s.lower_bound((Dat){l,,,});

         if(it==s.end()||it->l>r)    break;

         t=*it;s.erase(it);

         ansn=SegT::merge(ansn,t.nd);

     }

     return ansn;

 }

 int main()

 {

     SegT::init();

     int t,t2,i,idx,l,r,q;

     scanf("%d%d",&n,&m);

     for(i=;i<=n;i++)

     {

         scanf("%d",&t);

         t2=SegT::getnode();

         SegT::addx(t,t2);

         s.insert((Dat){i,i,t2,});

     }

     while(m--)

     {

         scanf("%d%d%d",&idx,&l,&r);

         t=split_node(l,r);

         s.insert((Dat){r,l,t,idx});

     }

     scanf("%d",&q);

     t=split_node(q,q);

     printf("%d",SegT::query_kth(,t));

     return ;

 }
洛谷 P2824 [HEOI2016/TJOI2016]排序 (线段树合并)的更多相关文章
- 洛谷$P2824\ [HEOI2016/TJOI2016]$ 排序 线段树+二分
正解:线段树+二分 解题报告: 传送门$QwQ$ 昂着题好神噢我$jio$得$QwQQQQQ$,,, 开始看到长得很像之前考试题的亚子,,,然后仔细康康发现不一样昂$kk$,就这里范围是$[1,n]$ ...
- 洛谷 P2824 [HEOI2016/TJOI2016]排序 解题报告
P2824 [HEOI2016/TJOI2016]排序 题意: 有一个长度为\(n\)的1-n的排列\(m\)次操作 \((0,l,r)\)表示序列从\(l\)到\(r\)降序 \((1,l,r)\) ...
- [Luogu P2824] [HEOI2016/TJOI2016]排序 (线段树+二分答案)
题面 传送门:https://www.luogu.org/problemnew/show/P2824 Solution 这题极其巧妙. 首先,如果直接做m次排序,显然会T得起飞. 注意一点:我们只需要 ...
- BZOJ.4552.[HEOI2016/TJOI2016]排序(线段树合并/二分 线段树)
题目链接 对于序列上每一段连续区间的数我们都可以动态开点建一棵值域线段树.初始时就是\(n\)棵. 对于每次操作,我们可以将\([l,r]\)的数分别从之前它所属的若干段区间中分离出来,合并. 对于升 ...
- 洛谷P2824 [HEOI2016/TJOI2016]排序(线段树)
传送门 这题的思路好清奇 因为只有一次查询,我们考虑二分这个值为多少 将原序列转化为一个$01$序列,如果原序列上的值大于$mid$则为$1$否则为$0$ 那么排序就可以用线段树优化,设该区间内$1$ ...
- [洛谷P2824][HEOI2016/TJOI2016]排序
题目大意:一个全排列,两种操作: 1. $0\;l\;r:$把$[l,r]$升序排序2. $1\;l\;r:$把$[l,r]$降序排序 最后询问第$k$位是什么 题解:二分答案,把比这个数大的赋成$1 ...
- Luogu P2824 [HEOI2016/TJOI2016]排序 线段树+脑子
只会两个$log$的$qwq$ 我们二分答案:设答案为$ans$,则我们把$a[i]<=ans$全部设成$0$,把$a[i]>ans$全部设成$1$,扔到线段树里,这样区间排序(升序)就是 ...
- day 1 晚上 P2824 [HEOI2016/TJOI2016]排序 线段树
#include<iostream> #include<cstdio> #include<cstdlib> #include<cmath> #inclu ...
- [HEOI2016/TJOI2016]排序 线段树+二分
[HEOI2016/TJOI2016]排序 内存限制:256 MiB 时间限制:6000 ms 标准输入输出 题目类型:传统 评测方式:文本比较 题目描述 在2016年,佳媛姐姐喜欢上了数字序列.因而 ...
随机推荐
- 搜索学术论文訪问google的能用的几个IP地址
google搜索引擎打不开时的解决的方法,谷歌(google)的IP是多少? google IP镜像. 这里搜集了几个经过測试可用的IP,用来在不能域名訪问google的时候进行訪问 更新一个最新的. ...
- leetcode:238. Product of Array Except Self(Java)解答
转载请注明出处:z_zhaojun的博客 原文地址 题目地址 Product of Array Except Self Given an array of n integers where n > ...
- iOS 浅谈MVC设计模式及Controllers之间的传值方式
1.简述你对MVC的理解? MVC是一种架构设计.它考虑了三种对象:Model(模型对象).View(试图对象).Controller(试图控制器) (1)模型:负责存储.定义.操作数据 (2)视图: ...
- 【iOS系列】-触摸事件与手势识别
[iOS系列]-触摸事件与手势识别 第一:触摸事件 一根手指触摸屏幕时,会创建一个与手指相关联的UITouch对象 UIEvent:称为事件对象,记录事件产生的时刻和类型 两根手指同时触摸一个view ...
- JAVA学习(七):方法重载与方法重写、thiskeyword和superkeyword
方法重载与方法重写.thiskeyword和superkeyword 1.方法重载 重载可以使具有同样名称但不同数目和类型參数的类传递给方法. 注: 一是重载方法的參数列表必须与被重载的方法不同,而且 ...
- 将最大主机/ DNS名称字符长度从63增加到255
https://mp.weixin.qq.com/s/WcjaAgAOvEhjtP2nXx5Fhw Zabbix 4.0.0alpha8发行说明 运维帮 昨天 Zabbix团队很高兴地宣布Zabbix ...
- /dev/zero和/dev/null的区别
http://www.cnblogs.com/jacktu/archive/2010/06/28/1766791.html /dev/zero和/dev/null的区别 使用/dev/null 把 ...
- 深入研究java.lang.Object类
前言:Java的类库日益庞大.所包括的类和接口也不计其数.但当中有一些非常重要的类和接口,是Java类库中的核心部分.常见的有String.Object.Class.Collection.ClassL ...
- nextLine() 、nextInt()的跳过问题
nextInt() 将输入的信息的下一个标记扫描为 int. nextLine() 此扫描器执行当前行,并返回跳过的输入信息. nextInt 会读取下面输入的 int类型的信息以回车作为结束,如果 ...
- jetty与tomcat
相同点: 1.tomcat与jetty都是一种servlet引擎,他们都支持标准的servlet规范和javaEE规范 不同点: 1.架构比较 jetty相比tomcat更为简单 jetty架构是基于 ...