
目标检测网络之 R-FCN
R-FCN 原理
R-FCN作者指出在图片分类网络中具有平移不变性(translation invariance),而目标在图片中的位置也并不影响分类结果;但是检测网络对目标的位置比较敏感.因此Faster R-CNN将ROI的特征提取操作放在了最后分类网络中间(靠后的位置)打破分类网络的平移不变性,而不能直接放在网络的末尾.但是这样存在的问题是ROI特征提取不共享计算,导致计算量较大.
一般来讲,网络越深,其具有的平移旋转不变性越强,这个性质对于保证分类模型的鲁棒性有积极意义。然而,在检测问题中,对物体的定位任务要求模型对位置信息有良好的感知能力,过度的平移旋转不变性会削弱这一性能。研究发现,对于较深的全卷积神经网络(Inception、ResNet 等),Faster-RCNN检测框架存在着一个明显的缺陷:检测器对物体的位置信息的敏感度下降,检测准确度降低。一般来讲最直观的解决方法是将RPN的位置向浅层移动(比如在ResNet中将RPN嵌入到conv4_x的位置),但这样做会明显增加 Fast-RCNN 部分的计算量,使得检测速度明显变慢。[1]
R-FCN正是为了解决这一问题,其采用巧妙的方式将ROI的计算部分共享,减轻了头部的大小(后来出现的Light-head R-CNN更进一步).在VOC2007测试集上mAP达83.6%,比Faster R-CNN有所提升.同时速度提高2.5~20倍.
为了引入平移敏感性,作者在全卷积网络的最后层之后添加了一个1x1卷积层输出position-sensitive score map.每张score map中存放的是所有目标的某一部位的特征图.每个目标被分成\(k\times k\)个网格区域(同Faster R-CNN的ROIPooling的参数,k通常取7或14等. score map的数量设置为\(k^2(C+1)\),对应ROI的\(k\times k\)个bin的特征图.示意图如下:
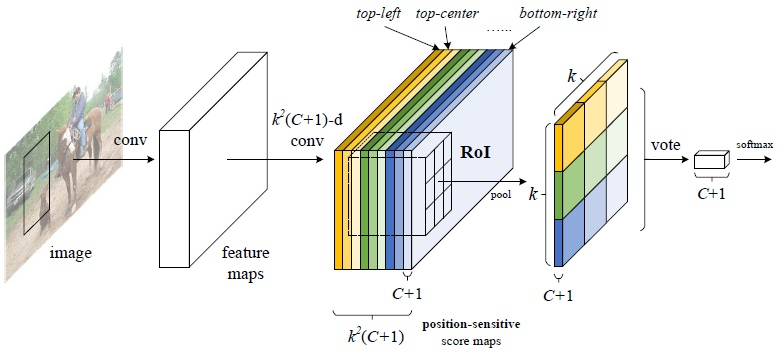
在位置敏感特征图之后接上Position-sensitive RoI pooling:
输入特征图上的第(i,j)个bin位置的值为第(i,j)个score map上该bin对应位置的均值(这里采用了average pooling 的过程,当然用 max pooling 也可以),这样得到一个通道数为C+1的\(k\times k\)大小的特征图对应C+1个类别的得分,对每个类别的得分求和(或求平均)作为每个类别的score,然后通过softmax得到最大值对应的类别作为输出.
所谓"位置敏感",其主要思想是在特征聚集时人工引入位置信息,从而有效改善较深的神经网络对物体位置信息的敏感程度。
position-sensitive regression
与Faster R-CNN类似,接上与position-sensitive score map并列的回归层(1x1卷积,输出(bg/fg)x(dx, dy, dw, dh)x(score_maps_size^2)),在经过RoI pooling后每一个RoI会得到 4 个偏移量(这里在实现时还分背景/前景,所以是8个数值)。
计算速度提升: PSROI Pooling通过对ROI共享特征图的方式, 以及通过用全局平均池化代替全连接层进行分类特征提取, 提高了计算速度.
在该网络框架下,所有可学习的层,都是卷积形式,在训练时可以很方便地进行 Online Hard Example Mining (OHEM, 在线难样本挖掘) ,几乎不会增加训练时间。[2] 相比之下OHEM Fast R-CNN方法会使训练时间加倍(A. Shrivastava, A. Gupta, and R. Girshick. Training region-based object detectors with online hard example mining. In CVPR, 2016.).
损失函数
分类的softmax损失加前景目标的回归损失.
分类
R-FCN分类分支中支持两种不同的方法: 类敏感和类无关: class-aware and agnostic, 这两者的区别: [3]
class-agnostic 方法对每个目标框输出8个数值(2类fg/bg x 4坐标), 而class-aware输出(cls+1)x4个.agnostic 方法占用内存更少,运行速度更快. mAP跟训练有关,可能会有些差别.
class-agnostic 方法通常作为预处理器,后边需要接上分类器进一步对目标框进行分类.
Atrous 技巧
作者将最后1个池化层的步长从2减小到1,那么图像将从缩小32倍变成只缩小16倍,这样就提高了共享卷积层的输出分辨率。而这样做就要使用Atrous Convolution算法,具体参见论文Semantic Image Segmentation With Deep Convolutional Nets and Fully Connnected CRFS
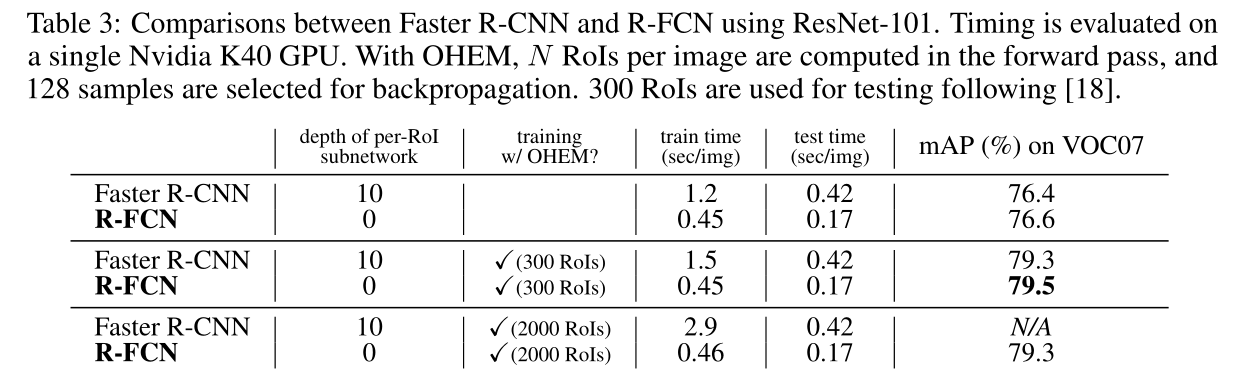
实验结果,通过下表可以看出训练时RPN产生300个ROI, 结果就已经足够好,沿用Faster R-CNN的2000的设置,反而有所下降. 另外可看出OHEM可以将结果提高3个百分点, 并且使用 OHEM 不会给训练带来额外的时间消耗.
R-FCN C++版
R-FCN C++版代码取自原作者的官方PR: Microsoft/caffe/pull/107 ,
我将其集成到了我的C++版目标检测caffe框架中: https://github.com/makefile/frcnn
RFCN OHEM 代码理解
训练时在前向传播得到所有N个proposal的loss,从大到小排序后选择前B个ROI进行反向传播,其它的则忽略.而测试时和原来一样,不做改变. 核心实现为BoxAnnotatorOHEM层, 使用方式如下:
layer {

   bottom: "rois"

   bottom: "per_roi_loss"

   bottom: "labels"

   bottom: "bbox_inside_weights"

   top: "labels_ohem"

   top: "bbox_loss_weights_ohem"

   name: "annotator_detector"

   type: "BoxAnnotatorOHEM"

   box_annotator_ohem_param {

        roi_per_img: 128

        ignore_label: -1

   }

   propagate_down: false

   propagate_down: false

   propagate_down: false

   propagate_down: false

}
注意到bottom里边有个per_roi_loss 是每个roi的loss(SmoothL1Loss+SoftmaxWithLoss), 参数roi_per_img表示最大的 top N 个 RoI 用于反向传播。 实现中使用std::sort(sorted_idx.begin(), sorted_idx.end(), [bottom_loss](int i1, int i2){return bottom_loss[i1] > bottom_loss[i2]; });对loss值排序取前roi_per_img个作为输出, 而其它roi被设置成被忽略的label(ignore_label=-1)和loss_weight=0.
另外,在设置上OHEM的一个区别是将bg_thresh_lo 设置为0, 不使用OHEM时设置为0.1(正样本周围的负样本,这也算是一种简单的难样本挖掘方式,但是设置为0.1可能导致没有样本被选中,因此也可以设置成0). 将bg_thresh_lo 设置为0使得可以从更宽泛的样本中选择难样本.
目标检测网络之 R-FCN的更多相关文章
- 目标检测网络之 Mask R-CNN
Mask R-CNN 论文Mask R-CNN(ICCV 2017, Kaiming He,Georgia Gkioxari,Piotr Dollár,Ross Girshick, arXiv:170 ...
- 目标检测网络之 YOLOv2
YOLOv1基本思想 YOLO将输入图像分成SxS个格子,若某个物体 Ground truth 的中心位置的坐标落入到某个格子,那么这个格子就负责检测出这个物体. 每个格子预测B个bounding b ...
- 目标检测网络之 YOLOv3
本文逐步介绍YOLO v1~v3的设计历程. YOLOv1基本思想 YOLO将输入图像分成SxS个格子,若某个物体 Ground truth 的中心位置的坐标落入到某个格子,那么这个格子就负责检测出这 ...
- 使用Caffe完成图像目标检测 和 caffe 全卷积网络
一.[用Python学习Caffe]2. 使用Caffe完成图像目标检测 标签: pythoncaffe深度学习目标检测ssd 2017-06-22 22:08 207人阅读 评论(0) 收藏 举报 ...
- 目标检测之R-CNN系列
Object Detection,在给定的图像中,找到目标图像的位置,并标注出来. 或者是,图像中有那些目标,目标的位置在那.这个目标,是限定在数据集中包含的目标种类,比如数据集中有两种目标:狗,猫. ...
- 目标检测(四)Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks
作者:Shaoqing Ren, Kaiming He, Ross Girshick, and Jian Sun SPPnet.Fast R-CNN等目标检测算法已经大幅降低了目标检测网络的运行时间. ...
- 目标检测-Faster R-CNN
[目标检测]Faster RCNN算法详解 Ren, Shaoqing, et al. “Faster R-CNN: Towards real-time object detection with r ...
- 深度学习笔记之目标检测算法系列(包括RCNN、Fast RCNN、Faster RCNN和SSD)
不多说,直接上干货! 本文一系列目标检测算法:RCNN, Fast RCNN, Faster RCNN代表当下目标检测的前沿水平,在github都给出了基于Caffe的源码. • RCNN RCN ...
- 【目标检测】SSD:
slides 讲得是相当清楚了: http://www.cs.unc.edu/~wliu/papers/ssd_eccv2016_slide.pdf 配合中文翻译来看: https://www.cnb ...
随机推荐
- vue element-ui 动态上传
上传填写完毕的幼儿及体测数据文件,上传成功后会自动导入该文件的数据 <el-upload :action="UploadUrl()" :on-success="Up ...
- HashMap和HashTable区别【转载】
今天看到的HashMap和HashTable区别介绍,收藏留着学习. 出处:http://www.importnew.com/24822.html 代码版本 JDK每一版本都在改进.本文讨论的Hash ...
- 【Beta阶段】第九次Scrum Meeting!(论坛已成功上线)
每日任务内容: 本次会议为第九次Scrum Meeting会议~ 本次会议为团队项目第九次会议,在会议前大家取得了重大成果! 队员 昨日完成任务 明日要完成任务 刘乾 #179 完成1021的数据处理 ...
- Linux内核分析— —创建新进程的过程
分析Linux内核创建一个新进程的过程 实验过程 要求:使用gdb跟踪分析一个fork系统调用内核处理函数sys_clone ,验证对Linux系统创建一个新进程的理解,推荐在实验楼Linux虚拟机环 ...
- 《Linux内核分析》第八周:进程的切换和系统的一般执行过程
杨舒雯(原创作品转载请注明出处) <Linux内核分析>MOOC课程http://mooc.study.163.com/course/USTC-1000029000 实验目的: 使用gdb ...
- Cocos2d-x项目创建方式
刚接触cocos2d-x的时候,还只有2.x版本,尝试着将cocos2d-x项目创建功能加入到vs里面去,后来,引擎用Python封装好了好多个脚本文件,其中就包括create_project.py文 ...
- suqid透明正向代理
如果想实现透明正向代理,则必需将用户的网关IP指向 Squid 服务器,而此后便无需再修改浏览器选项 在命令行 <菜单+R> 中使用 ping 命令: ping www.baidu.c ...
- Spring基础之 反射(Reflection)
1.了解Class package com.inspire.reflection.Class_api; import java.lang.reflect.Constructor; import jav ...
- [转帖新闻]Windows 7时代即将终结:曾有多辉煌 如今就有多凄凉
Windows 7时代即将终结:曾有多辉煌 如今就有多凄凉 投递人 itwriter 发布于 2019-01-18 10:47 评论(4) 有834人阅读 [收藏] « » 文/屠敏 来源:CSDN( ...
- Linux基础学习(9)--文件系统管理
第九章——文件系统管理 一.回顾分区和文件系统 1.分区类型: 2.分区表示方法: 3.文件系统: 二.文件系统常用命令 1.df命令.du命令.fsck命令和dump2fs命令: (1)文件系统查看 ...