
Python3网络爬虫(四):使用User Agent和代理IP隐藏身份《转》
运行平台:Windows
Python版本:Python3.x
IDE:Sublime text3
转载请注明作者和出处:http://blog.csdn.net/c406495762/article/details/60137956
一、为何要设置User Agent
有一些网站不喜欢被爬虫程序访问,所以会检测连接对象,如果是爬虫程序,也就是非人点击访问,它就会不让你继续访问,所以为了要让程序可以正常运行,需要隐藏自己的爬虫程序的身份。此时,我们就可以通过设置User Agent的来达到隐藏身份的目的,User Agent的中文名为用户代理,简称UA。
User Agent存放于Headers中,服务器就是通过查看Headers中的User Agent来判断是谁在访问。在Python中,如果不设置User Agent,程序将使用默认的参数,那么这个User Agent就会有Python的字样,如果服务器检查User Agent,那么没有设置User Agent的Python程序将无法正常访问网站。
Python允许我们修改这个User Agent来模拟浏览器访问,它的强大毋庸置疑。
二、常见的User Agent
1.Android
- Mozilla/5.0 (Linux; Android 4.1.1; Nexus 7 Build/JRO03D) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.166 Safari/535.19
- Mozilla/5.0 (Linux; U; Android 4.0.4; en-gb; GT-I9300 Build/IMM76D) AppleWebKit/534.30 (KHTML, like Gecko) Version/4.0 Mobile Safari/534.30
- Mozilla/5.0 (Linux; U; Android 2.2; en-gb; GT-P1000 Build/FROYO) AppleWebKit/533.1 (KHTML, like Gecko) Version/4.0 Mobile Safari/533.1
2.Firefox
- Mozilla/5.0 (Windows NT 6.2; WOW64; rv:21.0) Gecko/20100101 Firefox/21.0
- Mozilla/5.0 (Android; Mobile; rv:14.0) Gecko/14.0 Firefox/14.0
3.Google Chrome
- Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/27.0.1453.94 Safari/537.36
- Mozilla/5.0 (Linux; Android 4.0.4; Galaxy Nexus Build/IMM76B) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.133 Mobile Safari/535.19
4.iOS
- Mozilla/5.0 (iPad; CPU OS 5_0 like Mac OS X) AppleWebKit/534.46 (KHTML, like Gecko) Version/5.1 Mobile/9A334 Safari/7534.48.3
- Mozilla/5.0 (iPod; U; CPU like Mac OS X; en) AppleWebKit/420.1 (KHTML, like Gecko) Version/3.0 Mobile/3A101a Safari/419.3
上面列举了Andriod、Firefox、Google Chrome、iOS的一些User Agent,直接copy就能用。
三、设置User Agent的方法
先看下urllib.request.Request()
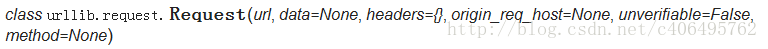
从上图可以看出,在创建Request对象的时候,可以传入headers参数。
因此,想要设置User Agent,有两种方法:
1.在创建Request对象的时候,填入headers参数(包含User Agent信息),这个Headers参数要求为字典;
2.在创建Request对象的时候不添加headers参数,在创建完成之后,使用add_header()的方法,添加headers。
方法一:
创建文件urllib_test09.py,使用上面提到的Android的第一个User Agent,在创建Request对象的时候传入headers参数,编写代码如下:
# -*- coding: UTF-8 -*-

from urllib import request

if __name__ == "__main__":

    #以CSDN为例,CSDN不更改User Agent是无法访问的

    url = 'http://www.csdn.net/'

    head = {}

    #写入User Agent信息

    head['User-Agent'] = 'Mozilla/5.0 (Linux; Android 4.1.1; Nexus 7 Build/JRO03D) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.166  Safari/535.19'

 #创建Request对象

    req = request.Request(url, headers=head)

    #传入创建好的Request对象

    response = request.urlopen(req)

    #读取响应信息并解码

    html = response.read().decode('utf-8')

    #打印信息

print(html)- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
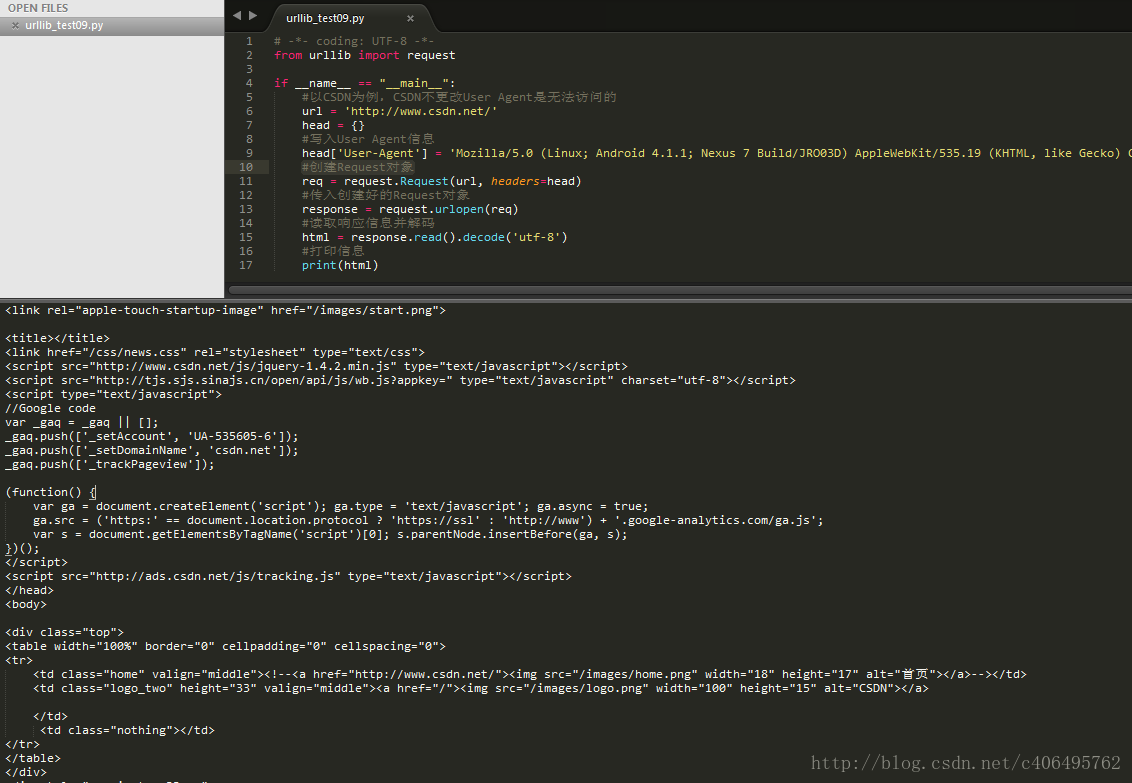
运行结果如下:
方法二:
创建文件urllib_test10.py,使用上面提到的Android的第一个User Agent,在创建Request对象时不传入headers参数,创建之后使用add_header()方法,添加headers,编写代码如下:
# -*- coding: UTF-8 -*-

from urllib import request

if __name__ == "__main__":

    #以CSDN为例,CSDN不更改User Agent是无法访问的

    url = 'http://www.csdn.net/'

    #创建Request对象

    req = request.Request(url)

    #传入headers

    req.add_header('User-Agent', 'Mozilla/5.0 (Linux; Android 4.1.1; Nexus 7 Build/JRO03D) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.166  Safari/535.19')

    #传入创建好的Request对象

    response = request.urlopen(req)

    #读取响应信息并解码

    html = response.read().decode('utf-8')

    #打印信息

print(html)- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
运行结果和上一个方法是一样的。
四、IP代理的使用
1.为何使用IP代理
User Agent已经设置好了,但是还应该考虑一个问题,程序的运行速度是很快的,如果我们利用一个爬虫程序在网站爬取东西,一个固定IP的访问频率就会很高,这不符合人为操作的标准,因为人操作不可能在几ms内,进行如此频繁的访问。所以一些网站会设置一个IP访问频率的阈值,如果一个IP访问频率超过这个阈值,说明这个不是人在访问,而是一个爬虫程序。
2.一般步骤说明
一个很简单的解决办法就是设置延时,但是这显然不符合爬虫快速爬取信息的目的,所以另一种更好的方法就是使用IP代理。使用代理的步骤:
(1)调用urlib.request.ProxyHandler(),proxies参数为一个字典。
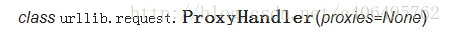
(2)创建Opener(类似于urlopen,这个代开方式是我们自己定制的)
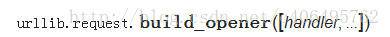
(3)安装Opener
使用install_opener方法之后,会将程序默认的urlopen方法替换掉。也就是说,如果使用install_opener之后,在该文件中,再次调用urlopen会使用自己创建好的opener。如果不想替换掉,只是想临时使用一下,可以使用opener.open(url),这样就不会对程序默认的urlopen有影响。
3.代理IP选取
在写代码之前,先在代理IP网站选好一个IP地址,推荐西刺代理IP。
注意:当然也可以写个正则表达式从网站直接爬取IP,但是要记住不要太频繁爬取,加个延时什么的,太频繁给服务器带来压力了,服务器会直接把你block,不让你访问的,我就被封了两天。
从西刺网站选出信号好的IP,我的选择如下:(106.46.136.112:808)
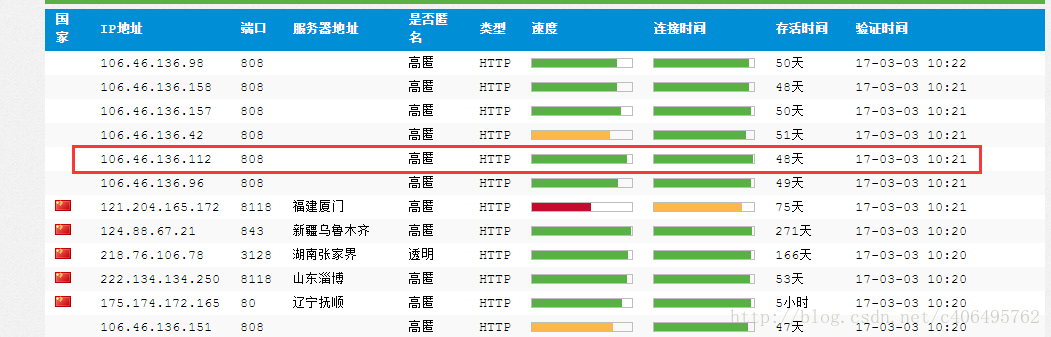
编写代码访问http://www.whatismyip.com.tw/,该网站是测试自己IP为多少的网址,服务器会返回访问者的IP。
4.代码实例
创建文件urllib_test11.py,编写代码如下:
# -*- coding: UTF-8 -*-

from urllib import request

if __name__ == "__main__":

    #访问网址

    url = 'http://www.whatismyip.com.tw/'

    #这是代理IP

    proxy = {'http':'106.46.136.112:808'}

    #创建ProxyHandler

    proxy_support = request.ProxyHandler(proxy)

    #创建Opener

    opener = request.build_opener(proxy_support)

    #添加User Angent

    opener.addheaders = [('User-Agent','Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36')]

    #安装OPener

    request.install_opener(opener)

    #使用自己安装好的Opener

    response = request.urlopen(url)

    #读取相应信息并解码

    html = response.read().decode("utf-8")

    #打印信息

print(html)- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
运行结果如下:
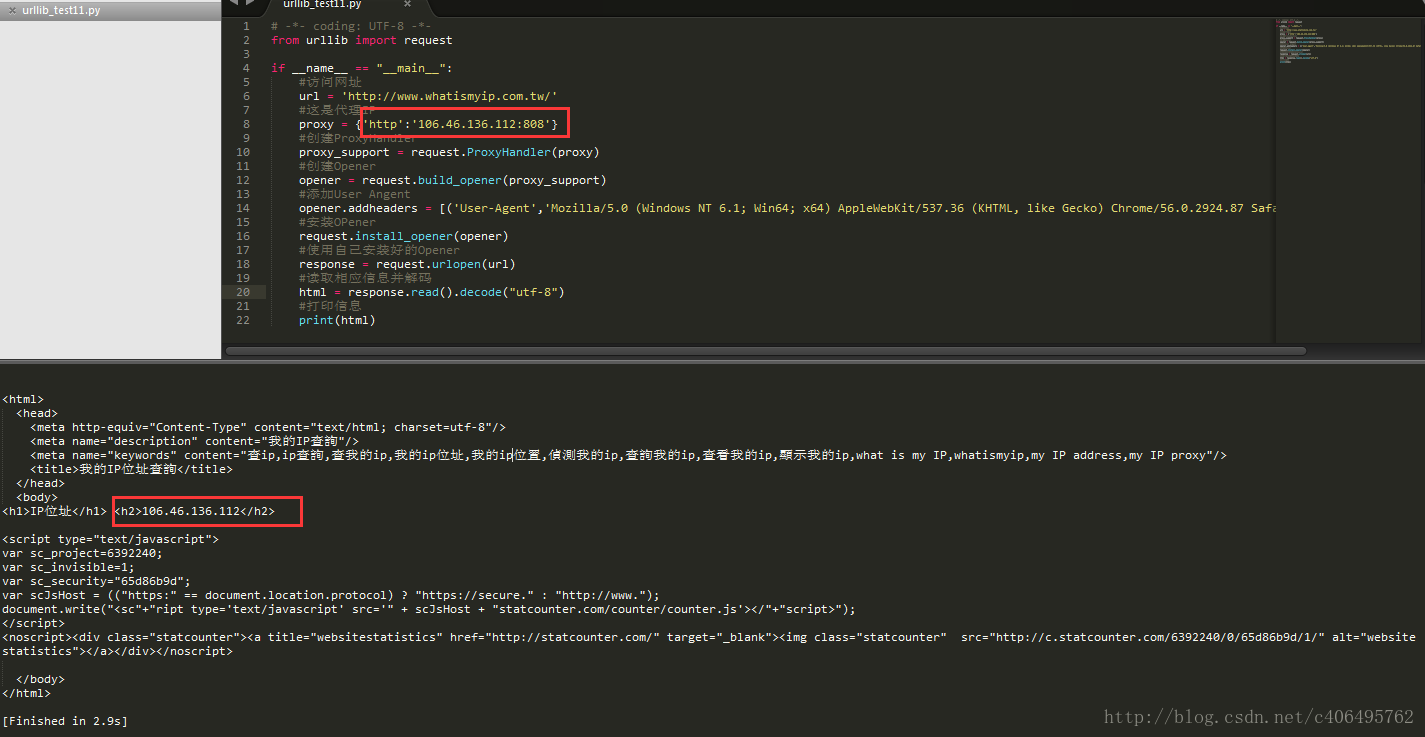
从上图可以看出,访问的IP已经伪装成了106.46.136.112。


Python3网络爬虫(四):使用User Agent和代理IP隐藏身份《转》的更多相关文章
- 使用User Agent和代理IP隐藏身份
一.为何要设置User Agent 有一些网站不喜欢被爬虫程序访问,所以会检测连接对象,如果是爬虫程序,也就是非人点击访问,它就会不让你继续访问,所以为了要让程序可以正常运行,需要隐藏自己的爬虫程序的 ...
- Python3网络爬虫(3):使用User Agent和代理IP隐藏身份
Python版本: python3 IDE: pycharm2017.3.3 一.为何要设置User Agent 有一些网站不喜欢被爬虫访问,所以会检测对象,如果是爬虫程序,他就会不让你访问,通过设置 ...
- 元类理解与元类编程 《Python3网络爬虫开发》中第九章代理的使用代码Crawler中代码的理解
__new__与__init__的理解 __new__()方法是在创建实例之前被调用的,它的作用是创建一个实例,然后返回该实例对象,它是一个静态方法. __init__() 当实例被创建完成之后被调用 ...
- Python3 网络爬虫(请求库的安装)
Python3 网络爬虫(请求库的安装) 爬虫可以简单分为几步:抓取页面,分析页面和存储数据 在页面爬取的过程中我们需要模拟浏览器向服务器发送请求,所以需要用到一些python库来实现HTTP的请求操 ...
- 崔庆才Python3网络爬虫开发实战电子版书籍分享
资料下载地址: 链接:https://pan.baidu.com/s/1WV-_XHZvYIedsC1GJ1hOtw 提取码:4o94 <崔庆才Python3网络爬虫开发实战>高清中文版P ...
- 《Python3 网络爬虫开发实战》开发环境配置过程中踩过的坑
<Python3 网络爬虫开发实战>学习资料:https://www.cnblogs.com/waiwai14/p/11698175.html 如何从墙内下载Android Studio: ...
- 《Python3 网络爬虫开发实战》学习资料
<Python3 网络爬虫开发实战> 学习资料 百度网盘:https://pan.baidu.com/s/1PisddjC9e60TXlCFMgVjrQ
- Python3网络爬虫开发实战PDF高清完整版免费下载|百度云盘
百度云盘:Python3网络爬虫开发实战高清完整版免费下载 提取码:d03u 内容简介 本书介绍了如何利用Python 3开发网络爬虫,书中首先介绍了环境配置和基础知识,然后讨论了urllib.req ...
- 转:【Python3网络爬虫开发实战】 requests基本用法
1. 准备工作 在开始之前,请确保已经正确安装好了requests库.如果没有安装,可以参考1.2.1节安装. 2. 实例引入 urllib库中的urlopen()方法实际上是以GET方式请求网页,而 ...
随机推荐
- hdu多校第3场C. Dynamic Graph Matching
Problem C. Dynamic Graph Matching Time Limit: / MS (Java/Others) Memory Limit: / K (Java/Others) Tot ...
- 网站压力测试工具http_load的安装与使用
一.安装 1.下载地址:http://www.acme.com/software/http_load/http_load-09Mar2016.tar.gz 2.解压后进入目录,执行make & ...
- 跟随我在oracle学习php(5)
框架(把一个页面引入当前页面 易维护 扩展 复用)<iframe src=”” frameborder=“”> 格式:iframe <frameset> <frame&g ...
- centos下redis安全相关
博文背景: 由于发现众多同学,在使用云服务器时,安装的redis3.0+版本都关闭了protected-mode,因而都遭遇了挖矿病毒的攻击,使得服务器99%的占用率!! 因此我们在使用redis时候 ...
- E: Sub-process /usr/bin/dpkg returned an error code (1)错误解决
在用apt-get安装软件时出现了类似于install-info: No dir file specified; try --help for more information.dpkg:处理 get ...
- [Java复习] 复习知识点
将线程转换为守护线程可以通过调用Thread对象的setDaemon(true)方法来实现. String 被设计成不可变(immutable)类, 所以它的所有对象都是不可变对象. 要被序列化的实例 ...
- ceph集群性能测试结果
对ceph存储集群(8台万兆服务器)从以下几个方面进行测试的结果 1.读写稳定性 无故障下的ceph集群性能完全满足业务对磁盘性能的需求. 测试数据结果如下表1-1,1-2 2.业务稳定性 ceph集 ...
- 学习Hibenate随笔
1.Hibenate是一个开放源代码的对象关系映射框架,它对JDBC进行了轻量级的对象封装,将pojo类与数据库表建立映射关系,是一个全自动orm框架,Hibenate可以自动生成sql语句,自动执行 ...
- 自动化测试-8.selenium操作元素之键盘和鼠标事件
前言 在前面的几篇中重点介绍了一些元素的定位方法,定位到元素后,接下来就是需要操作元素了.本篇总结了web页面常用的一些操作元素方法,可以统称为行为事件 有些web界面的选项菜单需要鼠标悬停在某个元素 ...
- 利用教育邮箱注册JetBrains产品(pycharm、idea等)的方法
转载:http://www.cnblogs.com/wang-meng/p/8887436.html 1,申请邮箱 地址为:http://mdu.edu.rs/ 邮箱的前缀可以改成自己喜欢的字符 ...