
NLP之TF-IDF与BM25原理探究
前言
本文主要是对TF-IDF和BM25在公式推演、发展沿革方面的演述,全文思路、图片基本来源于此篇公众号推文《搜索中的权重度量利器: TF-IDF和BM25》,侵删。
一 术语
- TF: Term Frequency,词频;衡量某个指定的词语在某份【文档】中出现的【频率】
- IDF: Inverse Document Frequency,逆文档频率;一个词语【普遍重要性】的度量。
- TF-IDF = TF*IDF
一种统计方法,用以评估一字词对于一个文件集或一个语料库中的其中一份文件的重要程度。字词的重要性随着它在文件中出现的次数成正比增加,但同时会随着它在语料库中出现的频率成反比下降。TF-IDF加权的各种形式常被搜索引擎应用,作为文件与用户查询之间相关程度的度量或评级。 -----《TF-IDF 百度百科》
TFIDF的主要思想是:如果某个词或短语在一篇文章中出现的频率TF高,并且在其他文章中很少出现,则认为此词或者短语具有很好的类别区分能力,适合用来分类。
- BM25
- 应用:BM25相关度打分,基于BM25与TextRank的单文档自动文摘(经Rouge评测,效果较为优异)
bm25 是一种用来评价搜索词和文档之间相关性的算法,它是一种基于概率检索模型提出的算法
二 TF-IDF
- <1>传统的TF-IDF
- 【TF】词汇word的词频(TF)值
\[ TF_{Score} = tf = \frac{ 指定词汇word在第i份文档documents[i]中出现的次数 }{ 文档documents[i]的长度 } \] - 【IDF】词汇word的逆文档频率(IDF)值
\[ IDF_{Score} = log( \frac{ 文档集documents的总数 }{ 指定词word在文档集documents中出现过的文档总数 } ) \] - 【TF-IDF/关联度计算】词汇word与某份文档documents[j]的关联度得分(TF-IDF)
\[ TFIDF(word | docuements ) = Similarity(word | documents ) \]
\[ Similarity(word | documents ) = TF_{Score}*IDF_{Score} \] - 短语sentence与某份文档documents[j]的关联度得分(TF-IDF)
\[ sentence = [word1,word2,...,wordi,...,wordn] \]
\[ TFIDF_{_{sentence}}(word | docuements ) = TFIDF_{_{word1}} + TFIDF_{_{word2}} + ... + TFIDF_{_{wordi}} + ... + TFIDF_{_{wordn}} \]
- 【TF】词汇word的词频(TF)值
- <2>早期Lucence版的TF-IDF
- 【TF】
\[ TF_{Score} = sqrt(tf) \] - 【IDF】
\[ IDF_{Score} = log( \frac{ 文档集documents的总数 }{ 指定词word在文档集documents中出现过的文档总数 + 1 } ) \] - 【filedNorms】fieldNorms:对文本长度的归一化(Normalization)
\[ fieldNorms = (\frac{1}{sqrt(文档documents[j]的长度)}) \] - 【TF-IDF/关联度计算】
\[ TF-IDF(word | docuements ) = Similarity(word | documents ) \]
\[ Similarity(word | documents ) = TF_{Score} * IDF_{Score} * fieldNorms \]
- 【TF】
三 BM25
下一代的TF-IDF。
新版的lucence不再把TF-IDF作为默认的相关性算法,而是采用了BM25(BM是Best Matching的意思)。BM25是基于TF-IDF并做了改进的算法。

- <3>BM25
- 【TF】传统的TF值理论上是可以无限大的。而BM25与之不同,它在TF计算方法中增加了一个常量k,用来限制TF值的增长极限。
- 早期Lucence版的TF-IDF
\[ TF_{Score} = sqrt(tf) \] - BM25的TF Score(作者默认对k取值为1.2)
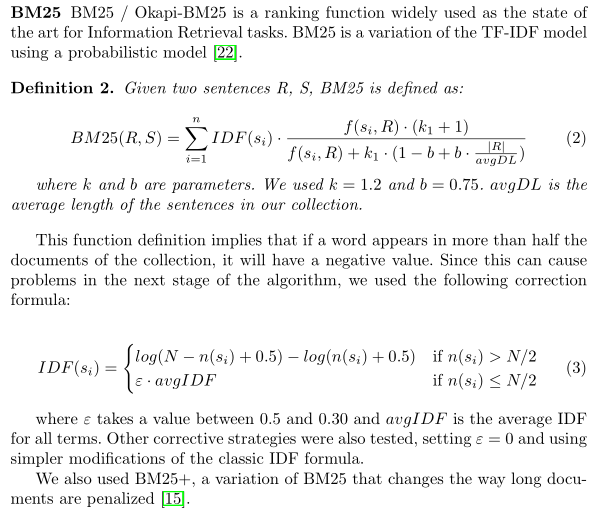
\[ TF_{Score} = \frac{ ((k + 1) * tf) }{ k + tf } \] 如何对待文档长度?(再优化)
\[ TF_{Score} = \frac{ ((k + 1) * tf) }{ k * (1.0 - b + b * L) + tf } \]BM25还引入了平均文档长度的概念,单个文档长度对相关性的影响力与它和平均长度的比值有关系。
BM25的TF公式里,除了k外,引入另外两个参数:L和b。
L是文档长度与平均长度的比值。如果文档长度是平均长度的2倍,则L=2。
b是一个常数,它的作用是规定L对评分的影响有多大。如果把b设置为0,则L完全失去对评分的影响力。b的值越大,L对总评分的影响力越大。加了L和b的公式如上所示。
- 早期Lucence版的TF-IDF
- 【IDF】
\[ IDF_{Score} = log( \frac{ 文档集documents的总数 }{ 指定词word在文档集documents中出现过的文档总数 + 1 } ) \] - 【TF-IDF/关联度计算】
\[ Similarity(word | documents ) = \frac{ IDF_{Score}*(k + 1)*tf } { k * (1.0 - b + b * \frac{|D|}{avgD_{l}}) + tf } \]
\[ L= \frac{|D|}{avgD_{l}} \]
\[ 其中,|D|系文档集documents的文档总数;avgD_{l}系文档集documents的平均文档长度(即 平均词汇数) \]
- 【TF】传统的TF值理论上是可以无限大的。而BM25与之不同,它在TF计算方法中增加了一个常量k,用来限制TF值的增长极限。
四 文献
- 参考文献
- 推荐文献
- 补充:推荐文献
《Variations of the Similarity Function of TextRank for Automated Summarization》
.important{ color:red;font-weight:bloder; }
NLP之TF-IDF与BM25原理探究的更多相关文章
- Elasticsearch由浅入深(十)搜索引擎:相关度评分 TF&IDF算法、doc value正排索引、解密query、fetch phrase原理、Bouncing Results问题、基于scoll技术滚动搜索大量数据
相关度评分 TF&IDF算法 Elasticsearch的相关度评分(relevance score)算法采用的是term frequency/inverse document frequen ...
- 基于TF/IDF的聚类算法原理
一.TF/IDF描述单个term与特定document的相关性TF(Term Frequency): 表示一个term与某个document的相关性. 公式为这个term在document中出 ...
- TF/IDF(term frequency/inverse document frequency)
TF/IDF(term frequency/inverse document frequency) 的概念被公认为信息检索中最重要的发明. 一. TF/IDF描述单个term与特定document的相 ...
- 信息检索中的TF/IDF概念与算法的解释
https://blog.csdn.net/class_brick/article/details/79135909 概念 TF-IDF(term frequency–inverse document ...
- tf idf公式及sklearn中TfidfVectorizer
在文本挖掘预处理之向量化与Hash Trick中我们讲到在文本挖掘的预处理中,向量化之后一般都伴随着TF-IDF的处理,那么什么是TF-IDF,为什么一般我们要加这一步预处理呢?这里就对TF-IDF的 ...
- [原] KVM 虚拟化原理探究(1)— overview
KVM 虚拟化原理探究- overview 标签(空格分隔): KVM 写在前面的话 本文不介绍kvm和qemu的基本安装操作,希望读者具有一定的KVM实践经验.同时希望借此系列博客,能够对KVM底层 ...
- [原] KVM 虚拟化原理探究 —— 目录
KVM 虚拟化原理探究 -- 目录 标签(空格分隔): KVM KVM 虚拟化原理探究(1)- overview KVM 虚拟化原理探究(2)- QEMU启动过程 KVM 虚拟化原理探究(3)- CP ...
- [原] KVM 虚拟化原理探究(6)— 块设备IO虚拟化
KVM 虚拟化原理探究(6)- 块设备IO虚拟化 标签(空格分隔): KVM [toc] 块设备IO虚拟化简介 上一篇文章讲到了网络IO虚拟化,作为另外一个重要的虚拟化资源,块设备IO的虚拟化也是同样 ...
- [原] KVM 虚拟化原理探究(5)— 网络IO虚拟化
KVM 虚拟化原理探究(5)- 网络IO虚拟化 标签(空格分隔): KVM IO 虚拟化简介 前面的文章介绍了KVM的启动过程,CPU虚拟化,内存虚拟化原理.作为一个完整的风诺依曼计算机系统,必然有输 ...
随机推荐
- 关于阿里云OSS上传图片之后会被旋转90度的解决办法
原文:https://www.cnblogs.com/wuhjbk/p/10133596.html 问题描述:正常的图片前端上传到oss成功之后的资源地址.在html上引用的时候被旋转了90度oss资 ...
- spring实例化一:InstantiationStrategy
DefaultListableBeanFactory对bean的管理工厂,包括bean的生成,从class到bean的实例化.spring特为这个实例化过程,定义了接口Instantiat ...
- GDI+ 实例:绘制验证码
一.概述 一般处理程序 ashx :它没有服务器控件,用response输出什么就是什么. 生成验证码原理:产生随机字符,并将字符生成为图片,同时储存到Session里去,然后验证用户输入的内容是否与 ...
- MySQL之text字段
TEXT类型一般分为 TINYTEXT(255长度).TEXT(65535). MEDIUMTEXT(int最大值16M),和LONGTEXT(long最大值4G)这四种,它被用来存储非二进制字符集, ...
- Java8-Annotations
import java.lang.annotation.ElementType; import java.lang.annotation.Repeatable; import java.lang.an ...
- Js实现table单双行交替色
依稀记得,当初我刚学编程的时候还学过怎么实现表格单双行交替色,现如今早已记不清当时的实现思路,这两天突然想起,没事就自己写了一小段代码,也不知道是否是当年的思路,不过不用纠结这个问题.:) 代码很简单 ...
- [React Native] Up & Running with React Native & TypeScript
Create a new application with Typescript: react-native init RNTypeScript --template typescript Then: ...
- HDU 6156 - Palindrome Function [ 数位DP ] | 2017 中国大学生程序设计竞赛 - 网络选拔赛
普通的数位DP计算回文串个数 /* HDU 6156 - Palindrome Function [ 数位DP ] | 2017 中国大学生程序设计竞赛 - 网络选拔赛 2-36进制下回文串个数 */ ...
- C#第一章 第一个C#程序
第一个C#程序 namespace 是C#中组织代码的方式,它的作用那个类似java中的包 using 在Java中作用如果导入其他包 应该是用import关键字而在C#中应使用using关键字来引用 ...
- dblclick([[data],fn]) 当双击元素时,会发生 dblclick 事件。
dblclick([[data],fn]) 概述 当双击元素时,会发生 dblclick 事件.大理石量具哪家好 当鼠标指针停留在元素上方,然后按下并松开鼠标左键时,就会发生一次 click.在很短的 ...