
【并行计算-CUDA开发】CUDA并行存储模型
CUDA并行存储模型
CUDA将CPU作为主机(Host),GPU作为设备(Device)。一个系统中可以有一个主机和多个设备。CPU负责逻辑性强的事务处理和串行计算,GPU专注于执行高度线程化的并行处理任务。它们拥有相互独立的存储器(主机端的内存和显卡端的显存)。
运行在GPU上的函数称为kernel(内核函数)。一个完整的CUDA程序是由一些列的kernel函数和主机端的串行处理步骤共同完成的。CPU串行代码的工作包括在kernel启动前进行的数据准备、设备初始化以及在kernel之间进行一些串行化计算。
kernel函数以函数类型限定符_global_定义,并且只能在主机端代码中调用。调用时需要制定kernel的Grid中的block数目以及每个block中thread的数目。每个线程有自己的blockID和threadID,可用来区分其它的线程,这两个内建变量是只读的,由专用寄存器提供,只能有kernel函数调用。
CUDA将计算任务映射为大量的可并行执行的线程,并由硬件动态调度和执行这些线程。kernel是以线程网格Grid的形式组织,每个Grid又若干个线程块block组成,每个block又由若干线程thread组成。本质上,kernel是以block为单位执行的,grid只是用来表示一些列并行block的集合。Block之间是不能彼此通信的。目前一个kernel只支持一个grid,在多指令多数据(MIMD)构架中会存在多个grid。
为方便编程,CUDA使用了dim3类型的内建变量threadIdx和threadIdx。
对于一维的block,线程的编号是threadIdx.x。
对于二维(Dx,Dy)的block,线程的编号是threadIdx.x+threadIdx.y * Dx。
对于三维(Dx,Dy,Dz)的block,线程的编号是threadIdx.x+threadIdx.y * Dx+hreadIdx.z* Dx * Dy。
GPU的计算核心是流多处理器(SM),每个SM包含8个标量流处理器(SP)以及其它的运算单元。Kernel是以block为单位执行的,同一个block的线程需要共享数据,因此它们共享同一个SM。一个block必须分配到一个SM,但是可以一个SM中同一个时刻有多个活动块(active block)执行等待,即同一个SM可以有多个block上下文。实际运行中,block会被分为更小的线程束(wrap),线程束的大小由硬件的计算能力决定,Tesla的构架中一个wrap由32个线程组成。
CUDA采用了单指令多线程执行模型。这个模型是对单指令多数据的改进。CUDA中执行宽度可以在1——512个线程之间变化,但是在单指令多数据中执行宽度必须是一个wrap(32)。
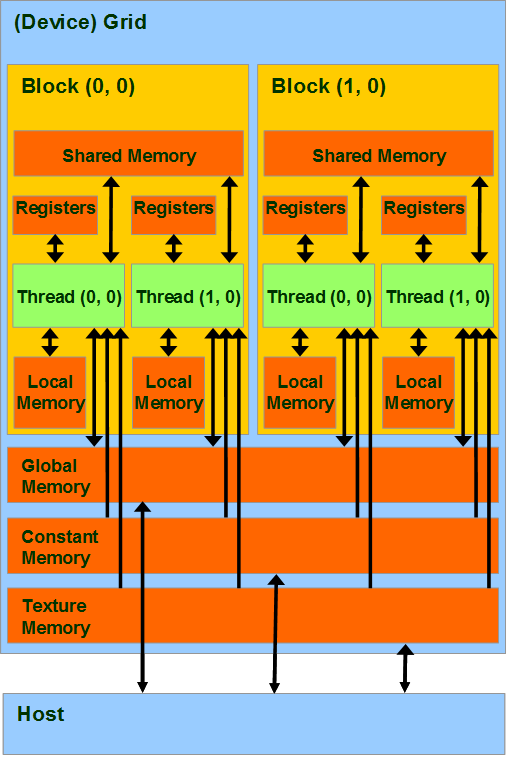
每一个线程拥有自己的私有存储器,每一个线程块拥有一块共享存储器(Shared memory);最后,grid中所有的线程都可以访问同一块全局存储器(global memory)。除此之外,还有两种可以被所有线程访问的只读存储器:常数存储器(constant
memory)和纹理存储器(Texture memory),它们分别为不同的应用进行了优化。全局存储器、常数存储器和纹理存储器中的值在一个内核函数执行完成后将被继续保持,可以被同一程序中其也内核函数调用。
|
存储器 |
位置 |
拥有缓存 |
访问权限 |
变量生存周期 |
|
register |
GPU片内 |
N/A |
Device可读/写 |
与thread相同 |
|
Local memory |
板载显存 |
无 |
Device可读/写 |
与thread相同 |
|
Shared memory |
GPU片内 |
N/A |
Device可读/写 |
与block相同 |
|
Constant memory |
板载显存 |
有 |
Device可读,host要读写 |
可在程序中保持 |
|
Texture memory |
板载显存 |
有 |
Device可读,host要读写 |
可在程序中保持 |
|
Global memory |
板载显存 |
无 |
Device可读/写, host可读/写 |
可在程序中保持 |
|
Host memory |
Host内存 |
无 |
host可读/写 |
可在程序中保持 |
|
Pinned memory |
Host内存 |
无 |
host可读/写 |
可在程序中保持 |
CUDA存储器模型:
GPU片内:register,shared memory;
板载显存:local memory,constant memory,texture memory,global memory;
host 内存: host memory, pinned memory.
register: 访问延迟极低;
基本单元:register file (32bit/each)
计算能力1.0/1.1版本硬件:8192/SM;
计算能力1.2/1.3版本硬件: 16384/SM;
每个线程占有的register有限,编程时不要为其分配过多私有变量;
local memory:寄存器被使用完毕,数据将被存储在局部存储器中;
大型结构体或者数组;
无法确定大小的数组;
线程的输入和中间变量;
定义线程私有数组的同时进行初始化的数组被分配在寄存器中;
shared memory:访问速度与寄存器相似;
实现线程间通信的延迟最小;
保存公用的计数器或者block的公用结果;
硬件1.0~1.3中,16KByte/SM,被组织为16个bank;
声明关键字 _shared_ int sdata_static[16];
global memory:存在于显存中,也称为线性内存(显存可以被定义为线性存储器或者CUDA数组);
cudaMalloc()函数分配,cudaFree()函数释放,cudaMemcpy()进行主机端与设备端的数据传输;
初始化共享存储器需要调用cudaMemset();
二维三维数组:cudaMallocPitch()和cudaMalloc3D()分配线性存储空间,可以确保分配满足对齐要求;
cudaMemcpy2D(),cudaMemcpy3D()与设备端存储器进行拷贝;
host内存:分为pageable memory 和 pinned memory
pageable memory: 通过操作系统API(malloc(),new())分配的存储器空间;
pinned memory:始终存在于物理内存中,不会被分配到低速的虚拟内存中,能够通过DMA加速与设备端进行通信;cudaHostAlloc(),
cudaFreeHost()来分配和释放pinned memory;
使用pinned memory优点:主机端-设备端的数据传输带宽高;某些设备上可以通过zero-copy功能映射到设备地址空间,从GPU直接访问,省掉主存与显存间进行数据拷贝的工作;pinned
memory 不可以分配过多:导致操作系统用于分页的物理内存变,导致系统整体性能下降;通常由哪个cpu线程分配,就只有这个线程才有访问权限;
cuda2.3版本中,pinned memory功能扩充:
portable memory:让控制不同GPU的主机端线程操作同一块portable memory,实现cpu线程间通信;
使用cudaHostAlloc()分配页锁定内存时,加上cudaHostAllocPortable标志;
write-combined Memory:提高从cpu向GPU单向传输数据的速度;不使用cpu的L1,L2
cache对一块pinned memory中的数据进行缓冲,将cache资源留给其他程序使用;在pci-e总线传输期间不会被来自cpu的监视打断;在调用cudaHostAlloc()时加上cudaHostAllocWriteCombined标志;cpu从这种存储器上读取的速度很低;
mapped memory:两个地址:主机端地址(内存地址),设备端地址(显存地址)。
可以在kernnel程序中直接访问mapped memory中的数据,不必在内存和显存之间进行数据拷贝,即zero-copy功能;在主机端可以由cudaHostAlloc()函数获得,在设备端指针可以通过cudaHostGetDevicePointer()获得;通过cudaGetDeviceProperties()函数返回的canMapHostMemory属性知道设备是否支持mapped
memory;在调用cudaHostAlloc()时加上cudaHostMapped标志,将pinned memory映射到设备地址空间;必须使用同步来保证cpu和GPu对同一块存储器操作的顺序一致性;显存中的一部分可以既是portable memory又是mapped memory;在执行CUDA操作前,先调用cudaSetDeviceFlags()(加cudaDeviceMapHost标志)进行页锁定内存映射。
constant memory:只读地址空间;位于显存,有缓存加速;64Kb;用于存储需要频繁访问的只读参数 ;只读;使用_constant_ 关键字,定义在所有函数之外;两种常数存储器的使用方法:直接在定义时初始化常数存储器;定义一个constant数组,然后使用函数进行赋值;
texture memory:只读;不是一块专门的存储器,而是牵涉到显存、两级纹理缓存、纹理拾取单元的纹理流水线;数据常以一维、二维或者三维数组的形式存储在显存中;缓存加速;可以声明大小比常数存储器大得多;适合实现图像树立和查找表;对大量数据的随机访问或非对齐访问有良好的加速效果;在kernel中访问纹理存储器的操作成为纹理拾取(texture
fetching);纹理拾取使用的坐标与数据在显存中的位置可以不同,通过纹理参照系约定二者的映射方式;将显存中的数据与纹理参照系关联的操作,称为将数据与纹理绑定(texture binding);显存中可以绑定到纹理的数据有:普通线性存储器和cuda数组;存在缓存机制;可以设定滤波模式,寻址模式等;
【并行计算-CUDA开发】CUDA并行存储模型的更多相关文章
- CUDA开发 - CUDA 版本
"CUDA runtime is insufficient with CUDA driver"CUDA 9.2: 396.xx CUDA 9.1: 387.xx CUDA 9.0: ...
- CUDA并行存储模型
CUDA将CPU作为主机(Host),GPU作为设备(Device).一个系统中可以有一个主机和多个设备.CPU负责逻辑性强的事务处理和串行计算,GPU专注于执行高度线程化的并行处理任务.它们拥有相互 ...
- 【并行计算-CUDA开发】CUDA存储器模型
CUDA存储器模型 除了执行模型以外,CUDA也规定了存储器模型(如图2所示)和一系列用于主控CPU与GPU间通信的不同地址空间.图中红色的区域表示GPU片内的高速存储器,橙色区域表示DRAM中的的地 ...
- 【CUDA开发】CUDA从入门到精通
CUDA从入门到精通(零):写在前面 在老板的要求下,本博主从2012年上高性能计算课程开始接触CUDA编程,随后将该技术应用到了实际项目中,使处理程序加速超过1K,可见基于图形显示器的并行计算对于追 ...
- Windows平台CUDA开发之前的准备工作
CUDA是NVIDIA的GPU开发工具,眼下在大规模并行计算领域有着广泛应用. windows平台上面的CUDA开发之前.最好去NVIDIA官网查看说明,然后下载对应的driver. ToolKits ...
- 【CUDA开发】CUDA编程接口(一)------一十八般武器
子曰:工欲善其事,必先利其器.我们要把显卡作为通用并行处理器来做并行算法处理,就得知道CUDA给我提供了什么样的接口,就得了解CUDA作为通用高性能计算平台上的一十八般武器.(如果你想自己开发驱动,自 ...
- 【CUDA开发】 CUDA Thrust 规约求和
1. 使用 Thrust Thrust 是一个开源的 C++ 库,用于开发高性能并行应用程序,以 C++ 标准模板库为蓝本实现. 官方文档见这里:CUDA Thrust /* ... */ float ...
- 【ARM-Linux开发】【CUDA开发】【深度学习与神经网络】Jetson Tx2安装相关之三
JetPack(Jetson SDK)是一个按需的一体化软件包,捆绑了NVIDIA®Jetson嵌入式平台的开发人员软件.JetPack 3.0包括对Jetson TX2 , Jetson TX1和J ...
- 【CUDA开发】CUDA面内存拷贝用法总结
[CUDA开发]CUDA面内存拷贝用法总结 标签(空格分隔): [CUDA开发] 主要是在调试CUDA硬解码并用D3D9或者D3D11显示的时候遇到了一些代码,如下所示: CUdeviceptr g_ ...
随机推荐
- Codeforces Round #589 (Div. 2) D. Complete Tripartite(染色)
链接: https://codeforces.com/contest/1228/problem/D 题意: You have a simple undirected graph consisting ...
- 原生JS实现拖动滑块验证登录效果
♀分享一组利用原生JS实现拖动滑块验证效果 ♀在这个组代码中涉及三个方面的知识: ⑴事件处理 ⑵添加验证标记 ⑶选择器的封装 代码如下: <!DOCTYPE html> <htm ...
- TabSheet源码
TabSheet.h #if !defined(AFX_TABSHEET_H__42EE262D_D15F_46D5_8F26_28FD049E99F4__INCLUDED_) #define AFX ...
- PHP mysqli_fetch_object() 函数
定义和用法 mysqli_fetch_object() 函数从结果集中取得当前行,并作为对象返回. 注释:该函数返回的字段名是区分大小写的. <?php // 假定数据库用户名:root,密码: ...
- BZOJ 1116 [POI2008]CLO-Toll 并查集
如果一个连通块是一个树的形态,则不合法,否则合法. 用并查集判断一下即可. #include <bits/stdc++.h> #define N 100005 #define M 2000 ...
- 【Android】查看内存
[文章来源]http://blog.csdn.net/hudashi/article/details/7050897 查看内存使用的方式有很多种,但是各个方式查看到的结果可能会有微略不同. 方式一 ...
- linux(centos7)下安装maven
Linux下安装maven 1.首先到Maven官网下载安装文件,目前最新版本为3.0.3,下载文件为apache-maven-3.0.3-bin.tar.gz,下载可以使用yum命令: 2.进入下载 ...
- 手把手教你在Linux系统下安装MySQL
在CentOS中默认安装有MariaDB,这个是MySQL的分支,但为了需要,还是要在系统中安装MySQL,而且安装完成之后可以直接覆盖掉MariaDB. 1. 下载并安装MySQL官方的 Yum R ...
- Leetcode题目96.不同的二叉搜索树(动态规划-中等)
题目描述: 给定一个整数 n,求以 1 ... n 为节点组成的二叉搜索树有多少种? 示例: 输入: 3 输出: 5 解释: 给定 n = 3, 一共有 5 种不同结构的二叉搜索树: 1 3 3 2 ...
- JS的数据储存格式
javaScript有三种数据存储方式,分别是:sessionStoragelocalStoragecookier 相同点:都保存在浏览器端,同源的 不同点:①传递方式不同cookie数据始终在同源的 ...