
大数据框架-Mapreduce过程
1、Shuffle
[从mapTask到reduceTask: Mapper -> Partitioner ->Combiner -> Sort ->Reducer]
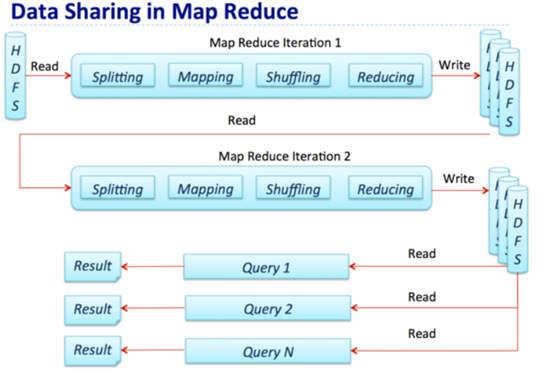
mapper对job任务进行键值对构建并写入环形内存缓冲区[缓冲区满了,map停止直到全写入磁盘],大小100MB(io.sort.mb),一旦达到0.8(io.sort.spill.percent)读入量,即将内存内容经过partitioner分区和sort排序,和combiner合并写入到磁盘一个溢写出文件目录下(mapred.local.dir)。当数据读取完成,将磁盘所有溢出文件合并成一个大文件(同样是经过分区和排序后的文件)。将映射关系提交给AppMaster。
reducer通过心跳机制到AppMaster获取映射关系,再通过Http方式得到文件分区,不同区号文件进入不同reducer,再合并排序进行reduce处理。
Mapper:输出键值对集合(函数setup、map、cleanup、run);
Partitioner:分区,并确保分区号大于或等于reducer的个数。对Mapper结果进行计算确定交给哪个reducer来计算;
Combiner:在map端执行减少传输到reducer的数据量,看作本地的reducer,实现本地key的归并;但combiner不能改变key/value的类型,适用于不影响最终结果场景(累加、最大值);
Sort:按照key值排序。
2、hadoop序列化类型(全都继承Writable)
Text:类似于java中的String
基础Writable对象(IntWritable\LongWritable\ BooleanWritable\ ByteWritable\...)
自定义序列化对象
(实现writable接口;
同时实现序列化函数write和反序列化函数readFiles,但写和读顺序和类型要一致;
重写tostring方法,否则输出结果为类全名+hascode值
需要无参构造方法)
3、MapReduce任务实现流程
Client将JAR包信息发送到RM(PRC通信)
RM返回一个jar包存储路径(固定)和一个jobID
Client对路径进行拼接,通过FileSystem将jar包写入到hdfs中(默认情况下jar包写10份)
Client再将jobID,jar包地址,其他配置发送给RM
RM将任务放入调度器(默认先进先出),NM通过心跳机制获取Mapreduce任务,在HDFS上下载JAR包,启动子进程运行任务
(1)、具体执行过程如下:

函数中主体为submit(),先进行connect(),再使用submitter进行任务调度。
A.
初始化Job持有的cluster对象引用(cluster引用中持有ClientProtocol对象引用)。
Ps: ClientProtocol:RPCserver的代理对象,也可以理解为RM进程对象)。定义了客户端与nameNode间的接口,客户端对文件系统的所有操作都需要通过这个接口,同时客户端读、写文件等操作也需要先通过这个接口与NamenodeRPC通信后后,再进行数据块的读出和写入操作。
B.
通过提交器提交job任务,返回一个PATH
也返回一个Job的ID
拼接上述PATH和JobID
将jar包信息拷贝到HDFS中 job信息,存放job地址和副本数量
提交到服务端RM jobid、jar包地址,其他配置信息,通过RPC通信
大数据框架-Mapreduce过程的更多相关文章
- 大数据框架对比:Hadoop、Storm、Samza、Spark和Flink
转自:https://www.cnblogs.com/reed/p/7730329.html 今天看到一篇讲得比较清晰的框架对比,这几个框架的选择对于初学分布式运算的人来说确实有点迷茫,相信看完这篇文 ...
- 大数据框架:Spark vs Hadoop vs Storm
大数据时代,TB级甚至PB级数据已经超过单机尺度的数据处理,分布式处理系统应运而生. 知识预热 「专治不明觉厉」之“大数据”: 大数据生态圈及其技术栈: 关于大数据的四大特征(4V) 海量的数据规模( ...
- 大数据框架对比:Hadoop、Storm、Samza、Spark和Flink——flink支持SQL,待看
简介 大数据是收集.整理.处理大容量数据集,并从中获得见解所需的非传统战略和技术的总称.虽然处理数据所需的计算能力或存储容量早已超过一台计算机的上限,但这种计算类型的普遍性.规模,以及价值在最近几年才 ...
- YARN之上的大数据框架REEF:微软出品,是否值得期待?
YARN之上的大数据框架REEF:微软出品,是否值得期待? 摘要:微软即将开源大数据框架REEF,REEF运行于Hadoop新一代资源管理器YARN的上层.对于机器学习等在数据传输.任务监控和结果 ...
- 老李分享:大数据框架Hadoop和Spark的异同 1
老李分享:大数据框架Hadoop和Spark的异同 poptest是国内唯一一家培养测试开发工程师的培训机构,以学员能胜任自动化测试,性能测试,测试工具开发等工作为目标.如果对课程感兴趣,请大家咨 ...
- 老李分享:大数据框架Hadoop和Spark的异同
poptest是国内唯一一家培养测试开发工程师的培训机构,以学员能胜任自动化测试,性能测试,测试工具开发等工作为目标.如果对课程感兴趣,请大家咨询qq:908821478,咨询电话010-845052 ...
- 【机器学习实战】第15章 大数据与MapReduce
第15章 大数据与MapReduce 大数据 概述 大数据: 收集到的数据已经远远超出了我们的处理能力. 大数据 场景 假如你为一家网络购物商店工作,很多用户访问该网站,其中有些人会购买商品,有些人则 ...
- [转载] 2 分钟读懂大数据框架 Hadoop 和 Spark 的异同
转载自https://www.oschina.net/news/73939/hadoop-spark-%20difference 谈到大数据,相信大家对Hadoop和Apache Spark这两个名字 ...
- 2分钟读懂大数据框架Hadoop和Spark的异同
转自:https://www.cnblogs.com/reed/p/7730313.html 谈到大数据,相信大家对Hadoop和Apache Spark这两个名字并不陌生.但我们往往对它们的理解只是 ...
随机推荐
- mysql数据库详解
001 数据库应用系统设计 1.规划 2.需求分析 3.概念模型设计 4.逻辑设计 5.物理设计 6.程序编制及调试 7.运行及维护. 002 创建数据库 CREATE DAT ...
- db缓存设计
http://www.cnblogs.com/herm/archive/2012/11/11/2773887.html
- 最新版PMBOK项目管理的五大过程组和十大知识领域
PMBOK五大过程组是:启动过程.规划过程.执行过程.监控过程.收尾过程. 各用一句话概括项目管理知识体系五大过程组: 1.启动过程组:作用是设定项目目标,让项目团队有事可做: 2.规划过程组:作用是 ...
- javascript检查数据中是否存在相同的元素
这里是两个用于数组中查找重复元素的demo,可以看看啦 <!DOCTYPE html><html lang="en"><head> <me ...
- es6 class类实例、静态、私有方法属性笔记
实例属性.方法 class Foo { valueA = 100 //第一种实例属性定义,位置:new的实例上 constructor() { this.valueB = 200 //第二种实例属性定 ...
- js小数转分数-近似递归
精度为小数两位,提高精度可把 toFixed(2)和100同时修改: function decimalsToFractional(decimals){ const formatDecimals = d ...
- [ZOJ1015]:Fishing Net
题面 Vjudge Sol 给出一个n个点的无向图,询问是否为弦图 做法见上上上篇博客 # include <bits/stdc++.h> # define RG register # d ...
- Python-约束和异常处理
今天我们来说一说类的规范以及程序出现错误后我们要怎么进行处理 一.类的约束 首先,你要清楚,约束是对类的约束,比如,现在你是一个项目经理,然后呢,你给手下的人分活,张三你处理一下普通用户登录,李四你处 ...
- 如何对MySQL数据库中的数据进行实时同步
- 一、CSS实现横列布局的方法总结
一.使用float实现横列布局的方法 如下面所示:DIV1和DIV2都可以选择向左或者向右浮动50%来实现展示在同一行 div1 div2 实现下面图片中布局的css样式如下: 分析: 1.第一行第一 ...