
(数据科学学习手札92)利用query()与eval()优化pandas代码
本文示例代码已上传至我的
Github仓库https://github.com/CNFeffery/DataScienceStudyNotes
1 简介
利用pandas进行数据分析的过程,不仅仅是计算出结果那么简单,很多初学者喜欢在计算过程中创建一堆命名随心所欲的中间变量,一方面使得代码读起来费劲,另一方面越多的不必要的中间变量意味着越高的内存占用,越多的计算资源消耗。
因此很多时候为了提升整个数据分析工作流的执行效率以及代码的简洁性,需要配合一些pandas中的高级特性。本文就将带大家学习如何在pandas中化繁为简,利用query()和eval()来实现高效简洁的数据查询与运算。
 图1
2 基于query()的高效查询
query()顾名思义,是pandas中专门执行数据查询的API,其实早在2014年,pandas0.13版本中这个特性就已经出现了,随着后续众多版本的迭代更新,目前pandas中的query()已经进化得非常好用(笔者目前使用的pandas版本为1.1.0)。
首先从一个实际例子认识一下query()的用法,这里我们使用到netflix电影与剧集发行数据集,包含了6234个作品的基本属性信息,你可以在文章开头的Github仓库对应目录下找到它。
 图2
正常读入数据后,我们分别使用传统方法和query()来执行这样的组合条件查询,不同的条件之间用对应的and or或& |连接均可:
找出类型为TV Show且国家不含美国的Kids' TV
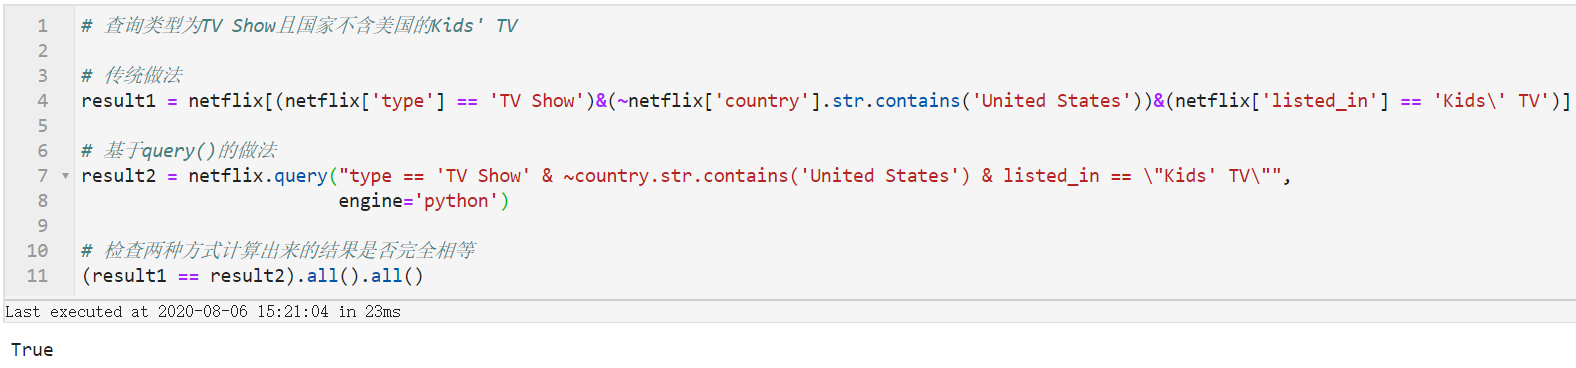 图3
通过比较可以发现在使用query()时我们在不需要重复书写数据框名称[字段名]这样的内容,字段名也直接可以当作变量使用,而且不同条件之间不需要用括号隔开,在条件繁杂的时候简化代码的效果更为明显。
通过上面的小例子我们认识到query()的强大之处,下面我们就来学习query()的常用特性:
2.1 直接解析字段名
query()最核心的特性就是可以直接根据传入的查询表达式,将字段名解析为对应的列,其中对字段名的命名规范有一定要求:当字段名符合Python中对变量命名规范的要求时,即变量名完全由字母、数字、下划线构成且不以数字开头,这样的字段是可以直接写入query()表达式的。
但大家如果尝试过会发现一些不符合上述规范的变量名也不报错,譬如:
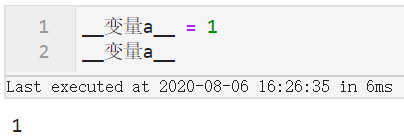 图4
因此可以记住只要在Python里作为变量名不报错,就可以直接填入字段名,否则需要在字段名两边加上`,譬如下面的例子:
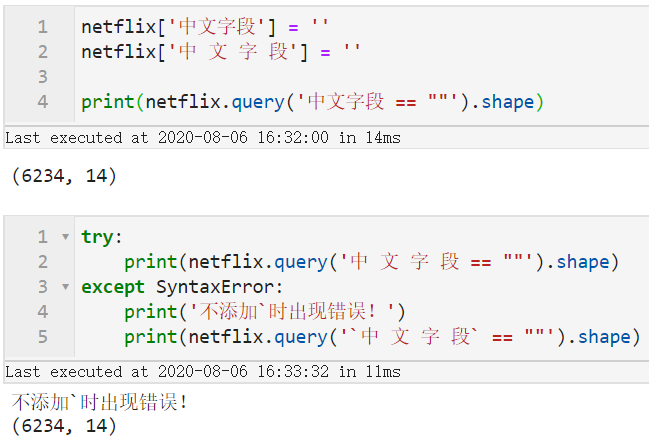 图5
2.2 链式表达式
query()中还支持链式表达式(chained expressions),使得我们可以进一步简化多条件组合时的语法:
demo = pd.DataFrame({

    'a': [5, 4, 3, 2, 1],

    'b': [1, 2, 3, 4, 5]

})

demo.query("a <= b != 4")
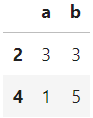 图6
2.3 支持in与not in判断
query()支持Python原生的in判断以及not in判断,从而简化了多条件判断,比如我们针对netflix数据集想找出release_year等于2018或2019的作品:
netflix.query("release_year in [2018, 2019]")
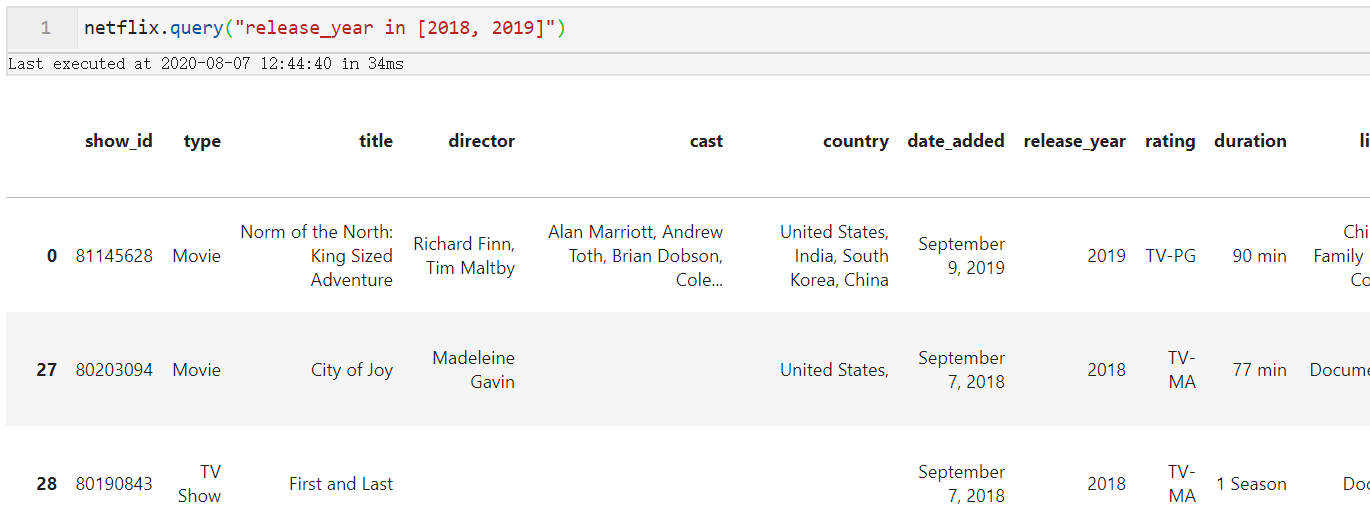 图7
2.4 对外部变量的支持
query()表达式还支持使用外部变量,只需要在外部变量前加上@符号即可:
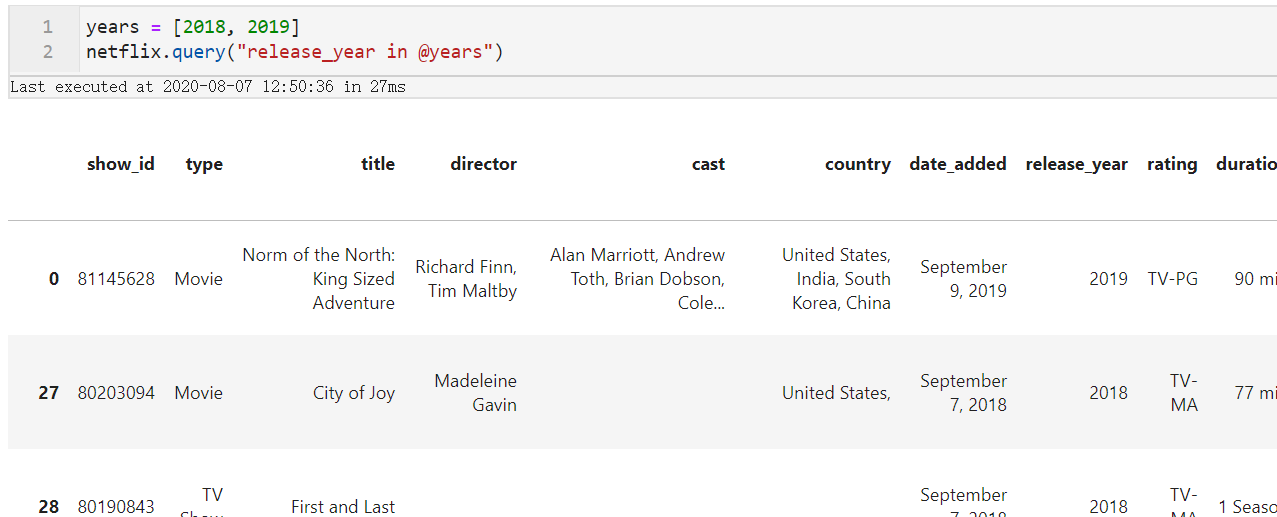 图8
2.5 对常规语句的支持
query()我个人觉得最惊人的功能就是其可以直接解析Python语句,这赋予我们极大的自由度:
def country_count(s):

    '''

    计算涉及国家数量

    '''

    return s.split(',').__len__()

# 找出发行年份在2018或2019年且合作国家数量超过5个的剧集

netflix.query("release_year.isin([2018, 2019]) and country.apply(@country_count) > 5")
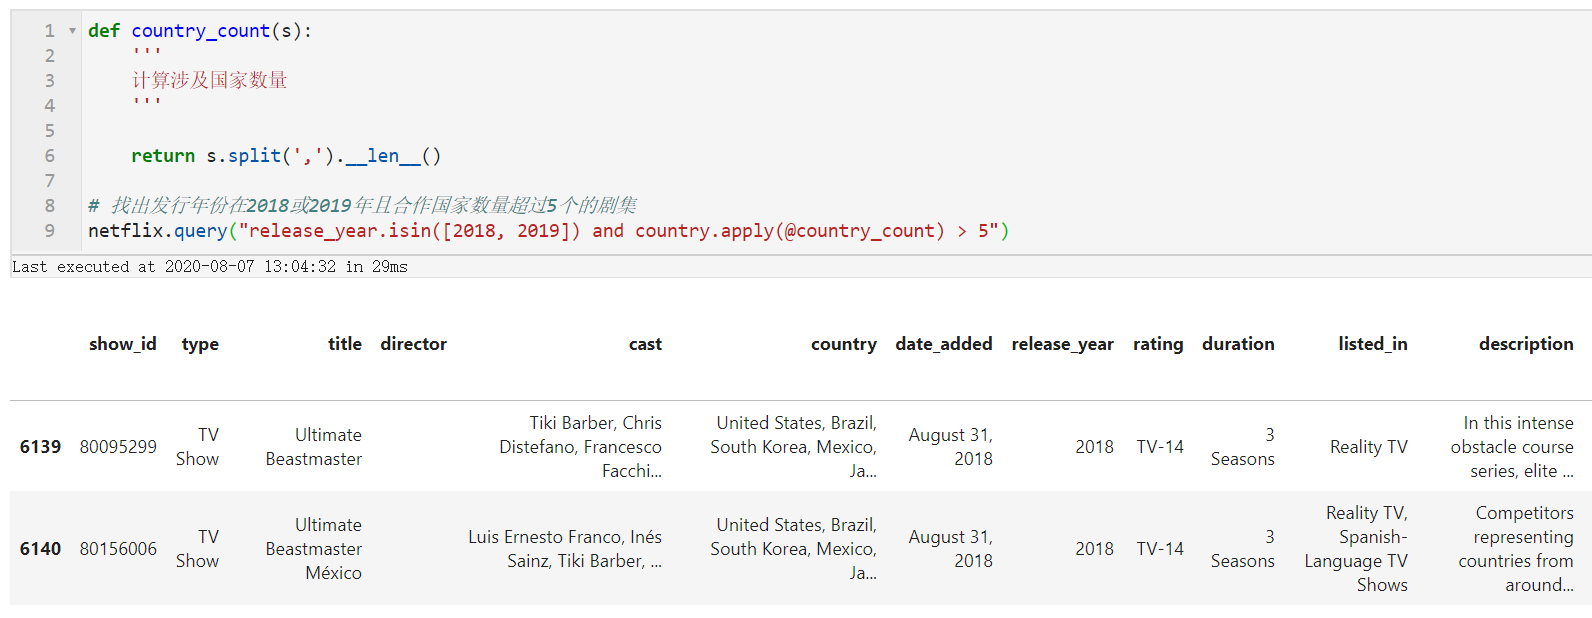 图9
2.6 对Index与MultiIndex的支持
除了对常规字段进行条件筛选,query()还支持对数据框自身的index进行条件筛选,具体可分为三种情况:
- 常规index
对于只具有单列Index的数据框,直接在表达式中使用index:
# 找出索引列中包含king的记录,忽略大小写

netflix.set_index('title').query("index.str.contains('king', case=False)")
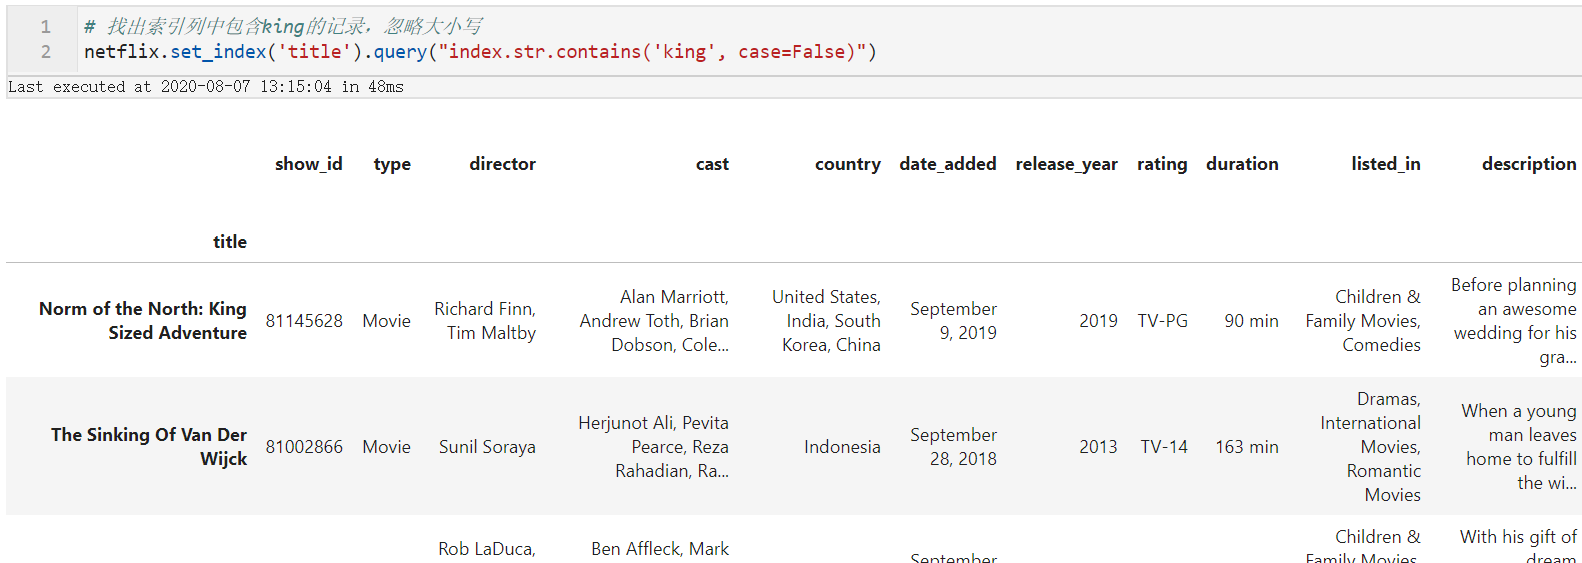 图10
- names为空的MultiIndex
对于MultiIndex的情况,可分为两种,首先我们来看看MultiIndex的names为空的情况,按照顺序,用ilevel_n表示MultiIndex中的第n列index:
# 构造含有MultiIndex的数据框,并重置index的names为None

temp = netflix.set_index(['title', 'type']);temp.index.names = (None, None)

# 找出第一个index包含king(忽略大小写),第二个index等于Movie的记录

temp.query("ilevel_0.str.contains('king', case=False) and ilevel_1 == 'Movie'")
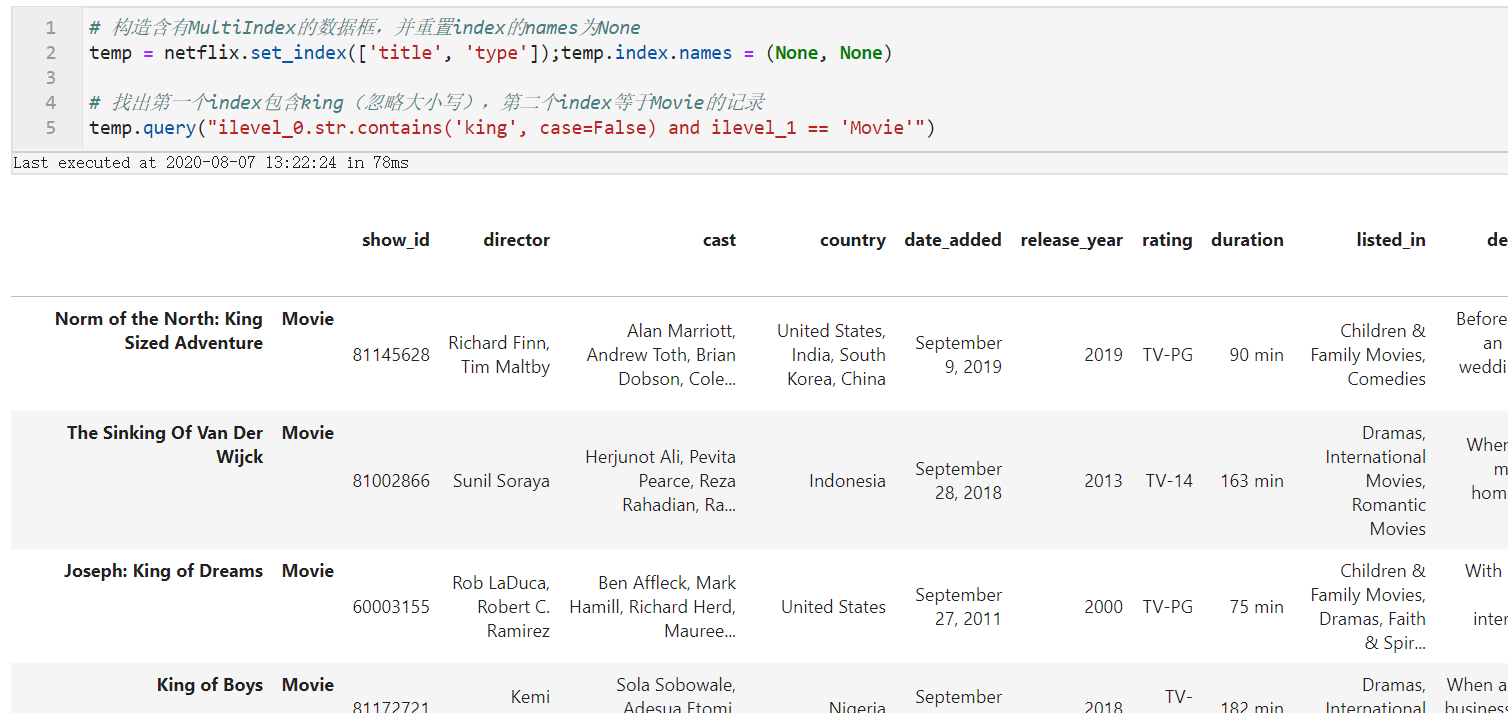 图11
- names不为空的MultiIndex
而对于MultiIndex的names有内容的情况,直接用对应的名称传入表达式即可:
# 构造含有MultiIndex的数据框,并重置index的names为None

temp = netflix.set_index(['title', 'type'])

# 找出第一个index包含king(忽略大小写),第二个index等于Movie的记录

temp.query("title.str.contains('king', case=False) and type == 'Movie'")
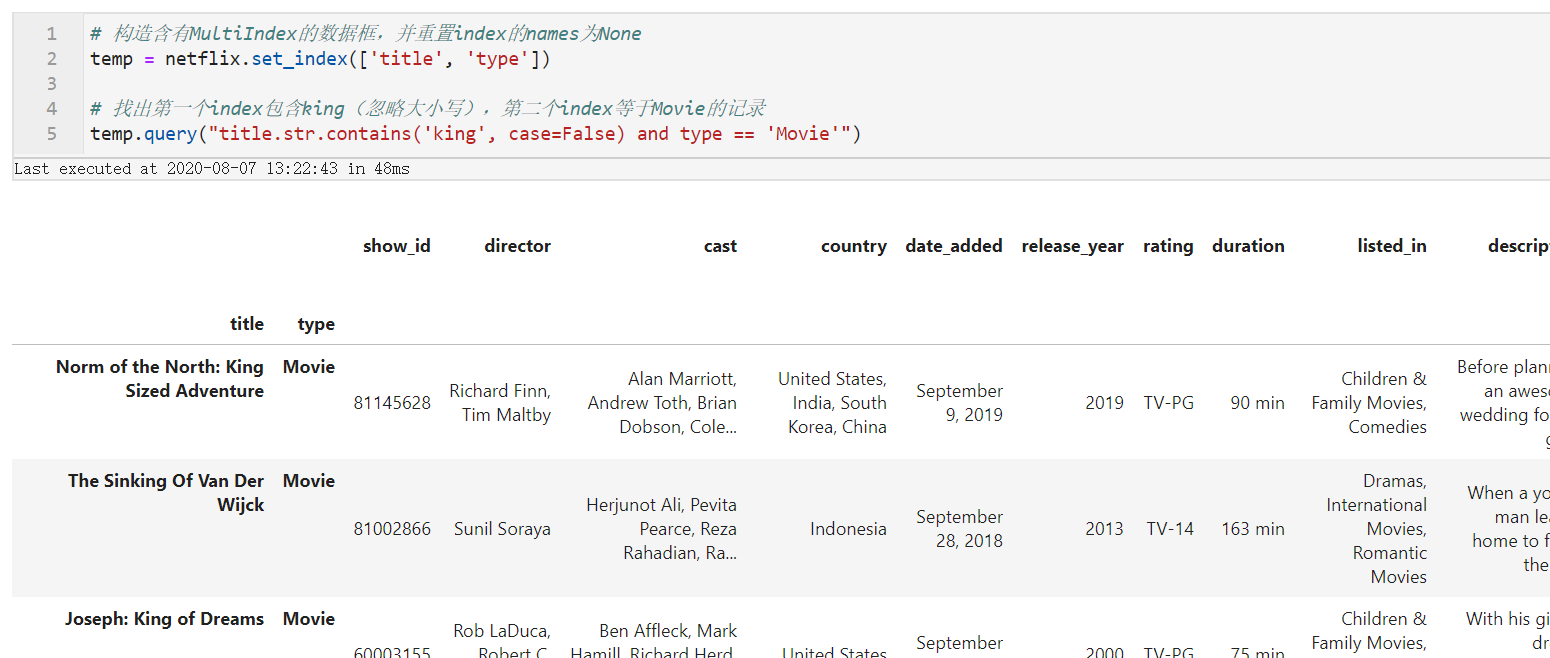 图12
3 基于eval()的高效运算
而eval()类似Python的eval()函数,可以将字符串形式的命令直接解析并执行。
而pandas中的eval()有两种,一种是top-level级别的eval()函数,而另一种是针对数据框的DataFrame.eval(),我们接下来要介绍的是后者,其与query()有很多相同之处,下面只介绍其独有特点。
同样从实际例子出发,同样针对netflix数据,我们按照一定的计算方法为其新增两列数据,对基于assign()的方式和基于eval()的方式进行比较,其中最后一列是False是因为日期转换使用coerce策略之后无法被解析的日期会填充pd.NAT,而缺失值之间是无法进行相等比较的:
# 利用assign进行新增字段计算并保存为新数据框

result1 = netflix.assign(years_to_now=2020 - netflix['release_year'],

                         new_date_added=pd.to_datetime(netflix['date_added'].str.strip(),

                                                       format='%B %d, %Y', errors='coerce'))

# 利用eval()进行新增字段计算并保存为新数据框

result2 = netflix.eval('''

                       years_to_now = 2020 - release_year

                       new_date_added = @pd.to_datetime(date_added.str.strip(), format='%B %d, %Y', errors='coerce')''')

(result1 == result2).all()
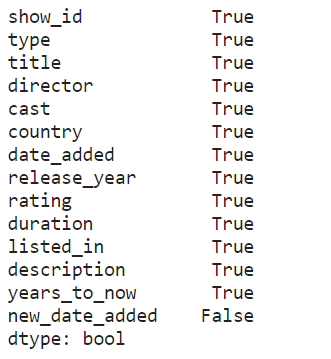 图13
虽然assign()已经算是pandas中简化代码的很好用的API了,但面对eval(),还是逊色不少
DataFrame.eval()通过传入多行表达式,每行作为独立的赋值语句,其中对应前面数据框中数据字段可以像query()一样直接书写字段名,亦可像query()那样直接执行Python语句。
但要注意的是eval()中每个新字段的赋值必须写在同一行,否则会出错:
netflix.eval('''

             years_to_now = 2020 - release_year

             new_date_added = @pd.to_datetime(date_added.str.strip(),

                                              format='%B %d, %Y',

                                              errors='coerce')''')
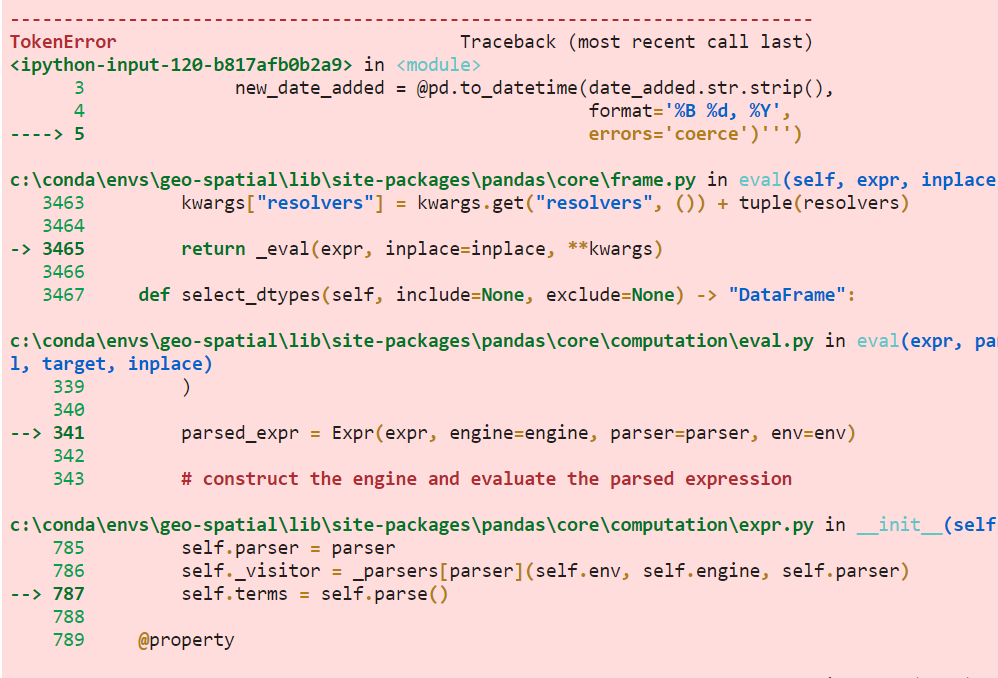 图14
因此如果你要使用到的函数参数很多,可以利用functools中的partial将一些参数固化并保存,从而达到简化eval()表达式的目的:
from functools import partial

# 利用partial固化指定参数

func = partial(pd.to_datetime, format='%B %d, %Y', errors='coerce')

netflix.eval('''

             years_to_now = 2020 - release_year

             new_date_added = @func(date_added.str.strip())''')
而我最喜欢DataFrame.eval()的地方在于配合他,我可以在很多数据分析场景中实现0中间变量,一直链式下去,延续上面的例子,当我们新增了这两列数据之后,接下来我们按顺序进行按月统计影片数量、字段重命名、新增当月数量在全部记录排名字段、排序,其中关键的是新增当月数量在全部记录排名字段,如果不用eval(),你是无法在不创建中间变量的前提下如此简洁地完成需求的:
netflix.eval('''

             years_to_now = 2020 - release_year

             new_date_added = @func(date_added.str.strip())''') \

       .resample('M', on='new_date_added') \

       .agg({'new_date_added': 'count'}) \

       .rename(columns={'new_date_added': '月度发行数量'}) \

       .eval('''月度发行数量排名 = 月度发行数量.rank(ascending=False).astype('int')''') \

       .sort_values('月度发行数量排名')
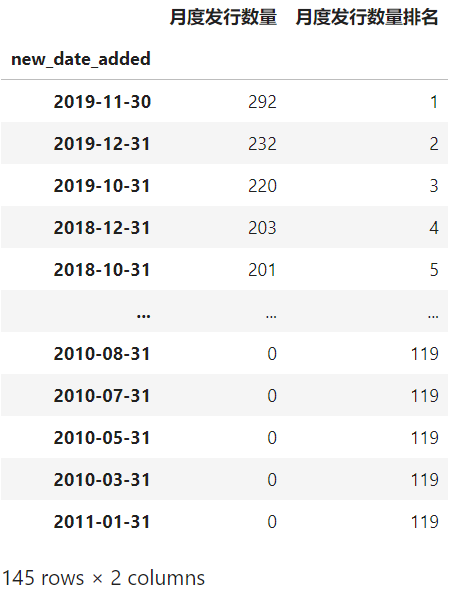 图15
使用query()+eval(),升华pandas数据分析操作。
以上就是本文的全部内容,欢迎在评论区与我讨论~
(数据科学学习手札92)利用query()与eval()优化pandas代码的更多相关文章
- (数据科学学习手札86)全平台支持的pandas运算加速神器
本文示例代码已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 随着其功能的不断优化与扩充,pandas已然成为 ...
- (数据科学学习手札55)利用ggthemr来美化ggplot2图像
一.简介 R中的ggplot2是一个非常强大灵活的数据可视化包,熟悉其绘图规则后便可以自由地生成各种可视化图像,但其默认的色彩和样式在很多时候难免有些过于朴素,本文将要介绍的ggthemr包专门针对原 ...
- (数据科学学习手札50)基于Python的网络数据采集-selenium篇(上)
一.简介 接着几个月之前的(数据科学学习手札31)基于Python的网络数据采集(初级篇),在那篇文章中,我们介绍了关于网络爬虫的基础知识(基本的请求库,基本的解析库,CSS,正则表达式等),在那篇文 ...
- (数据科学学习手札47)基于Python的网络数据采集实战(2)
一.简介 马上大四了,最近在暑期实习,在数据挖掘的主业之外,也帮助同事做了很多网络数据采集的内容,接下来的数篇文章就将一一罗列出来,来续写几个月前开的这个网络数据采集实战的坑. 二.马蜂窝评论数据采集 ...
- (数据科学学习手札44)在Keras中训练多层感知机
一.简介 Keras是有着自主的一套前端控制语法,后端基于tensorflow和theano的深度学习框架,因为其搭建神经网络简单快捷明了的语法风格,可以帮助使用者更快捷的搭建自己的神经网络,堪称深度 ...
- (数据科学学习手札42)folium进阶内容介绍
一.简介 在上一篇(数据科学学习手札41)中我们了解了folium的基础内容,实际上folium在地理信息可视化上的真正过人之处在于其绘制图像的高度可定制化上,本文就将基于folium官方文档中的一些 ...
- (数据科学学习手札40)tensorflow实现LSTM时间序列预测
一.简介 上一篇中我们较为详细地铺垫了关于RNN及其变种LSTM的一些基本知识,也提到了LSTM在时间序列预测上优越的性能,本篇就将对如何利用tensorflow,在实际时间序列预测任务中搭建模型来完 ...
- (数据科学学习手札36)tensorflow实现MLP
一.简介 我们在前面的数据科学学习手札34中也介绍过,作为最典型的神经网络,多层感知机(MLP)结构简单且规则,并且在隐层设计的足够完善时,可以拟合任意连续函数,而除了利用前面介绍的sklearn.n ...
- (数据科学学习手札32)Python中re模块的详细介绍
一.简介 关于正则表达式,我在前一篇(数据科学学习手札31)中已经做了详细介绍,本篇将对Python中自带模块re的常用功能进行总结: re作为Python中专为正则表达式相关功能做出支持的模块,提供 ...
随机推荐
- bzoj4395[Usaco2015 dec]Switching on the Lights*
bzoj4395[Usaco2015 dec]Switching on the Lights 题意: n*n个房间,奶牛初始在(1,1),且只能在亮的房间里活动.每当奶牛经过一个房间,就可以打开这个房 ...
- Python | Python初学者的自我修养,找到自己的方向
本文始发于个人公众号:TechFlow,原创不易,求个关注 今天是Python专题的第21篇文章,我们继续多线程的话题. 上周的文章当中我们简单介绍了线程和进程的概念,以及在Python当中如何在主线 ...
- 【NET开发】图片处理类-仿照七牛云图片处理功能
介绍 Sop.Common.Img **请看 七牛云的图片处理功能介绍文档了解本项目功能 ** 此项目是有https://github.com/Sopcce/.Net-Common-Utility中的 ...
- 浅谈服务治理、微服务与Service Mesh(三) Service Mesh与Serverless
作为本系列文章的第三篇(前两篇<浅谈服务治理.微服务与Service Mesh(一)Dubbo的前世今生>,<浅谈服务治理.微服务与Service Mesh(二) Spring Cl ...
- day10:函数的实参&形参
函数的参数 (参数:配合函数运算的值)参数: (1)形参:形式参数,在函数的定义处 (2)实参:实际参数,在函数的调用处 形参: 普通形参(位置) , 默认形参 , 普通收集形参 ...
- CENTOS下搭建git代码仓库 ssh协议
centos服务器下搭建git仓库,使用ssh协议管理仓库代码权限 git官网(http://git-scm.com/) 使用ssh协议: 一.安装git,使用yum install git 或 ...
- NoSQL数据库-MongoDB 学习(一)
基本介绍 MongoDB 是为了快速开发互联网 Web 应用而设计的数据库系统 MongoDB 的设计目标是极简.灵活.作为 Web 应用栈的一部分 MongoDB 的数据模型是面向文档的,所谓文档是 ...
- Python基础学习之环境搭建
Python如今成为零基础编程爱好者的首选学习语言,这和Python语言自身的强大功能和简单易学是分不开的.今天我们将带领Python零基础的初学者完成入门的第一步——环境搭建.本文会先来区分几个在P ...
- 我把JVM的类加载器整理了一下
前言 之前去面试的时候面试官问了我关于关于JVM性能调优的问题,由于自己之前公司的项目里自己没有接触到JVM性能调优的相关问题(感觉这些都是公司架构师考虑的问题),所有面试官问的时候自己一脸懵逼, ...
- 前端学习(九):CSS基础
进击のpython ***** 前端学习--CSS基础 CSS的样式可以写在哪呢?其实CSS的样式插入式十分灵活的 按照插入的形势来看,可以分为三种情况 而接下来就对这三种情况进行简单的讨论 内嵌式 ...